聊聊可信AI技术:那些藏在算法背后的"安全锁"
前阵子帮朋友做AI创业项目的合规评审,翻了三天的材料,最大的感受是——之前大家拼精度拼速度,现在拼的是谁的AI更可信。
真的,变化太快了。
放在五年前,没人会把“可信”两个字挂在嘴边,能跑通能用就行,谁管那么多。现在呢?大模型到处落地,AI进了银行批贷款,进了医院帮读片,进了政务办业务,错一次,就是灭顶之灾。
 大模型AI幻觉错误输出案例
更何况现在监管越来越严,《生成式人工智能服务管理暂行办法》出来之后,所有上线的AI都得合规,合规最核心的要求就是可信。
你不能偷用户隐私,你不能生成有害内容,你不能带着偏见歧视人,这些不是加分项,是入场券。
没有可信,你技术再好,也拿不到入场券。对吧?
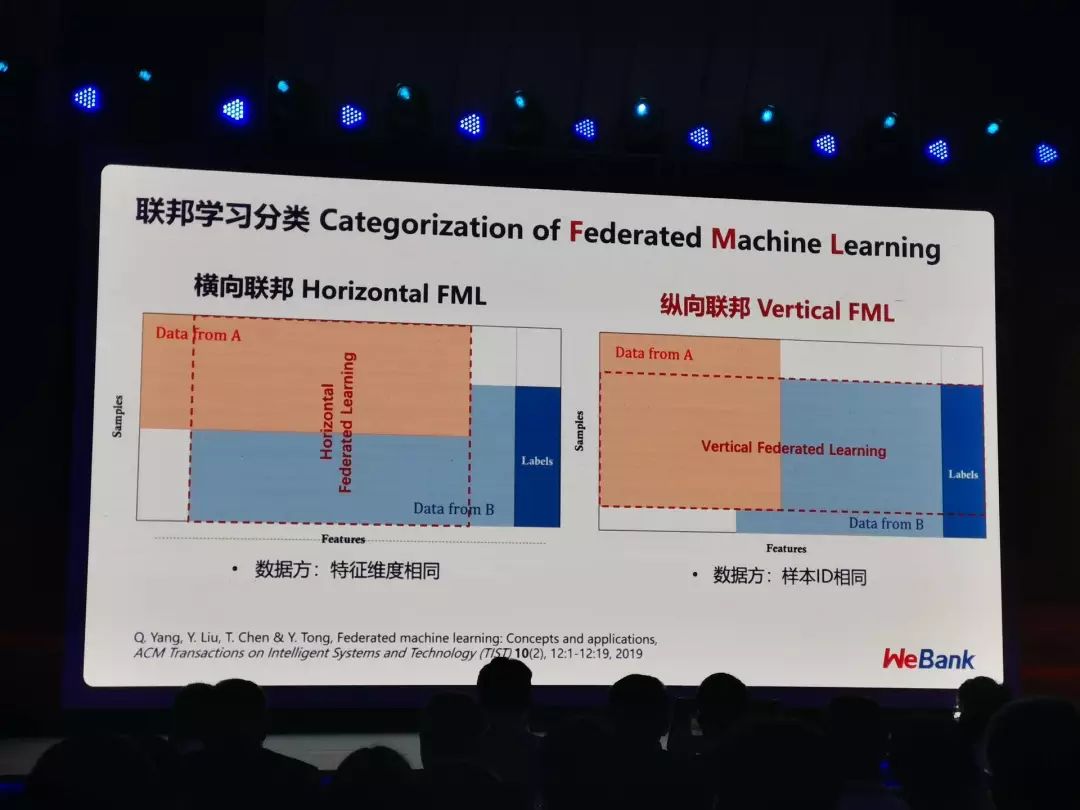 横向联邦学习可信AI架构图
第三个方向就是鲁棒性与对齐技术。
鲁棒性是防什么的?防恶意攻击。比如有人给身份证照片改了几个像素,肉眼根本看不出来,AI就把这个人认成另一个了,要是用在门禁安检上,那不出事了吗?鲁棒性技术就是训练AI,哪怕输入被改了一点,也能出正确的结果。
对齐技术主要是针对大模型的,就是让大模型的输出符合人类的价值观和规则,别动不动就被用户“越狱”,生成有害内容,别瞎编东西。
不过话说回来,现在很多技术都还在试点阶段,真的完全落地的,也就金融政务这些对合规要求特别高的行业,大部分场景还在摸索。
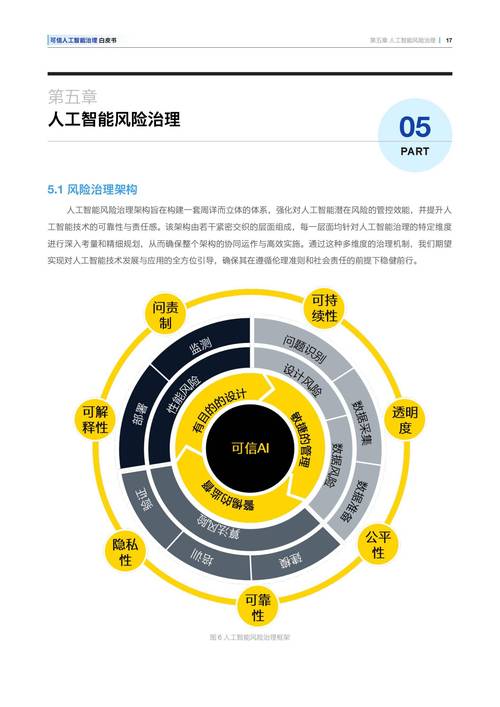 可信AI接下来要过哪几道坎?
我接触过不少做可信AI的团队,有科研院所的,也有创业公司的,大家都有共识,现在可信AI不是没有技术,是要落地还有好几道坎要跨。
第一道坎就是成本。
你加一套可信AI的技术流程,比如隐私计算,通信成本、计算成本比原来高个30%到50%都是常事,有的甚至翻一倍。大厂不差钱,能扛,中小企业呢?一个做小场景AI的创业公司,本来利润就薄,加这么多成本,根本扛不住。
什么时候能把可信技术的成本降下来,才能真正普及开,不然就只是大厂的玩具。
第二道坎就是统一标准。
现在各个行业都有自己的可信要求,金融一套,医疗一套,互联网又是一套,国标出来了,但行业细则还没跟上,很多创业公司做项目,给这个客户做一套适配,给那个客户做另一套,折腾来折腾去,大半精力都花在适配标准上了,根本没工夫磨技术。
第三道坎就是心态。
说实话,现在很多企业做可信AI,就是为了拿资质,凑合规,做做样子给监管看。训练数据还是乱爬,侵权了就甩锅给AI,出了问题就说“AI都是这样的”。
这种假可信,骗得了一时,骗不了长久。之前有个做AI简历筛选的公司,就是给资质做了包装,结果上线半年又曝出歧视问题,直接凉凉。
可信AI,核心是“可信”两个字,不是给别人看的报告,也不是拿出来吹的概念,是真真正正给用户兜底的东西。你得对自己的AI输出负责,得保护用户的隐私,得做到公平无偏见,这才叫真的可信。
我上周参加一个行业沙龙,有个院士说,未来所有的AI都得是可信AI。我当时挺认同的。
用户用你的AI,首先得信你,才敢用你。你连让人信都做不到,技术再牛有什么用?
之前行业跑得太快,把最基本的底线给落下了。现在捡起来,不丢人。反而,谁先把可信这件事做实了,谁才能拿到下一张船票。
为什么“可信”突然成了AI的命门?
去年见过一个挺可惜的创业项目,做企业招聘AI筛选,模型精度比同行高8个点,结果上线三个月就被叫停——因为人们发现,AI会无意识给男性候选人打更高分,女性哪怕条件一样,得分也低一截。 性别偏见藏在训练数据里,创业者自己都没发现。等到出了投诉,赔了钱,项目直接黄了。 这样的例子太多了。大模型天天被人说“幻觉”,今天编个不存在的论文,明天瞎造一个法条,律师敢用它写辩护词吗?法院敢用它判案吗? 之前AI应用范围小,出问题影响的也就几十上百人,现在动则千万级用户,你AI出个错,全平台跟着遭殃。大模型AI幻觉错误输出案例
更何况现在监管越来越严,《生成式人工智能服务管理暂行办法》出来之后,所有上线的AI都得合规,合规最核心的要求就是可信。
你不能偷用户隐私,你不能生成有害内容,你不能带着偏见歧视人,这些不是加分项,是入场券。
没有可信,你技术再好,也拿不到入场券。对吧?
现在主流的可信AI技术,到底在解决什么问题?
很多人一听到“可信AI技术”,就觉得是虚头巴脑的概念,其实不是,都是冲着具体问题去的。 我梳理下来,目前落地最多的就是三个方向,每个都戳在痛点上。 第一个就是可解释性技术。 说白了就是打破AI黑盒。之前AI出结果,只告诉你“我觉得这个人应该拒贷”,不说为什么。现在不行了,监管要求你必须说清楚,哪几个因素导致了这个结果,是征信逾期,还是收入不够,还是负债太高。 现在常用的比如特征归因法,能把每个输入特征对输出结果的影响算出来,给用户摆得明明白白,不是AI瞎蒙的。当然说实话,千亿参数的大模型要全链路解释,现在还做不到,也就只能做到局部解释,但总比全黑盒强太多了。 第二个方向就是隐私保护类可信AI技术。 这个不用我多说吧?之前AI训练要拿数据,很多都是偷偷爬的,用户隐私全漏了,现在有了隐私计算,比如联邦学习、差分隐私,就能做到“数据可用不可见”。 举个例子,两家银行要一起训练一个反欺诈模型,不用把自己用户的原始数据交给对方,大家各自在本地训练,只交换模型梯度参数,最后出来的模型效果和一起训练差不多,还没人能拿到对方的原始数据。这不就可信了吗?横向联邦学习可信AI架构图
第三个方向就是鲁棒性与对齐技术。
鲁棒性是防什么的?防恶意攻击。比如有人给身份证照片改了几个像素,肉眼根本看不出来,AI就把这个人认成另一个了,要是用在门禁安检上,那不出事了吗?鲁棒性技术就是训练AI,哪怕输入被改了一点,也能出正确的结果。
对齐技术主要是针对大模型的,就是让大模型的输出符合人类的价值观和规则,别动不动就被用户“越狱”,生成有害内容,别瞎编东西。
不过话说回来,现在很多技术都还在试点阶段,真的完全落地的,也就金融政务这些对合规要求特别高的行业,大部分场景还在摸索。
可信AI接下来要过哪几道坎?
可信AI接下来要过哪几道坎?
我接触过不少做可信AI的团队,有科研院所的,也有创业公司的,大家都有共识,现在可信AI不是没有技术,是要落地还有好几道坎要跨。
第一道坎就是成本。
你加一套可信AI的技术流程,比如隐私计算,通信成本、计算成本比原来高个30%到50%都是常事,有的甚至翻一倍。大厂不差钱,能扛,中小企业呢?一个做小场景AI的创业公司,本来利润就薄,加这么多成本,根本扛不住。
什么时候能把可信技术的成本降下来,才能真正普及开,不然就只是大厂的玩具。
第二道坎就是统一标准。
现在各个行业都有自己的可信要求,金融一套,医疗一套,互联网又是一套,国标出来了,但行业细则还没跟上,很多创业公司做项目,给这个客户做一套适配,给那个客户做另一套,折腾来折腾去,大半精力都花在适配标准上了,根本没工夫磨技术。
第三道坎就是心态。
说实话,现在很多企业做可信AI,就是为了拿资质,凑合规,做做样子给监管看。训练数据还是乱爬,侵权了就甩锅给AI,出了问题就说“AI都是这样的”。
这种假可信,骗得了一时,骗不了长久。之前有个做AI简历筛选的公司,就是给资质做了包装,结果上线半年又曝出歧视问题,直接凉凉。
可信AI,核心是“可信”两个字,不是给别人看的报告,也不是拿出来吹的概念,是真真正正给用户兜底的东西。你得对自己的AI输出负责,得保护用户的隐私,得做到公平无偏见,这才叫真的可信。
我上周参加一个行业沙龙,有个院士说,未来所有的AI都得是可信AI。我当时挺认同的。
用户用你的AI,首先得信你,才敢用你。你连让人信都做不到,技术再牛有什么用?
之前行业跑得太快,把最基本的底线给落下了。现在捡起来,不丢人。反而,谁先把可信这件事做实了,谁才能拿到下一张船票。