实验数据管理:被太多青年科研人忽略的生死关
前两个月去南方某985开青年科研论坛,碰到一个延毕半年的博三学生,蹲在会议室外抽烟,愁眉苦脸。
问了半天才知道,他大二年级做的一组细胞增殖原始数据,存在师姐淘汰的旧笔记本里,当年图省事,文件夹命名全是“新建文件夹(1)”“数据最新”,现在师姐毕业走人,电脑换了三次系统,他翻了整整一个月,愣是没找着对应那组对照组的数据。
重做一遍,正好赶上季节变化,细胞状态不对,又拖了半年。
换谁谁不闹心。
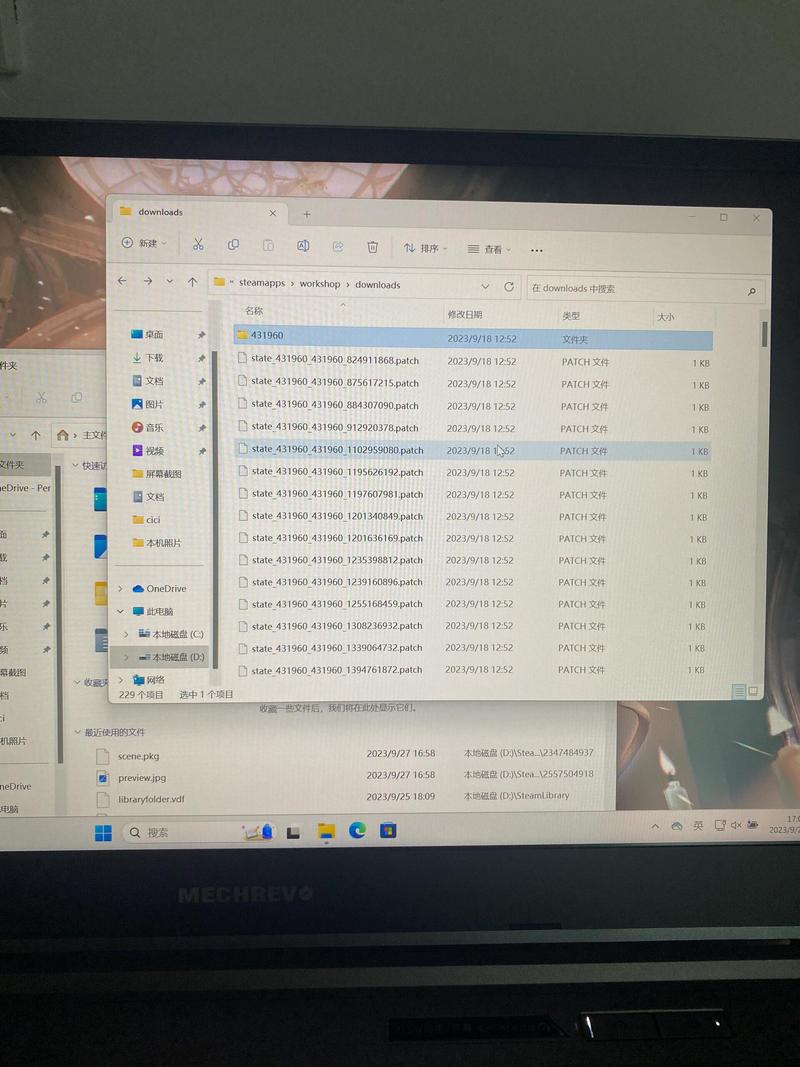 科研实验室混乱命名的实验数据文件夹截图
现在整个科研圈都在讲可重复性,讲开放科学,你数据管得乱七八糟,别说别人来重复你的结果,你自己过一年再看,都记不清当时哪组加了药哪组是空白对照。
别觉得这是小事,现在期刊投稿,越来越多要求上传原始实验数据,被撤稿的文章里,三分之一都栽在数据溯源不清上。
不过话说回来,也不能全怪年轻人懒,很多课题组从上到下就没这个意识,导师都不管,谁会闲得花时间整理这些。
 规范命名的生物实验数据文件夹目录截图
第三件事,定期备份,多份备份。
别把所有鸡蛋放一个U盘里,U盘丢了的,坏了的,我见得太多了。现在学校都有云存储空间,本地一份,实验室服务器一份,云端一份,花不了十分钟,就能避免几年的心血打水漂。
对了,别追求完美的工具,适合自己的就好。你一个三五个人的小课题组,没必要硬上几十人用的大型数据管理系统,折腾半个月,最后没人用,纯浪费钱。
别拿“整理数据”不当核心科研工作
说实话,现在太多科研人脑子里都有个固定误区:做实验、跑模型、写本子才是正事,整理数据就是干完活顺手的打杂活,花时间在这上面就是浪费生命。 真的是这样吗? 我见过拿了青基的青椒,马上要验收,翻出去年的实验数据,五个版本的结果,每个都差一点,自己都记不清哪一个是当时未处理的原始数据,硬生生拖了验收半年。 也见过发了顶刊的大佬,被人质疑结果可重复性,翻了三个月仓库,才在一个旧移动硬盘的角落找着原始记录,差点晚节不保。科研实验室混乱命名的实验数据文件夹截图
现在整个科研圈都在讲可重复性,讲开放科学,你数据管得乱七八糟,别说别人来重复你的结果,你自己过一年再看,都记不清当时哪组加了药哪组是空白对照。
别觉得这是小事,现在期刊投稿,越来越多要求上传原始实验数据,被撤稿的文章里,三分之一都栽在数据溯源不清上。
不过话说回来,也不能全怪年轻人懒,很多课题组从上到下就没这个意识,导师都不管,谁会闲得花时间整理这些。
普通人也能做到的规范实验数据管理
很多人一听到实验数据管理,第一反应就是要花大价钱买服务器、上系统,其实真不是。 对于绝大多数课题组来说,不用整那些花里胡哨的,先把几件最基础的事做好,就能解决90%的问题。 第一件事,从进实验室第一天就定好统一的命名规则,一辈子别乱改。 别整什么“最终版”“真最终版”“绝对不改版”,这种命名我见过太多,过三个月自己都分不清哪个是哪个。 最简单的规则:日期-实验项目-分组-实验人,比如“20240520-小鼠肝癌造模-低剂量给药组-张三”,不管谁来打开文件夹,一眼就能看明白,成本为零,效果拉满。 第二件事,原始数据和处理后的数据必须分开存储,原始数据绝对不能改。 仪器刚导出来的raw数据,就是你的“证据原件”,存完之后锁文件夹,只拷出来做处理,处理后的文件放另一个地方,每一步处理用了什么工具、什么参数、谁处理的,都记在对应实验日志里。 现在很多人用Notion或者Obsidian记实验笔记,直接把对应数据文件夹的链接嵌进去,找的时候点一下就到,太省时间。规范命名的生物实验数据文件夹目录截图
第三件事,定期备份,多份备份。
别把所有鸡蛋放一个U盘里,U盘丢了的,坏了的,我见得太多了。现在学校都有云存储空间,本地一份,实验室服务器一份,云端一份,花不了十分钟,就能避免几年的心血打水漂。
对了,别追求完美的工具,适合自己的就好。你一个三五个人的小课题组,没必要硬上几十人用的大型数据管理系统,折腾半个月,最后没人用,纯浪费钱。