别等崩了才后悔:系统可靠性设计里那些反常识的坑
上个月帮朋友救火,一个做电商的小团队,大促前三天核心订单系统崩了,连夜回滚丢了近千条数据,亏了小几十万。
老板蹲在会议室门口抽烟,一句话不说,整个团队熬了两夜都没缓过来。说白了,所有人之前都把系统可靠性当纸面指标,填在项目文档里给领导看,真出事才知道,都是自己骗自己。
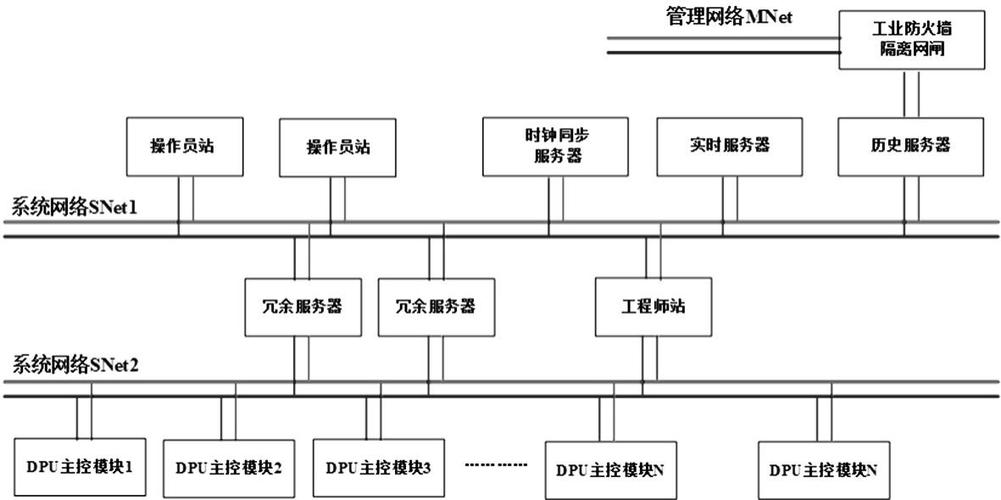 分布式系统跨可用区冗余部署示意图
我早年做银行对账系统的时候,也踩过这个坑。那时候为了达标,匆匆搭了主备,主节点硬盘坏了触发切换,结果备节点半年没更代码,版本比主节点差了三个大版本,启动直接报依赖错。一群人盯着屏幕傻了,最后还是找运维临时恢复硬盘,花了快八个小时才恢复服务,扣了我大半个季度奖金。
从那以后我就认了一个理:冗余不做隔离,不如没有冗余。冗余不做定期演练,不如没有冗余。
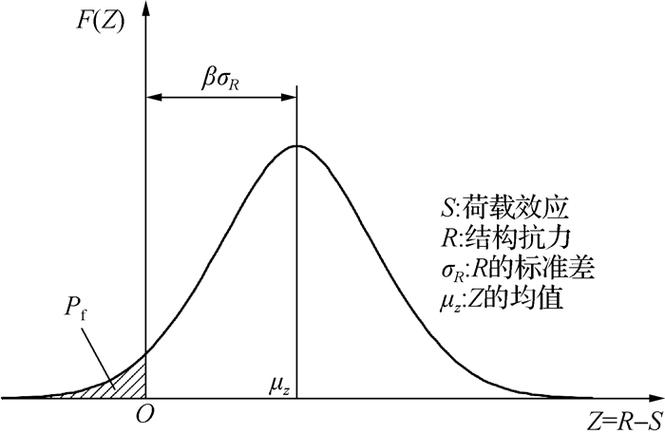 系统可靠性关联失效概率对比图
前几年AWS欧洲区域宕机那次,多大的公司了吧?不还是栽在关联失效上?主园区断电,备用发电机一起故障,冷备集群又放在同一个地质区域,直接全挂,影响了小半个欧洲的互联网服务。
说白了,大部分人做设计的时候,默认风险不会凑到一起。可风险就喜欢凑热闹。
那怎么破?其实也不难,做故障测试的时候,别一个个单点测。要测就拉同一批次、同一区域、同一供电组的节点一起下线,看看系统扛不扛得住。你不这么测,永远不知道自己的系统到底有多脆。
 最可靠的设计,是把故障放进日常
现在很多人一提系统可靠性,就说混沌工程,就说异地多活,听起来玄乎得很,小公司根本玩不起。
其实真不是这么回事。
核心逻辑非常简单:你天天见故障,真出故障就不慌了。你从来没见过故障,出点小事就是灭顶之灾。
我知道美团核心交易团队有个坚持了快十年的习惯,每天上班第一件事,随机干掉一个线上核心节点,干掉之后该干嘛干嘛,开发运维都习以为常。真出大故障,所有人该切流切流,该回滚回滚,一点不慌。
说实话,小公司没必要照搬大厂的混沌工程平台,花那个钱闲的。你每周抽半小时,手动切一次主备,行不行?你每个月抽一个周末,模拟一次核心数据库宕机,让团队练一遍恢复流程,会不会?花不了多少资源,但是效果比你写一百页设计文档强一百倍。
还有个反常识的点,很多人不知道:系统可靠性不是越高越好,要匹配你的业务成本。你一个内部用的报销系统,一年宕机一天都影响不了什么,非要砸钱做五个九的可靠性,纯纯浪费资源。反过来,你做电商大促的订单系统,做支付的核心交易系统,少宕机一小时就是几十万上百万的利润,该砸的钱一分都不能省。
之前碰到一个创业团队,老板听了几次架构师的吹水,砸了几百万做异地多活,那时候他们整个产品日活才不到一千,钱烧完了,产品还没跑通,直接散伙了。可惜不可惜?
不过话说回来,可靠性这东西,就是未雨绸缪。你平时多花十分力气养,出事就能少亏一百分的钱。
很多人觉得系统可靠性设计是搭完架构就结束的活。不对。可靠性是养出来的,不是画在图纸上画出来的。你天天不管它,它迟早给你捅个大篓子。
就这样。
别迷信冗余,大多数冗余都是摆看的
提到系统可靠性设计,绝大多数人第一反应就是加冗余。主节点坏了切备节点,不就完了? 说实话,我见过的冗余,十个里有七个是摆设。 有把主备节点放在同一个物理机的虚拟化分区的,有主备共享同一个存储的,还有更离谱的,主备都接同一路市电。真出问题,就是一起死。你堆再多冗余有什么用? 去年信通院发布的中小互联网技术基础设施调研,超过60%的受访企业,主备系统没有做物理隔离。这个数字真的吓到我了。分布式系统跨可用区冗余部署示意图
我早年做银行对账系统的时候,也踩过这个坑。那时候为了达标,匆匆搭了主备,主节点硬盘坏了触发切换,结果备节点半年没更代码,版本比主节点差了三个大版本,启动直接报依赖错。一群人盯着屏幕傻了,最后还是找运维临时恢复硬盘,花了快八个小时才恢复服务,扣了我大半个季度奖金。
从那以后我就认了一个理:冗余不做隔离,不如没有冗余。冗余不做定期演练,不如没有冗余。
失效从来不是独立事件,这个坑90%的人都踩过
教科书上教可靠性计算,都是把每个模块的失效概率乘起来,默认各个模块失效是独立的。对吧? 现实里哪有什么独立失效?全是扎堆来的。 同批次生产的硬盘,设计寿命差不多,老化时间也差不多,一个坏了,剩下几个大概率也快了。夏天IDC机房制冷出问题,整个机柜的所有节点温度一起飙升,所有硬件的失效概率同步往上翻,你算出来两个节点同时坏的概率是万分之一,实际可能接近十分之一。系统可靠性关联失效概率对比图
前几年AWS欧洲区域宕机那次,多大的公司了吧?不还是栽在关联失效上?主园区断电,备用发电机一起故障,冷备集群又放在同一个地质区域,直接全挂,影响了小半个欧洲的互联网服务。
说白了,大部分人做设计的时候,默认风险不会凑到一起。可风险就喜欢凑热闹。
那怎么破?其实也不难,做故障测试的时候,别一个个单点测。要测就拉同一批次、同一区域、同一供电组的节点一起下线,看看系统扛不扛得住。你不这么测,永远不知道自己的系统到底有多脆。
最可靠的设计,是把故障放进日常
最可靠的设计,是把故障放进日常
现在很多人一提系统可靠性,就说混沌工程,就说异地多活,听起来玄乎得很,小公司根本玩不起。
其实真不是这么回事。
核心逻辑非常简单:你天天见故障,真出故障就不慌了。你从来没见过故障,出点小事就是灭顶之灾。
我知道美团核心交易团队有个坚持了快十年的习惯,每天上班第一件事,随机干掉一个线上核心节点,干掉之后该干嘛干嘛,开发运维都习以为常。真出大故障,所有人该切流切流,该回滚回滚,一点不慌。
说实话,小公司没必要照搬大厂的混沌工程平台,花那个钱闲的。你每周抽半小时,手动切一次主备,行不行?你每个月抽一个周末,模拟一次核心数据库宕机,让团队练一遍恢复流程,会不会?花不了多少资源,但是效果比你写一百页设计文档强一百倍。
还有个反常识的点,很多人不知道:系统可靠性不是越高越好,要匹配你的业务成本。你一个内部用的报销系统,一年宕机一天都影响不了什么,非要砸钱做五个九的可靠性,纯纯浪费资源。反过来,你做电商大促的订单系统,做支付的核心交易系统,少宕机一小时就是几十万上百万的利润,该砸的钱一分都不能省。
之前碰到一个创业团队,老板听了几次架构师的吹水,砸了几百万做异地多活,那时候他们整个产品日活才不到一千,钱烧完了,产品还没跑通,直接散伙了。可惜不可惜?
不过话说回来,可靠性这东西,就是未雨绸缪。你平时多花十分力气养,出事就能少亏一百分的钱。
很多人觉得系统可靠性设计是搭完架构就结束的活。不对。可靠性是养出来的,不是画在图纸上画出来的。你天天不管它,它迟早给你捅个大篓子。
就这样。