抗风险技术设计:别等出事了才想起补漏洞
说实话,我前两个月跟一家连锁生鲜企业的技术负责人喝茶,听完他的遭遇差点没笑出来——当然是苦笑。去年郑州那场特大暴雨,淹了他们位于郊区的中心仓,整仓的货泡了也就算了,连带着把他们存放在中心仓地下机房的核心业务服务器、还有“异地备份”用的备机一起给淹了。
哦对,他们所谓的异地备份,就是把备份机放在中心仓隔壁三公里的另一个网点地下车库。整个区域全淹,连网都断了,三天时间全公司没人能查库存、没人能开收银台,直接亏了小两千万。
他说当时做灾备方案报预算,老板拍着桌子说,郑州几十年没下过这么大的雨,花几十万搞千里之外的备份,纯纯浪费钱。出事之后呢?老板又反过来骂技术部考虑不周,连这点风险都防不住。
太常见了。
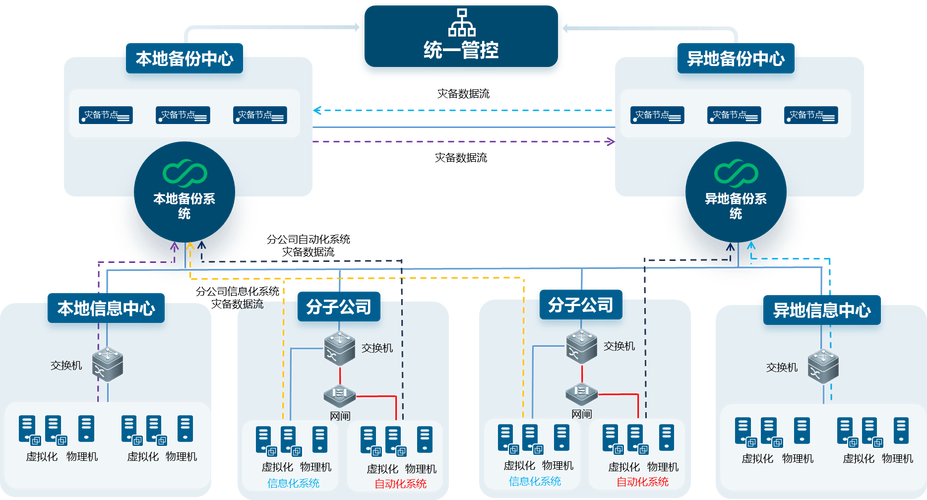 企业数据中心异地灾备抗风险架构图
 绝大多数抗风险方案,都是样子货
我跑过不下几十个行业的技术落地,见过太多PPT上写得花里胡哨的抗风险方案,真出事儿了连一回合都撑不住。
很多人对抗风险技术设计的理解还停留在“买个保险、存个备份”,以为把数据拷到另一个硬盘就算完事了。根本没想过,风险从来不会按你预设的剧本走。
疫情的时候,我接触过一家做外贸的工厂,全公司的ERP系统都放在总部办公楼的服务器里。当时总部所在区封控,全员不能进楼,网络运维都出不来,整个工厂的生产、订单、出货全停了,停了整整十二天,硬生生亏掉了大半年的利润。你说他们没备份?有,备份就在总部办公楼的另一个机柜里。有什么用?
不过话说回来,这事也不能全怪技术岗背锅。老板们都盯着营收、盯着KPI,抗风险设计本身就是“不赚钱”的活,你投进去几百万,风险没发生,没人会给你发奖金。你不投,只要没出事,没人会说你不对。
等出事了,全都是技术的错。
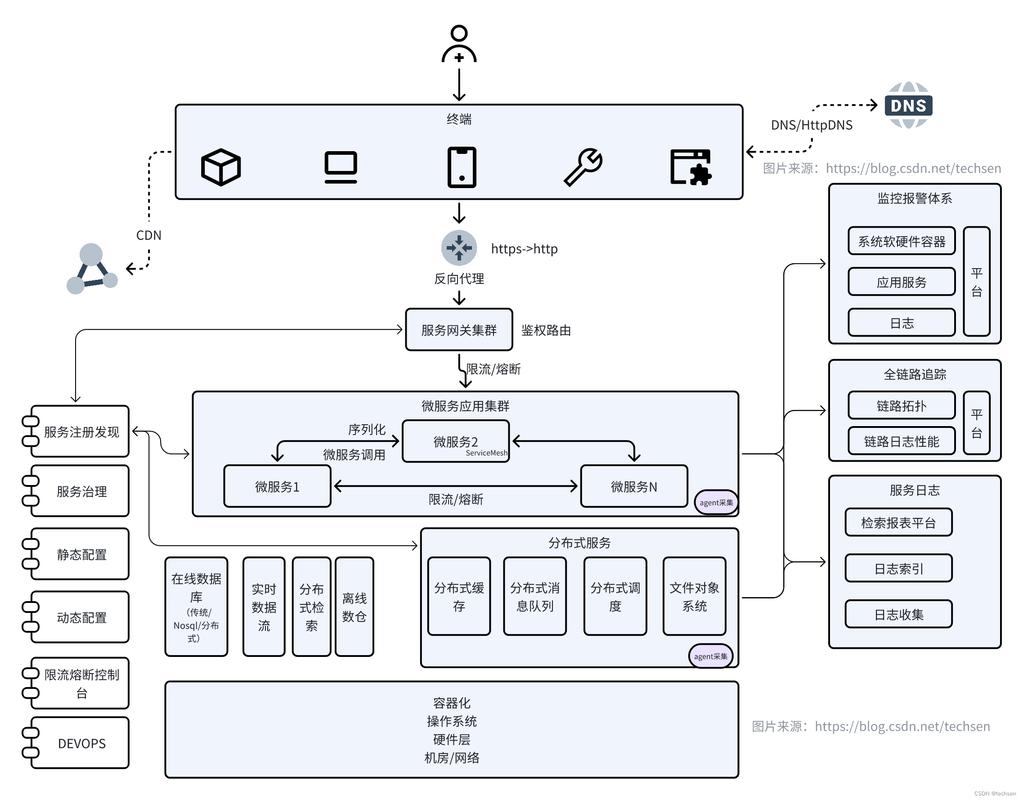 分布式微服务单元化抗风险部署示意图
很多人觉得抗风险就是花大钱堆冗余,其实不对。真正好的抗风险设计,是从架构逻辑上就把风险给拆碎了,让任何一个单点出问题,都掀不翻整条船。
现在AI大模型这么火,一堆企业抢着接入第三方大模型做自己的应用,我跟几个做AI应用的朋友聊,十有八九都没做降级方案。一旦第三方API限流、宕机,你的整个应用直接就趴窝,用户直接就跑了。
稍微用点心的抗风险设计怎么做?很简单,核心的基础对话功能,自己训一个小一点的私有模型部署在自己服务器,第三方大模型用来做复杂的推理,万一第三方挂了,直接切到本地小模型,至少能保住基础可用,不会直接死透。
抗风险技术设计从来不是追求零风险,而是给你留够了翻身的余地。你不用挡住所有的冲击,只要别被第一下就打死就行。
 不是只有大企业才需要抗风险设计
别觉得这是大公司才玩的东西,普通人、小团队一样能用这个思路。
比如你是个独立开发者,做了个小工具给几千人用,别把所有代码、服务都放在同一个云厂商的服务器上,也别把域名解析全放一家。花几十块钱在另一个云厂商整个备机,域名多备一条解析,花不了多少时间,真遇上厂商宕机、被误封,你能直接切过去,不会把半年的心血直接玩没。
再比如你做自媒体,别只在一个平台更内容,别把所有粉丝都导到一个私域账号里。多平台同步发,多留几个联系方式,花不了多少功夫,万一哪天哪个账号出问题被封了,你不至于从头再来。这不就是普通人的抗风险技术设计?
今年这大环境,大家应该都有感觉,黑天鹅乱飞,昨天还好好的行业,说没就没了。放在技术上也是一样,你永远不知道下一个风险是从哪个角落里冒出来的。是云厂商宕机?是暴雨洪水?是疫情封控?还是API突然涨价被停服?
我见过太多本来做得好好的小项目,就因为一次完全可以提前避免的风险,直接没了。太可惜了。
与其等风险找上门把你按在地上摩擦,不如抽点时间,改改架构,多留一手。活下来,比什么花哨的技术都重要。
对不对?
企业数据中心异地灾备抗风险架构图
绝大多数抗风险方案,都是样子货
绝大多数抗风险方案,都是样子货
我跑过不下几十个行业的技术落地,见过太多PPT上写得花里胡哨的抗风险方案,真出事儿了连一回合都撑不住。
很多人对抗风险技术设计的理解还停留在“买个保险、存个备份”,以为把数据拷到另一个硬盘就算完事了。根本没想过,风险从来不会按你预设的剧本走。
疫情的时候,我接触过一家做外贸的工厂,全公司的ERP系统都放在总部办公楼的服务器里。当时总部所在区封控,全员不能进楼,网络运维都出不来,整个工厂的生产、订单、出货全停了,停了整整十二天,硬生生亏掉了大半年的利润。你说他们没备份?有,备份就在总部办公楼的另一个机柜里。有什么用?
不过话说回来,这事也不能全怪技术岗背锅。老板们都盯着营收、盯着KPI,抗风险设计本身就是“不赚钱”的活,你投进去几百万,风险没发生,没人会给你发奖金。你不投,只要没出事,没人会说你不对。
等出事了,全都是技术的错。
抗风险技术设计的核心,是反脆弱,不是防风险
我见过做得最漂亮的抗风险设计,是某股份制银行的核心交易系统。早几年他们就把整个核心交易切成了上百个独立的单元化节点,每个节点管一个区域的客户交易,节点之间完全隔离,互不影响。 有次其中三个节点因为硬件故障全挂了,整个系统自动就把那三个节点的流量切去了周边空闲节点,整个过程不到十秒,绝大多数客户根本没感觉到异常。换做以前,整个核心系统全宕机,最少停半个小时,那损失可不是亿单位能打住的。分布式微服务单元化抗风险部署示意图
很多人觉得抗风险就是花大钱堆冗余,其实不对。真正好的抗风险设计,是从架构逻辑上就把风险给拆碎了,让任何一个单点出问题,都掀不翻整条船。
现在AI大模型这么火,一堆企业抢着接入第三方大模型做自己的应用,我跟几个做AI应用的朋友聊,十有八九都没做降级方案。一旦第三方API限流、宕机,你的整个应用直接就趴窝,用户直接就跑了。
稍微用点心的抗风险设计怎么做?很简单,核心的基础对话功能,自己训一个小一点的私有模型部署在自己服务器,第三方大模型用来做复杂的推理,万一第三方挂了,直接切到本地小模型,至少能保住基础可用,不会直接死透。
抗风险技术设计从来不是追求零风险,而是给你留够了翻身的余地。你不用挡住所有的冲击,只要别被第一下就打死就行。
不是只有大企业才需要抗风险设计
不是只有大企业才需要抗风险设计
别觉得这是大公司才玩的东西,普通人、小团队一样能用这个思路。
比如你是个独立开发者,做了个小工具给几千人用,别把所有代码、服务都放在同一个云厂商的服务器上,也别把域名解析全放一家。花几十块钱在另一个云厂商整个备机,域名多备一条解析,花不了多少时间,真遇上厂商宕机、被误封,你能直接切过去,不会把半年的心血直接玩没。
再比如你做自媒体,别只在一个平台更内容,别把所有粉丝都导到一个私域账号里。多平台同步发,多留几个联系方式,花不了多少功夫,万一哪天哪个账号出问题被封了,你不至于从头再来。这不就是普通人的抗风险技术设计?
今年这大环境,大家应该都有感觉,黑天鹅乱飞,昨天还好好的行业,说没就没了。放在技术上也是一样,你永远不知道下一个风险是从哪个角落里冒出来的。是云厂商宕机?是暴雨洪水?是疫情封控?还是API突然涨价被停服?
我见过太多本来做得好好的小项目,就因为一次完全可以提前避免的风险,直接没了。太可惜了。
与其等风险找上门把你按在地上摩擦,不如抽点时间,改改架构,多留一手。活下来,比什么花哨的技术都重要。
对不对?