那些改变你日常的人机交互技术,不止大模型的聊天框
你每天都在用,却根本没注意到的隐形交互
早上醒来摸手机解锁。脸对着屏幕就开了。这就是人机交互技术啊。很多人觉得这就是个普通功能,哪里算什么前沿技术?不对,最早的人脸识别解锁,那交互逻辑是你必须把脸对准屏幕框,站定等个一两秒,现在呢?你刚拿起来,还没停稳就开了,这背后是交互逻辑的更新,不是算法参数涨了那么简单。
你现在用的输入法,打一半就给你出整句,甚至能接上你上一秒想说的话,这不也是人机交互技术?原来的输入法联想只看你当前打了什么字,现在能结合你过去十分钟的聊天内容,猜你接下来想打什么,本质就是把人的表达习惯揉进了机器的输出逻辑里。
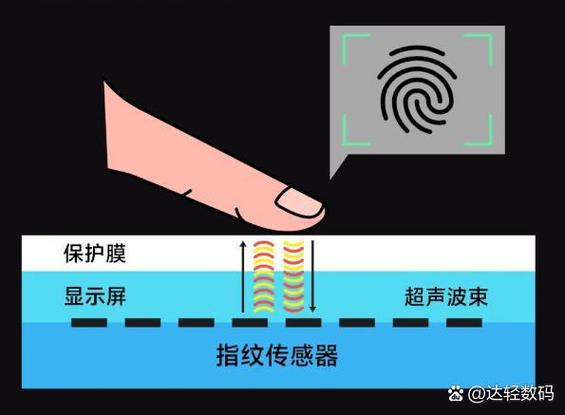 手机屏下指纹人机交互示意图
说实话我之前参加过一个人机交互的小型闭门沙龙,有个浙大的年轻博士说,现在行业最大的误区就是,把人机交互等同于“做UI界面”。不对,交互的核心是让机器准确读懂人的真实意图,不是画个好看的按钮做个渐变色就完事。
比如你开车的时候用车载导航,随口说一句“我有点冷”,导航直接联动车机调低了空调温度,不需要你一字一句说“打开空调调低两度”,这就是交互的进步。从原来的“必须说对指令机器才动”,变成现在“机器能get你随口说的需求”,这中间差了十年的技术迭代。
大模型带火的新一代交互,到底坑在哪
这两年大模型火了,所有人都在喊自然语言交互就是人机交互的最终形态。我之前踩过坑,试用过三个不同品牌的全语音交互智能家居,体验真的一言难尽。你说“打开客厅的主灯”,它给你打开餐厅的筒灯。你说“调暗一点”,它直接给你把全屋灯都关了。
不是语音识别不准,是交互逻辑从根上错了。原来的交互是“你触发一步,机器做一步”,边界很清楚。现在很多做自然交互的团队,为了炫技,让机器全程监听所有声音,什么话都要理解一遍,结果呢?你刚和朋友聊到昨天吃的火锅,它突然跳出来说“找到三家附近的火锅店”,这不捣乱吗?
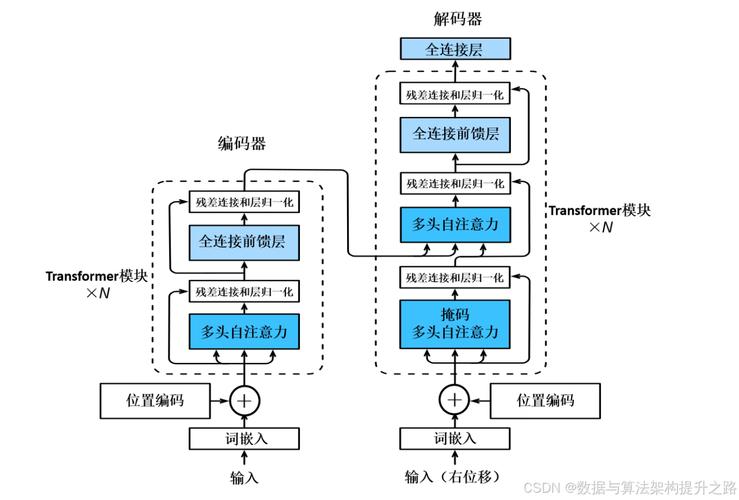 大模型自然语言人机交互流程图
不过话说回来,今年上半年卡内基梅隆大学发布的那篇动态意图锚定交互的成果,确实解决了不少行业痛点。它不是全程盯着你的每一句话,它会先通过多模态信号判断,你这句话是不是说给机器的,只有明确触发了交互意图,它才启动处理。我去年看过原型演示,准确率比之前的无锚定交互高了38%,真的挺惊喜。
很多人以为人机交互就是拼大模型参数,参数越大交互越好,哪有这么简单。人跟人说话还要看场景看语气看关系呢,机器凭啥就能啥都懂?核心就是要给交互划好边界,哪些该管哪些不该管,这才是现在顶尖科研团队在啃的硬骨头,不是堆参数就能解决的。
未来三五年,人机交互会落地到哪些地方
 未来三五年,人机交互会落地到哪些地方
最近我关注到国内手机厂商做的微动作空气手势交互,不是早几年那种要你举着胳膊挥半天的噱头产品,现在它能捕捉你毫米级的手指动作,还能过滤掉无意识手抖带来的误触,你在空气中点一下滑一下,就能翻照片切歌接电话,我体验过一次,真的惊艳。
想想看,当你手上沾了面粉正在做面包,或者刚从菜市场出来拎着满手菜,想切个歌接个电话,不需要擦手放袋子,隔空动一下手指就搞定,这个场景不香吗?原来很多人觉得空气手势没用,那是之前的技术没做到位,交互逻辑错了,现在做对了,一下子就实用了。
还有很少被普通大众关注的多通道融合交互,什么意思?就是机器同时收集你的语音、手势、眼神甚至微表情,把这些信息拼起来,猜你真正想要什么。比如你站在冰箱前面,皱着眉随口说一句“没东西吃了”,机器不会傻愣愣给你搜“没东西吃了怎么办”,它看到你盯着冰箱,又有皱眉的负面情绪,直接给你弹出附近超市的半小时配送界面,这才是真的懂人。
现在很多厂商就喜欢搞噱头,什么元宇宙全身交互,什么脑机接口打游戏,大部分日常场景根本用不上。你在家躺沙发上看个电影,还要穿上动捕服站着互动?疯了吧。
好的人机交互,从来都是让人感觉不到技术的存在。你想做什么,自然而然就做成了,根本不需要你费脑子想“我该怎么给机器说清楚我的指令”。就像你现在用的电容触摸屏,你根本不会天天想着“我在用人机交互技术”,你只知道我点一下就能打开app,滑动就能翻页,这就对了。
再过十年回头看,现在我们天天对着打字聊天的大模型聊天框,肯定会像我们今天看十年前的按键功能机一样,觉得原始得不可思议。交互技术的每一点进步,最后都会变成我们习以为常的日常,润物细无声,这才是它最厉害的地方。