量子计算研究:我们离真正的落地还有多远?
现在的量子计算研究,到底走到哪一步了?
网上一搜,全是“某某公司造出千比特量子芯片”“量子优势再突破”的新闻,看得人以为明天量子电脑就能装去你家笔记本了。真相呢?现在整个行业还在NISQ时代(含噪声中等规模量子时代)卡着。什么意思?就是我们能做出来几十个到几千个量子比特,但是这些比特太娇贵了,一点点温度变化、一点辐射就能让它退相干,运算出来的结果错一半,根本没法做大规模的通用计算。
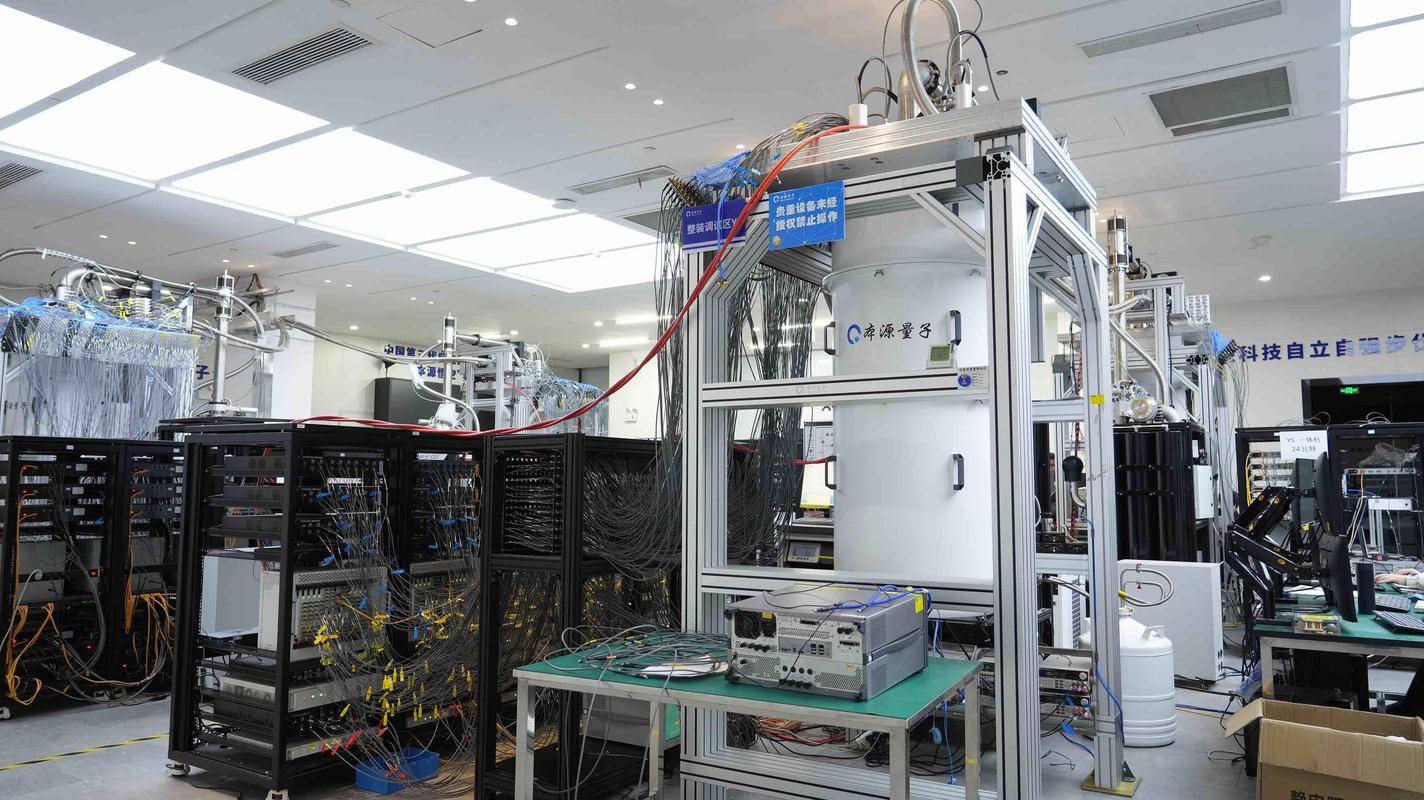 超导量子计算芯片实验室实拍
之前IBM推出的433比特处理器,后来业内人拆解过,大部分比特都是凑数的,真正能用的没多少。不是说造假,是大家对“比特数”的定义不一样,资本和媒体爱看大数,那我就给你大数。很多人不知道,比特多不代表算力强,一个100比特全纠错的量子处理器,比一万个不带纠错的噪声比特有用一万倍。对吧?
就算是已经被验证的“量子优势”,也都是挑了特定问题做出来的,换一个日常的优化问题,经典计算机分分钟就能反超,这个实话,很少有媒体愿意说。
当前最有价值的量子计算研究,其实不是堆比特
这几年我跑了那么多院所和企业,发现真正能出东西的研究,根本不是天天堆比特数。最有潜力的两个方向,一个是量子模拟,一个是量子纠错技术。量子模拟本来就是物理学家为了算量子系统发明出来的工具,用量子模拟量子,顺理成章。
比如现在创新药研发,最头疼的就是算蛋白质的折叠结构,传统超算算一个几千个氨基酸的蛋白质,要跑好几个月,还不一定准,NISQ时代的量子计算机就能把这个时间压缩到几小时,准确率还更高。还有新材料研发,找更高效的光伏材料、锂电池固态电解质、化工催化剂,量子模拟能直接算出原子和电子之间的相互作用,省去了一遍又一遍做实验试错的成本,光这一块,每年就能给行业省几百亿的研发费用。
 量子计算模拟蛋白质折叠结果示意图
去年中科大的团队,把量子纠错的逻辑比特错误率压到了容错阈值以下,这个成果我敢说,比堆出几千个比特的意义大得多。没有纠错,永远别想做通用量子计算,之前大家都觉得纠错还要二三十年,现在看来,进度比预想的快多了。不过话说回来,现在这些成果,都还是实验室阶段,你让它立刻给你赚钱,不可能。但是架不住资本愿意投啊,毕竟谁都不想错过下一个“计算机革命”。
量子计算研究的泡沫,和真正的未来
 量子计算研究的泡沫,和真正的未来
说实话,现在泡沫真不小。PPT量子公司一抓一大把,拿着几个比特的原型机就敢吹“已经实现商业化”,拉完融资就开始割韭菜,圈内人都看不下去。还有很多自媒体瞎吹,说什么十年后经典计算全报废,人人都要用量子电脑,纯纯的扯淡。
量子计算从诞生那天起,定位就是经典计算的补充,不是取代。未来的计算架构一定是量子经典混合,通用计算还是经典CPU、GPU来做,遇到经典算不动的复杂问题,再丢给量子处理器做加速,就这么简单。我接触过的真正深耕量子计算研究的人,几乎没人说大话,大多都很务实,说落地还要10到15年,没错,我也这么认为。
现在很多人说量子计算能破解现有密码体系,要慌,其实慌什么?破解RSA需要上百万个纠错量子比特,现在全世界加起来都凑不出一千个能用的纠错比特,至少二十年内,用不着担心这个。最近还有人说巨头都在砍量子团队,行业要凉了?不对,只是砍掉了那些赚快钱的PPT项目,核心的研究团队都留着,大家都不傻,都知道这东西是未来计算的皇冠,现在亏点钱占坑,总比以后被卡脖子强。
上个月那个青千跟我说,他读博的时候导师说,我们这代做量子的,可能就是铺路的,不一定能等到商用那一天。他说他现在不信,他说三十岁的时候开始做,六十岁的时候肯定能看到第一个改变全行业的应用出来。我觉得他说得对。现在坐冷板凳做基础研究的人不多了,肯沉下心搞量子计算研究的,更不多。我们不用天天吹它多神奇,也不用一棒子打死说全是骗局,给它点时间,它会给你惊喜。对吧?