云计算平台构建:踩过坑的老炮才懂的实战细节
我前阵子帮朋友创业公司搭云计算平台,差点没把头发熬掉。
说起来好笑,他一开始拿着大厂的技术方案照搬,光初期预算就报了两百万,聊下来砍到三分之一都不到,还一堆没必要的花架子。
今天就把这些年帮人搭平台攒的干货倒出来,都是踩坑踩出来的经验。
 云计算平台分层负载架构部署图
说实话,现在最靠谱的构建思路,其实是分层解耦的弹性负载池。把计算、存储、网络三层拆开,每个分层按需求配资源。
冷数据扔廉价对象存储,一年一百块就能放几个T;高频访问的热数据放SSD云盘;核心业务留固定节点,突发流量靠弹性实例临时扩容,峰谷平滑切换。
我见过最离谱的案例,一个做私域社群的小团队,跟风搭了三节点高可用私有云集群,平时在线峰值才不到两千人,CPU利用率常年低于10%。浪费钱不说,运维还要每周盯补丁升级,纯纯给自己找罪受。
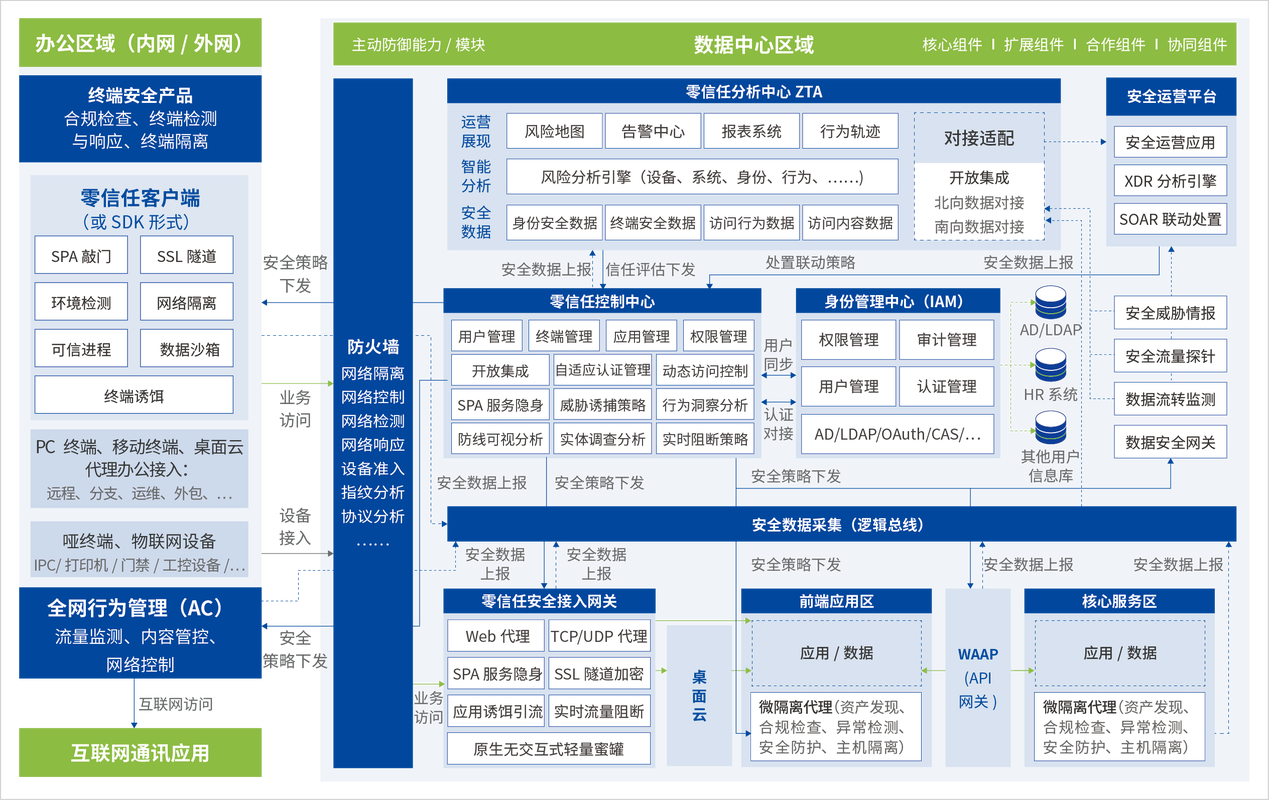 云计算平台零信任权限配置示意图
现在构建平台,安全的核心是零信任架构下的最小权限原则。说白了就是,不管是谁,不管是内部还是外部,每个服务、每个账号,只能拿到干活必须的那点权限,多一点都不给。
你做支付的服务,就只给它访问交易数据库的权限,连公司内部的文档服务器门都摸不到。哪怕真的被攻破了,损失也锁死在一小块地方,根本蔓延不开。
别嫌麻烦。真出事的时候,这点麻烦算什么?
哦对,还有全量链路日志,很多人搭完平台就忘了开,出了问题查都不知道去哪查,只能干瞪眼,这也是新手必踩的坑。
 看不见的浪费,才是成本里最疼的一刀
很多人算云计算成本,只算买服务器的钱,根本不算闲置资源、冗余带宽、超额存储这些零碎开销。月底出账单的时候,直接吓一跳。
我经手过的项目里,八成公司的云成本,至少30%是纯浪费掉的。
用完没销毁的测试实例,绑着弹性IP天天扣钱;半年都没人碰的冷数据,存在高性能SSD上;为了所谓的高可用,开了双倍的冗余节点,其实一年都用不上一次。这不就是把钱往水里扔吗?
现在行业里最实用的玩法,就是把FinOps动态成本管控嵌到构建流程里。从一开始就给每个业务、每个部门打成本标签,谁用谁承担,每个月自动扫描闲置资源,发提醒甚至自动关停。
买实例也有技巧,长期跑的核心业务买预留实例,比按需便宜一半都不止;临时的测试、活动需求用按需,用完就停,不花冤枉钱。这么一套下来,很多公司的云成本直接压掉三分之一,一点不夸张。
不过话说回来,成本优化也不能瞎省。该留的冗余还是得留。
我之前见过一家公司,为了省几百块钱,把核心数据库的备份存到了低速归档存储里,真出了故障要恢复,硬生生等了八个小时才恢复完,停服八个小时的损失,比省那点钱多一百倍都不止。对吧?
最近这两年云原生火,很多人一上来就要全套K8s自研部署,仿佛不用就是技术落后。
说实话,小团队真没必要。你总共才三五个开发,养不起专门运维K8s的人,搭好了也是天天出奇奇怪怪的问题,不如用云厂商托管的容器服务,省心,算下来成本还更低。
云计算平台构建,从来不是比谁用的技术新潮,比谁堆的硬件多。你能匹配自己的业务规模,少踩坑,把钱花在真正能产生价值的地方,就已经赢过八成的新手了。
别上来就堆硬件,先搞清楚你的负载底盘
很多新手的第一个误区,就是上来先砸钱买最贵的服务器,租最大的带宽,生怕不够用。 真的没必要。 不同业务的负载特性,差得能有十万八千里。你做AI大模型微调训练,要的是高GPU显存、低延迟的节点互联;你做静态博客站,一个五百块一年的轻量应用服务器都能跑满;你做电商大促,要的是弹性伸缩能随时拉容量,平时能缩回去省钱。 不对负载做拆分,全堆在一起,不是资源闲得长毛,就是高峰的时候卡成PPT。云计算平台分层负载架构部署图
说实话,现在最靠谱的构建思路,其实是分层解耦的弹性负载池。把计算、存储、网络三层拆开,每个分层按需求配资源。
冷数据扔廉价对象存储,一年一百块就能放几个T;高频访问的热数据放SSD云盘;核心业务留固定节点,突发流量靠弹性实例临时扩容,峰谷平滑切换。
我见过最离谱的案例,一个做私域社群的小团队,跟风搭了三节点高可用私有云集群,平时在线峰值才不到两千人,CPU利用率常年低于10%。浪费钱不说,运维还要每周盯补丁升级,纯纯给自己找罪受。
安全不是事后补的补丁,是从根上嵌进去的
这一点我真的喊破喉咙都没人听,直到出事才追悔莫及。 去年帮一个在线教育公司擦屁股,他们当初搭平台的时候,安全是最后加的,买了个云防火墙就完事了。用户信息存在公共存储桶里,权限没关,结果被爬虫爬了十几万条用户手机号,罚款不说,品牌口碑直接掉地上捡不起来。 很多人对云计算平台的安全还停留在十年前的思路:围个墙,把坏人挡在外面就完了。现在早变天了。云计算平台零信任权限配置示意图
现在构建平台,安全的核心是零信任架构下的最小权限原则。说白了就是,不管是谁,不管是内部还是外部,每个服务、每个账号,只能拿到干活必须的那点权限,多一点都不给。
你做支付的服务,就只给它访问交易数据库的权限,连公司内部的文档服务器门都摸不到。哪怕真的被攻破了,损失也锁死在一小块地方,根本蔓延不开。
别嫌麻烦。真出事的时候,这点麻烦算什么?
哦对,还有全量链路日志,很多人搭完平台就忘了开,出了问题查都不知道去哪查,只能干瞪眼,这也是新手必踩的坑。
看不见的浪费,才是成本里最疼的一刀
看不见的浪费,才是成本里最疼的一刀
很多人算云计算成本,只算买服务器的钱,根本不算闲置资源、冗余带宽、超额存储这些零碎开销。月底出账单的时候,直接吓一跳。
我经手过的项目里,八成公司的云成本,至少30%是纯浪费掉的。
用完没销毁的测试实例,绑着弹性IP天天扣钱;半年都没人碰的冷数据,存在高性能SSD上;为了所谓的高可用,开了双倍的冗余节点,其实一年都用不上一次。这不就是把钱往水里扔吗?
现在行业里最实用的玩法,就是把FinOps动态成本管控嵌到构建流程里。从一开始就给每个业务、每个部门打成本标签,谁用谁承担,每个月自动扫描闲置资源,发提醒甚至自动关停。
买实例也有技巧,长期跑的核心业务买预留实例,比按需便宜一半都不止;临时的测试、活动需求用按需,用完就停,不花冤枉钱。这么一套下来,很多公司的云成本直接压掉三分之一,一点不夸张。
不过话说回来,成本优化也不能瞎省。该留的冗余还是得留。
我之前见过一家公司,为了省几百块钱,把核心数据库的备份存到了低速归档存储里,真出了故障要恢复,硬生生等了八个小时才恢复完,停服八个小时的损失,比省那点钱多一百倍都不止。对吧?
最近这两年云原生火,很多人一上来就要全套K8s自研部署,仿佛不用就是技术落后。
说实话,小团队真没必要。你总共才三五个开发,养不起专门运维K8s的人,搭好了也是天天出奇奇怪怪的问题,不如用云厂商托管的容器服务,省心,算下来成本还更低。
云计算平台构建,从来不是比谁用的技术新潮,比谁堆的硬件多。你能匹配自己的业务规模,少踩坑,把钱花在真正能产生价值的地方,就已经赢过八成的新手了。