开源技术应用:从实验室论文到产业落地的坑与光
去年帮一个在读博士改毕业论文的实验部分,印象特别深。他们课题组一年前立项做面向垂域的小模型,组长拍板要全栈自研,从数据处理到推理框架全自己写。折腾了八个月,模型跑出来的准确率比开源基线低12个点, deadlines快到了,全组天天熬夜掉头发。后来听了建议,把基础底座换成开源的Qwen-7B,只把自己创新的注意力机制和微调方法嵌进去,不到三个月就跑出了符合要求的结果,上个月刚中了本领域的顶会。
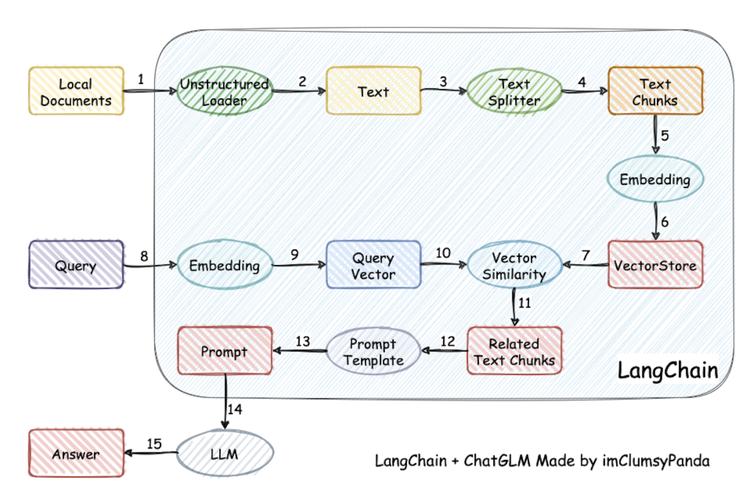 科研领域开源大模型适配流程图
说实话,我见过太多人错把红利当免费馅饼。不少年轻学生,拿了开源代码改改参数,换个数据集跑一遍,就敢写论文说自己提出了新模型。盲审的时候遇到严格的老师,直接一句“核心创新均来自开源项目,无实质贡献”,直接给挂了,找谁哭去?
真正会用开源技术做科研的人,都拎得清主次。开源是给你搭好的台子,戏要你自己唱。上个月看CVPR 2024的一篇医学影像分割论文,核心创新就是针对罕见病样本少提出的动态损失函数,骨干网络直接用了开源的SegFormer,人家写得明明白白,一点不藏着,最后照样拿了最佳论文提名。为什么?因为人家的创新是真的,开源只是帮他省了造轮子的时间,让他能把所有精力放在真正要解决的问题上。
 开源软件协议商用合规对照表
第二个是性能坑。开源项目放出来的版本,大多是适配demo场景的,能跑通就行,根本没做工业级优化。我前年帮一家头部电商做商品图文审核,一开始图便宜,用了某热门开源的多模态检测模型,本地测试集准确率97%,看着挺完美。结果上线第三天大促,高峰并发一上来,延迟直接飙到2秒,比要求的200ms差了十倍,把负责运营的小姑娘急得在会议室掉眼泪。最后我们团队折腾了一个多月,做算子融合、INT4量化、推理引擎重构,才把延迟压到要求以内,前前后后花的人力成本,比买商用授权贵了三倍都不止。
第三个是维护坑。很多热门开源项目,背后其实就是两三个学生做毕业设计,人家毕业项目一交,直接停更。你线上跑着,哪天出了安全漏洞,翻遍仓库找不到人,发issue半年没人回,叫天天不应叫地地不灵。之前有个做金融的朋友,他们核心系统用的某个开源中间件,出了漏洞找不到人修,最后花了几十万请国内的开源服务商做紧急维护,才把坑填上。
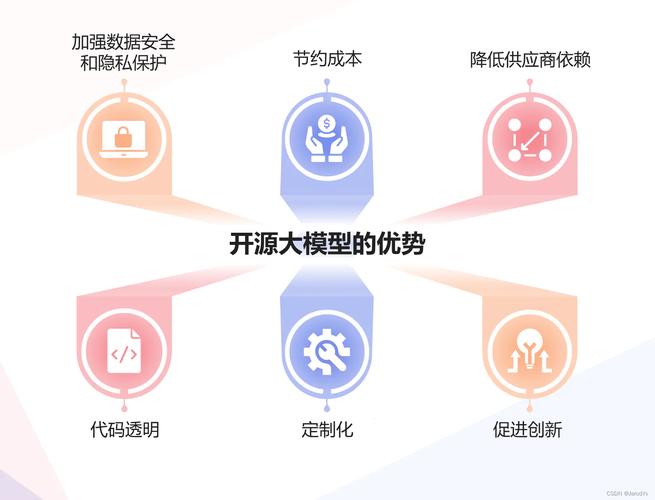 把开源技术用出价值的核心逻辑
说了这么多坑,不是让大家别用开源。恰恰相反,现在这个时代,不会用开源技术,根本做不出快的成果。关键是怎么用,这里头有门道。
做科研的朋友,记住一点:把你的核心精力放在真创新上,轮子能用开源就用开源。你一个博士生,五年学制,花两年从零写一个深度学习框架,写出来性能还不如PyTorch,图什么?有这时间你多做十组实验,多挖几个真问题,不比造轮子有用?当然,你要是本身研究方向就是做框架,那当我没说。
做产业落地的朋友,记住第二点:基础能力用开源,核心竞争力攥在自己手里。我认识一家做农业自动驾驶的创业公司,他们做田间感知用的基础重建框架就是开源的Nerfstudio,但是针对农田复杂光影、动态作物的优化算法,是自己做的,申请了专利,这就是对的。既省了至少两年的研发时间,躲过了行业窗口,核心技术又捏在自己手里,不会被卡脖子。
不过话说回来,现在国内的开源生态真的越来越好,前几年大家都是用国外的开源项目,现在很多国内高校和大厂做出来的成果,都直接开源,不少项目在全球都排得上号。去年全球Top 100热门开源项目里,中国贡献的已经有二十多个了,这个变化真的太大了。
说白了,开源的本质是什么?就是众人拾柴火焰高,你用我的,我用你的,大家都不用重复造轮子,把精力花在真正的创新上,整个行业的进步速度自然就提上来了。
别干那种拿开源改个名就说自己自研的丑事,也别为了所谓的“全自研”非要从零造轮子浪费时间。拎清楚,借力,然后长出自己的东西,这才是开源技术应用的正确打开方式。
科研圈的开源红利,不是免费午餐
现在做科研,哪还有完全不用开源技术的?别说做AI了,做化学模拟、做天文数据分析、做生物测序,哪个不用现成的开源工具?大模型火了之后,更是把开源的红利拉满。之前课题组想要训一个能用的底座,没有几千万的算力根本拿不下来,现在随便下个开源的7B、13B参数模型,单张A100就能跑适配,成本降了几十倍都不止。科研领域开源大模型适配流程图
说实话,我见过太多人错把红利当免费馅饼。不少年轻学生,拿了开源代码改改参数,换个数据集跑一遍,就敢写论文说自己提出了新模型。盲审的时候遇到严格的老师,直接一句“核心创新均来自开源项目,无实质贡献”,直接给挂了,找谁哭去?
真正会用开源技术做科研的人,都拎得清主次。开源是给你搭好的台子,戏要你自己唱。上个月看CVPR 2024的一篇医学影像分割论文,核心创新就是针对罕见病样本少提出的动态损失函数,骨干网络直接用了开源的SegFormer,人家写得明明白白,一点不藏着,最后照样拿了最佳论文提名。为什么?因为人家的创新是真的,开源只是帮他省了造轮子的时间,让他能把所有精力放在真正要解决的问题上。
从论文到落地,开源技术藏着多少暗坑
科研圈用错了最多是延毕,产业界用错了,那可是真金白银的损失。我接触过的做落地的团队,十个里有八个踩过开源的坑,最常见的几个,给大家捋捋。 第一个就是协议坑。很多人用开源代码不看协议,觉得放出来就是给人用的。去年国内有个做ToB SaaS的创业公司,用了一个GPL协议的开源组件,没做隔离,把整个产品的代码都传染了,被开源社区的人举报,最后赔了两百多万,还不得不把自己的核心代码公开了一部分,差点把公司搞垮。开源软件协议商用合规对照表
第二个是性能坑。开源项目放出来的版本,大多是适配demo场景的,能跑通就行,根本没做工业级优化。我前年帮一家头部电商做商品图文审核,一开始图便宜,用了某热门开源的多模态检测模型,本地测试集准确率97%,看着挺完美。结果上线第三天大促,高峰并发一上来,延迟直接飙到2秒,比要求的200ms差了十倍,把负责运营的小姑娘急得在会议室掉眼泪。最后我们团队折腾了一个多月,做算子融合、INT4量化、推理引擎重构,才把延迟压到要求以内,前前后后花的人力成本,比买商用授权贵了三倍都不止。
第三个是维护坑。很多热门开源项目,背后其实就是两三个学生做毕业设计,人家毕业项目一交,直接停更。你线上跑着,哪天出了安全漏洞,翻遍仓库找不到人,发issue半年没人回,叫天天不应叫地地不灵。之前有个做金融的朋友,他们核心系统用的某个开源中间件,出了漏洞找不到人修,最后花了几十万请国内的开源服务商做紧急维护,才把坑填上。
把开源技术用出价值的核心逻辑
把开源技术用出价值的核心逻辑
说了这么多坑,不是让大家别用开源。恰恰相反,现在这个时代,不会用开源技术,根本做不出快的成果。关键是怎么用,这里头有门道。
做科研的朋友,记住一点:把你的核心精力放在真创新上,轮子能用开源就用开源。你一个博士生,五年学制,花两年从零写一个深度学习框架,写出来性能还不如PyTorch,图什么?有这时间你多做十组实验,多挖几个真问题,不比造轮子有用?当然,你要是本身研究方向就是做框架,那当我没说。
做产业落地的朋友,记住第二点:基础能力用开源,核心竞争力攥在自己手里。我认识一家做农业自动驾驶的创业公司,他们做田间感知用的基础重建框架就是开源的Nerfstudio,但是针对农田复杂光影、动态作物的优化算法,是自己做的,申请了专利,这就是对的。既省了至少两年的研发时间,躲过了行业窗口,核心技术又捏在自己手里,不会被卡脖子。
不过话说回来,现在国内的开源生态真的越来越好,前几年大家都是用国外的开源项目,现在很多国内高校和大厂做出来的成果,都直接开源,不少项目在全球都排得上号。去年全球Top 100热门开源项目里,中国贡献的已经有二十多个了,这个变化真的太大了。
说白了,开源的本质是什么?就是众人拾柴火焰高,你用我的,我用你的,大家都不用重复造轮子,把精力花在真正的创新上,整个行业的进步速度自然就提上来了。
别干那种拿开源改个名就说自己自研的丑事,也别为了所谓的“全自研”非要从零造轮子浪费时间。拎清楚,借力,然后长出自己的东西,这才是开源技术应用的正确打开方式。