从新药研发到古生物复原,科学计算应用早已跳出实验室
上个月跟做创新药研发的发小吃饭,酒过三巡他掏出手机给我看一个项目进度,今年刚启动的新靶点抗癌药,不到三个月已经筛出了12个候选化合物。放在十年前,这一步至少要三年。靠什么?不是堆了几百个实验员通宵干活,是靠科学计算提前筛掉了99%没用的分子。
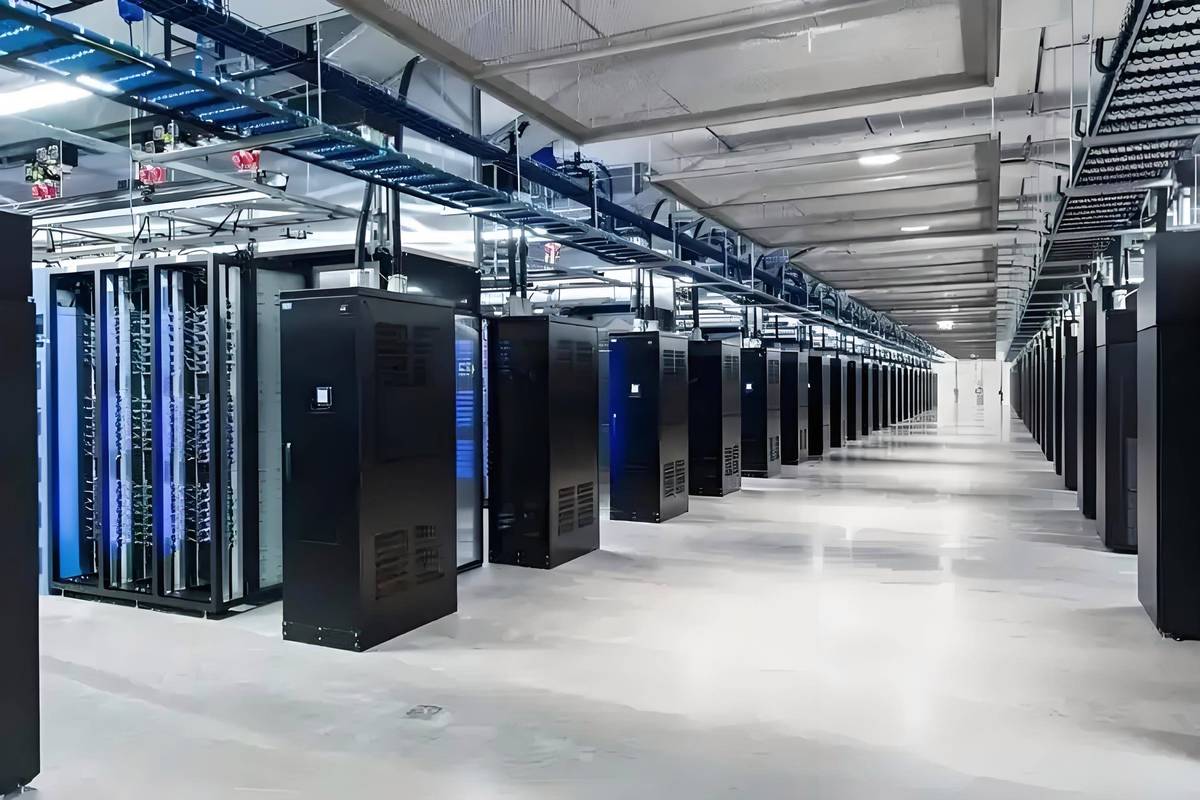 药企研发中心科学计算服务器集群
以前很多中小团队觉得科学计算贵,碰不起,毕竟买服务器、付商业软件授权都是不小的开销。这几年云原生科学计算平台起来了,按计算量付费,算一次小分子对接也就几百块,小创业团队也能玩得起。门槛早就没了。
 科学计算模拟霸王龙运动受力分析图
还有更绝的,敦煌研究院用科学计算修复壁画。几百年的壁画,颜料氧化、酥碱风化,很多地方原来的颜色都看不清了。原来修复全靠老师傅根据经验补,免不了有误差。现在用科学计算模拟壁画几百年来的风化、氧化过程,倒推出来千年前原来的颜色和线条,给修复师傅做参考,还原度比原来高了不是一点半点。
今年年初吵得沸沸扬扬的室温超导争议,两边打擂台拿出来的第一批结果,全都是科学计算算出来的。一方说LK-99的结构确实能实现零电阻,一方说杂质才是零电阻的原因,就算最后结论要实验拍板,但你看,科学计算已经能抢在实验前面给方向了,这放在二十年前提都不敢提。
科学计算的本质,就是给人类的探索开了加速器,把原来需要几代人试错的事,压缩到几年甚至几个月。
 科学计算应用落地,还有几道坎要跨
发展快是快,真要铺开,问题还不少。
第一个就是壁垒。高校实验室攒了一堆顶流的模型,锁在自己的服务器里,企业拿不到,想用好模型还得重新花钱买商业授权,贵得离谱。反过来,企业手里有大量真实的实验数据,因为保密的原因,也没法开放给学术界优化模型,两边卡在这儿,很多好成果躺在实验室落灰。
第二个,就是人才缺口大到离谱。懂行业的不会算,会编程的不懂行业,这是现在行业里普遍的问题。科学计算不是你会跑个开源软件就行,你得懂你算的东西背后的物理规律、行业需求,调参数改模型都要行业积累。我认识一个做计算材料创业的老板,去年跟我吐槽,挖一个能独当一面的资深计算研究员,开百万年薪都挖不到,整个国内能符合要求的也就那么几百号人,缺口多大可想而知。
不过话说回来,现在大模型火了之后,反而给科学计算打开了新路子。很多人说大模型会取代科学计算?不对,大模型是统计拟合,科学计算是从第一性原理出发推演,两者根本不是替代关系,是互补。现在已经有不少团队把大模型和科学计算结合,用大模型加速求解过程,速度能提几十倍,精度还不掉,这个方向已经出了不少好成果。
前几天刷新闻,我们自己的量子计算原型机九章三号又刷了世界纪录,处理高斯玻色取样比最快的超级计算机还快亿亿亿倍。未来算力还会涨不知道多少倍,那些现在我们想都不敢想的应用,再过十年说不定就成了行业里人人都用的标配。你说呢?
别把科学计算当成科研圈的小众玩具
很多人对科学计算的印象,还停留在老电影里,实验室角落堆着占满整间屋子的大型机,只有顶尖高校的教授才能用,算个数据要等好几天,出来给论文凑引用。 早不是这样了。 说实话,现在科学计算早就渗透到了你能想到的所有实体行业研发环节。我去年参观江苏一家做动力电池正极材料的工厂,技术总监跟我算过一笔账:原来试一个新材料配方,从合成到测性能,一次就要20天,成本小三十万,一年最多试几十个配方。现在呢?先用科学计算模拟晶体结构、锂离子迁移率,还有循环衰减的速率,先把一看就不行的配方全筛掉,剩下不到10%再拿去做实验。一年研发成本直接砍了45%,出成果的速度翻了三倍。药企研发中心科学计算服务器集群
以前很多中小团队觉得科学计算贵,碰不起,毕竟买服务器、付商业软件授权都是不小的开销。这几年云原生科学计算平台起来了,按计算量付费,算一次小分子对接也就几百块,小创业团队也能玩得起。门槛早就没了。
那些你绝对想不到的跨界科学计算应用
除了航天、新药、新能源这些大家耳熟能详的领域,科学计算早就跨界玩出花了。 我之前刷到过中国古脊椎动物研究所的一个研究,用来还原霸王龙的运动方式。原来古生物学研究,全靠化石骨头猜,霸王龙的肌肉怎么附着?走路的时候重心在哪里?能不能跑?吵了几十年没结论。现在呢?把化石扫描的三维数据输进去,用科学计算模拟肌肉受力、骨骼承重,一步一步推演运动过程,直接就出结论了——原来成年霸王龙根本跑不起来,体重太大,膝盖承受不住奔跑的冲击力,最快也就走路比常人稍快一点。科学计算模拟霸王龙运动受力分析图
还有更绝的,敦煌研究院用科学计算修复壁画。几百年的壁画,颜料氧化、酥碱风化,很多地方原来的颜色都看不清了。原来修复全靠老师傅根据经验补,免不了有误差。现在用科学计算模拟壁画几百年来的风化、氧化过程,倒推出来千年前原来的颜色和线条,给修复师傅做参考,还原度比原来高了不是一点半点。
今年年初吵得沸沸扬扬的室温超导争议,两边打擂台拿出来的第一批结果,全都是科学计算算出来的。一方说LK-99的结构确实能实现零电阻,一方说杂质才是零电阻的原因,就算最后结论要实验拍板,但你看,科学计算已经能抢在实验前面给方向了,这放在二十年前提都不敢提。
科学计算的本质,就是给人类的探索开了加速器,把原来需要几代人试错的事,压缩到几年甚至几个月。
科学计算应用落地,还有几道坎要跨
科学计算应用落地,还有几道坎要跨
发展快是快,真要铺开,问题还不少。
第一个就是壁垒。高校实验室攒了一堆顶流的模型,锁在自己的服务器里,企业拿不到,想用好模型还得重新花钱买商业授权,贵得离谱。反过来,企业手里有大量真实的实验数据,因为保密的原因,也没法开放给学术界优化模型,两边卡在这儿,很多好成果躺在实验室落灰。
第二个,就是人才缺口大到离谱。懂行业的不会算,会编程的不懂行业,这是现在行业里普遍的问题。科学计算不是你会跑个开源软件就行,你得懂你算的东西背后的物理规律、行业需求,调参数改模型都要行业积累。我认识一个做计算材料创业的老板,去年跟我吐槽,挖一个能独当一面的资深计算研究员,开百万年薪都挖不到,整个国内能符合要求的也就那么几百号人,缺口多大可想而知。
不过话说回来,现在大模型火了之后,反而给科学计算打开了新路子。很多人说大模型会取代科学计算?不对,大模型是统计拟合,科学计算是从第一性原理出发推演,两者根本不是替代关系,是互补。现在已经有不少团队把大模型和科学计算结合,用大模型加速求解过程,速度能提几十倍,精度还不掉,这个方向已经出了不少好成果。
前几天刷新闻,我们自己的量子计算原型机九章三号又刷了世界纪录,处理高斯玻色取样比最快的超级计算机还快亿亿亿倍。未来算力还会涨不知道多少倍,那些现在我们想都不敢想的应用,再过十年说不定就成了行业里人人都用的标配。你说呢?