隐私计算技术:拿不到数据,却能用尽数据价值的黑魔法
上次跟做算法的老陈吃饭,他拍着桌子吐槽,说现在做项目简直是戴着镣铐跳舞。想跟别的机构合作做模型,用户原始数据碰一碰,分分钟触犯合规红线,不碰吧,没有足够的数据,模型精度差得没法用,这不就是死局吗?
我给他说,你咋还不知道隐私计算?这玩意儿就是专门解这个死局的。
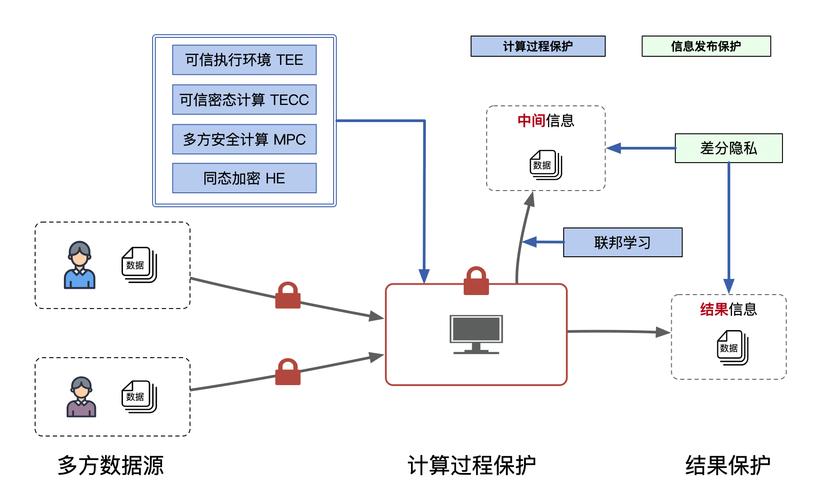 隐私计算数据可用不可见流程示意图
现在圈内主流的技术路线分三种,联邦学习、安全多方计算、可信执行环境。天天有人吵哪个才是未来,我就觉得好笑,本来就是各干各的活。联邦学习适合跨机构大模型训练,现在大厂合作用得最多;安全多方计算不用依赖硬件,纯软件就能实现,适合小数据量的高敏感计算;可信执行环境速度快,就是得靠专门的硬件芯片,对成本有要求。
说白了,能解决问题的就是好的,没必要非要分个高下。说实话,很多创业公司上来就说自己全栈通吃,十项全能,哪有那个功夫?大多是盯着一个场景挖透了,吹牛逼的水分不少,别信那种宣传。
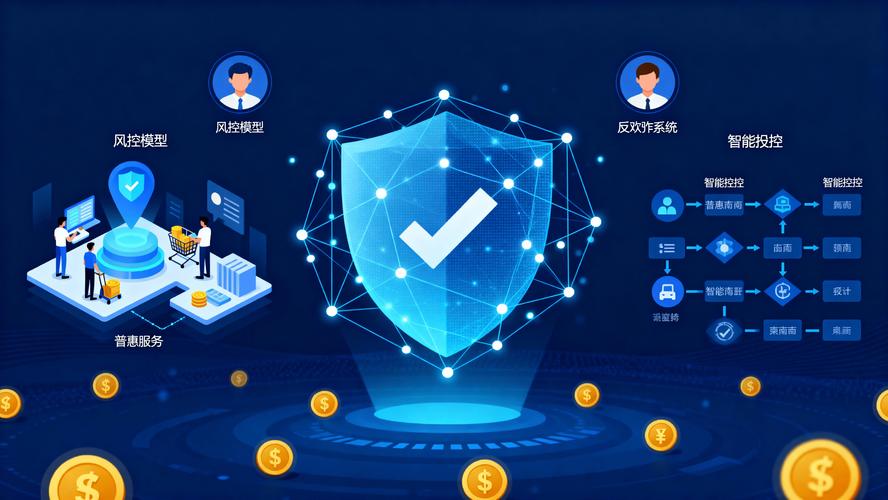 金融行业隐私计算联合风控落地场景图
不过话说回来,隐私计算这些年的进步真的超出很多人的预期。早几年大家吐槽最多的就是性能差,跑一个小模型都要几个小时,根本用不了。这两年算法层面的优化,加上GPU、专用芯片的硬件加速,现在训练速度比五年前快了快一百倍,千亿甚至万亿参数的大模型,也能跑起来了。
当然也不是所有场景都适合,很多中小企业上来就想搭一套隐私计算平台,纯属浪费钱,你的数据量都不够,根本没必要凑这个热闹,别被厂商割了韭菜。
 别神化,隐私计算也不是绝对安全的银子弹
现在很多厂商做宣传,把隐私计算吹成了绝对安全的万能钥匙,只要用了隐私计算,就再也不会有数据泄露问题。这纯粹是忽悠外行。
哪有绝对的安全?举个例子,现在用得最多的横向联邦学习,最近五六年学术界已经发现了好几种梯度反推攻击,就是通过模型训练过程中传出来的加密梯度,反推出来原始训练数据的明文信息。去年国内还有顶尖高校的团队发了论文,针对图像数据的反推成功率能到九成以上,细思极恐对吧?可信执行环境呢,依赖硬件,如果硬件本身存在漏洞,那整个可信环境就等于开门揖盗,去年不也爆出过好几个TEE的硬件漏洞吗?
所以现在业内现在都在讲隐私计算的原生安全设计,不是说你套个隐私计算的壳就安全了,从算法设计开始就要把攻防考虑进去,上线之后还要持续做安全测评,哪有一劳永逸的事儿?
不过话说回来,瑕不掩瑜。这个技术本身刚好踩中了现在数据要素市场化的需求,国内现在几十个数据交易所,哪家不标配隐私计算节点?数据要流通,不能裸奔,不能卖原始数据,卖的是数据的使用价值,计算出来的结果,隐私计算就是这个过程的基础设施,这个定位谁也替代不了。
前阵子看业内的报告,今年国内隐私计算的市场规模就能突破六十亿,未来三年还能保持百分之五十以上的增速,已经不是炒出来的泡沫了,是真真实实的需求推着走。
以后说不定我们每个人都能享受到这个技术的好处,你想用你的出行数据、消费数据换点优惠券、换点会员权益,根本不需要把你的个人数据给商家,算完你该拿的好处拿到了,数据还是留在你自己手里,想想是不是挺棒的?路走对了,剩下的就是慢慢往前走了。
别被名词唬住,隐私计算的核心就一句话
很多人一听技术名词就头大,其实一句话就能说清楚:数据可用不可见。就这么简单。 举个例子,你是银行,我是电商,你有用户的还款记录,我有用户的消费记录,我们都想给用户做更准的信用评分,但是我们谁都不能把自己的用户数据给对方,违法的。放到十年前,这事儿根本成不了。现在用隐私计算,我们不用交换原始数据,各自在本地做计算,只把中间的加密结果传给对方,最后合起来出一个模型,效果跟我们把数据放一块训练出来的差不多,谁都拿不到对方的原始数据。完美。隐私计算数据可用不可见流程示意图
现在圈内主流的技术路线分三种,联邦学习、安全多方计算、可信执行环境。天天有人吵哪个才是未来,我就觉得好笑,本来就是各干各的活。联邦学习适合跨机构大模型训练,现在大厂合作用得最多;安全多方计算不用依赖硬件,纯软件就能实现,适合小数据量的高敏感计算;可信执行环境速度快,就是得靠专门的硬件芯片,对成本有要求。
说白了,能解决问题的就是好的,没必要非要分个高下。说实话,很多创业公司上来就说自己全栈通吃,十项全能,哪有那个功夫?大多是盯着一个场景挖透了,吹牛逼的水分不少,别信那种宣传。
从资本风口到真落地,现在隐私计算都用在了哪
前几年隐私计算还是资本圈炒的概念,很多人觉得这玩意儿就是蹭数据合规的热度,落不了地。这两年不一样了,真刀真枪的项目越来越多。 最成熟的肯定是金融行业。监管对金融数据合规要求有多严就不用说了,之前很多银行跟互联网平台合作引流,只能拿到粗略标签,拿不到原始数据,想做风控根本做不准。用隐私计算联合建模,银行不用拿到用户的互联网行为明文,就能把这些行为特征用到风控模型里。我接触到的某股份行,去年上线的项目,坏账率直接降了八个百分点,一年省下的坏账钱就覆盖了几年的技术成本,这能不香吗? 然后是医疗行业。更典型了。药企研发新药,需要大量的临床数据训练模型,可是每家医院的病历都是敏感数据,不可能随便给你,不同地区的医院数据也不可能整合到一起。用隐私计算,几十家医院可以联合建模,原始数据都留在各自医院,最后出来的模型效果比单一家医院训练的好太多,研发周期能缩短不少。金融行业隐私计算联合风控落地场景图
不过话说回来,隐私计算这些年的进步真的超出很多人的预期。早几年大家吐槽最多的就是性能差,跑一个小模型都要几个小时,根本用不了。这两年算法层面的优化,加上GPU、专用芯片的硬件加速,现在训练速度比五年前快了快一百倍,千亿甚至万亿参数的大模型,也能跑起来了。
当然也不是所有场景都适合,很多中小企业上来就想搭一套隐私计算平台,纯属浪费钱,你的数据量都不够,根本没必要凑这个热闹,别被厂商割了韭菜。
别神化,隐私计算也不是绝对安全的银子弹
别神化,隐私计算也不是绝对安全的银子弹
现在很多厂商做宣传,把隐私计算吹成了绝对安全的万能钥匙,只要用了隐私计算,就再也不会有数据泄露问题。这纯粹是忽悠外行。
哪有绝对的安全?举个例子,现在用得最多的横向联邦学习,最近五六年学术界已经发现了好几种梯度反推攻击,就是通过模型训练过程中传出来的加密梯度,反推出来原始训练数据的明文信息。去年国内还有顶尖高校的团队发了论文,针对图像数据的反推成功率能到九成以上,细思极恐对吧?可信执行环境呢,依赖硬件,如果硬件本身存在漏洞,那整个可信环境就等于开门揖盗,去年不也爆出过好几个TEE的硬件漏洞吗?
所以现在业内现在都在讲隐私计算的原生安全设计,不是说你套个隐私计算的壳就安全了,从算法设计开始就要把攻防考虑进去,上线之后还要持续做安全测评,哪有一劳永逸的事儿?
不过话说回来,瑕不掩瑜。这个技术本身刚好踩中了现在数据要素市场化的需求,国内现在几十个数据交易所,哪家不标配隐私计算节点?数据要流通,不能裸奔,不能卖原始数据,卖的是数据的使用价值,计算出来的结果,隐私计算就是这个过程的基础设施,这个定位谁也替代不了。
前阵子看业内的报告,今年国内隐私计算的市场规模就能突破六十亿,未来三年还能保持百分之五十以上的增速,已经不是炒出来的泡沫了,是真真实实的需求推着走。
以后说不定我们每个人都能享受到这个技术的好处,你想用你的出行数据、消费数据换点优惠券、换点会员权益,根本不需要把你的个人数据给商家,算完你该拿的好处拿到了,数据还是留在你自己手里,想想是不是挺棒的?路走对了,剩下的就是慢慢往前走了。