聊聊联邦学习技术:打破数据孤岛的隐形破局者
上周跟做消费金融风控的老陈喝咖啡,一口冰美式下去,他连叹三口气。手里攥着三百万本地用户的还款数据,隔壁城商行有两百万,本地运营商又有五百万用户的行为数据,大家坐在一起聊了八次联合建模,次次聊死。谁敢动原始数据?现在合规卡得这么死,出了问题负责人要丢饭碗的。这不就是国内大多数行业都绕不开的数据孤岛死结吗?直到有人把联邦学习技术摆到台面上,大家才突然反应过来——原来还能这么玩。
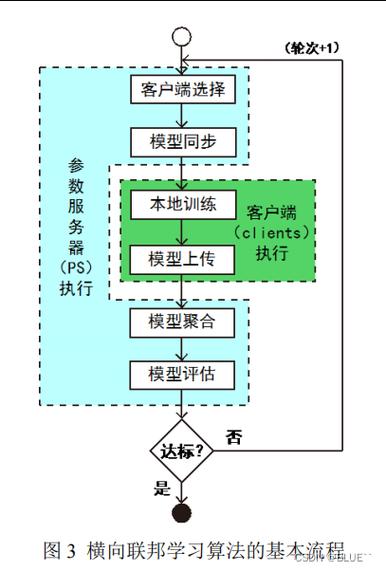 联邦学习横向联合建模流程图
说实话,最早我听圈内人说这个技术的时候,我还以为是实验室圈钱的概念。直到前年看到某股份制银行公开的落地数据,用联邦学习和本地商家、运营商联合训风控模型,通过率提了16%,坏账率降了7.8%,真金白银的收益摆在那,我才服了。这不是花架子,是真能解决问题的东西。
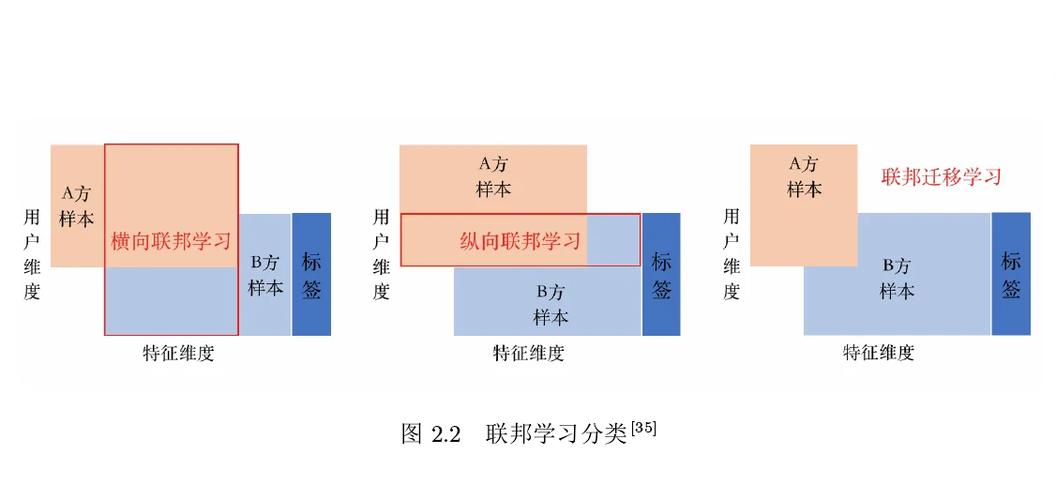 横向纵向联邦学习场景对比图
不过话说回来,现在联邦学习也不是完美的。落地的时候坑也不少。比如十几个机构一起联合训练,每次迭代都要传输参数,通信开销大得吓人,训练速度比集中式训练慢好几倍,这还是小事。更麻烦的是安全问题,虽然原始数据不出来,现在已经有研究证明,恶意参与者可以通过窃取的梯度信息反推原始用户数据,虽然概率不高,但对于金融、医疗这种要求极高安全等级的场景,还是得补安全手段。
现在行业的解法一般是结合差分隐私、同态加密这些技术,给梯度再加一层保护,虽然会牺牲一点模型效果,但安全等级上去了,大部分场景也能接受。
 联邦学习技术接下来会往哪冲?
我最近翻了好几篇今年顶会的论文,又跑了两个行业小沙龙,最大的感受就是,联邦学习接下来两年会往两个方向爆。
第一个方向就是和大模型深度绑定,尤其是行业大模型。现在医疗行业已经有不少落地项目了,各家三甲医院的数据都不能出院区,想训一个好的肺癌诊断、影像识别大模型,只能靠联邦学习。去年中山大学附属肿瘤医院联合十多家机构做的肺癌AI诊断模型,用联邦学习训出来的效果,比单家医院训出来的AUC高了21%,这个提升太夸张了。要是没有联邦学习,这个项目根本做不成。
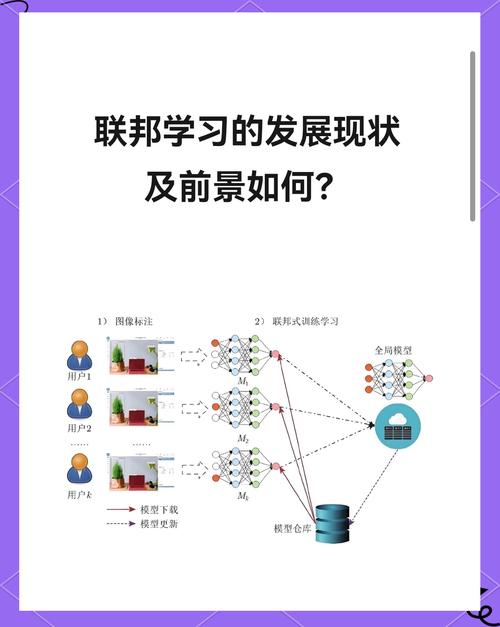
第二个方向就是边缘联邦。现在智能终端越来越多,手机、智能汽车、智能家居都要做个性化模型,之前都是把用户的数据传到云端训,隐私风险大。用边缘联邦,每个终端在本地训,只把更新的参数传到云端聚合,原始数据永远留在用户自己的设备上,既提升了模型的个性化效果,又保护了隐私,现在已经有输入法厂商在测这个方案了,用不了多久大家就能用到。
还有政务场景,现在各地搞数字政府,各个委办局的数据通不动,打通了又怕担责任,联邦学习刚好解决这个痛点,数据所有权还是你的,留在原地,价值挖出来给大家用,谁都不用担风险,很多地方已经开始试点了。
很多人说数据是新时代的石油。可石油埋在各个不同的油田里,抽不出来运不动,那就是废石头。联邦学习就是那个不用把石油挖出来就能炼出汽油的技术,你说它未来能有多大空间?
反正我见过的真落地的项目,已经赚着钱了。剩下的,交给时间就行。
联邦学习技术到底解决了什么要命的问题?
说白了,就是一句话:让数据能用,又不用“裸奔”。 之前行业要联合建模提升效果,路其实只有两条,要么你把数据给我,我把数据给你,大家凑在一起训。要么就是干脆不合作,各自抱着自己那点数据熬。第一条路现在基本走不通,合规红线摆着,哪怕你脱敏了,现在技术手段分分钟能把脱敏数据重新标识出来,风险太大。 联邦学习的思路从根上就不一样。整个训练过程,原始数据永远留在产生它的本地机构,大家只交换训练过程中的模型参数或者梯度信息,原始数据一点都不用往外流。这不就刚好解决了合规和价值的矛盾吗? 举个大家都能懂的例子:银行想做更好的消费信贷风控,自己只有用户的还款历史和存款数据,不知道用户平时网购花钱是什么习惯,电商刚好有消费数据,但不敢给银行。用联邦学习,银行和电商各自在本地训练模型,只把算好的梯度传给第三方协调方,最后训练出来的联合模型,效果比银行单独训好一大截,双方的原始数据一点都没泄露。联邦学习横向联合建模流程图
说实话,最早我听圈内人说这个技术的时候,我还以为是实验室圈钱的概念。直到前年看到某股份制银行公开的落地数据,用联邦学习和本地商家、运营商联合训风控模型,通过率提了16%,坏账率降了7.8%,真金白银的收益摆在那,我才服了。这不是花架子,是真能解决问题的东西。
当下联邦学习技术的落地现状
大模型火了之后,联邦学习的热度又翻了一倍都不止。 之前很多人对联邦学习的印象还停留在中小模型的联合训练,最多就是用来做风控、营销。现在不一样了,几乎所有做隐私计算的厂商,都在推大模型联邦学习方案。 为啥?各个机构都想做自己的行业大模型,但是训大模型需要的数据太多了,单靠一家根本不够,把各家的数据凑到一起又违规。联邦学习刚好卡在这个需求点上,十家机构一起训大模型,数据都留在本地,模型效果大家共享,完美解决问题。 联邦学习现在主流的两个落地方向,对应大家常说的纵向联邦、横向联邦,匹配不同的业务场景。简单说,如果你是两家同类型的机构,比如两个省份的城商行,业务一样,特征一样,只是用户不一样,那就用横向联邦,大家一起把模型训得更准。如果你是不同行业的机构,比如银行加电商加运营商,用户重叠度高,各有各的特征,那就用纵向联邦,把特征拼起来提升模型效果。横向纵向联邦学习场景对比图
不过话说回来,现在联邦学习也不是完美的。落地的时候坑也不少。比如十几个机构一起联合训练,每次迭代都要传输参数,通信开销大得吓人,训练速度比集中式训练慢好几倍,这还是小事。更麻烦的是安全问题,虽然原始数据不出来,现在已经有研究证明,恶意参与者可以通过窃取的梯度信息反推原始用户数据,虽然概率不高,但对于金融、医疗这种要求极高安全等级的场景,还是得补安全手段。
现在行业的解法一般是结合差分隐私、同态加密这些技术,给梯度再加一层保护,虽然会牺牲一点模型效果,但安全等级上去了,大部分场景也能接受。
联邦学习技术接下来会往哪冲?
联邦学习技术接下来会往哪冲?
我最近翻了好几篇今年顶会的论文,又跑了两个行业小沙龙,最大的感受就是,联邦学习接下来两年会往两个方向爆。
第一个方向就是和大模型深度绑定,尤其是行业大模型。现在医疗行业已经有不少落地项目了,各家三甲医院的数据都不能出院区,想训一个好的肺癌诊断、影像识别大模型,只能靠联邦学习。去年中山大学附属肿瘤医院联合十多家机构做的肺癌AI诊断模型,用联邦学习训出来的效果,比单家医院训出来的AUC高了21%,这个提升太夸张了。要是没有联邦学习,这个项目根本做不成。
第二个方向就是边缘联邦。现在智能终端越来越多,手机、智能汽车、智能家居都要做个性化模型,之前都是把用户的数据传到云端训,隐私风险大。用边缘联邦,每个终端在本地训,只把更新的参数传到云端聚合,原始数据永远留在用户自己的设备上,既提升了模型的个性化效果,又保护了隐私,现在已经有输入法厂商在测这个方案了,用不了多久大家就能用到。
还有政务场景,现在各地搞数字政府,各个委办局的数据通不动,打通了又怕担责任,联邦学习刚好解决这个痛点,数据所有权还是你的,留在原地,价值挖出来给大家用,谁都不用担风险,很多地方已经开始试点了。
很多人说数据是新时代的石油。可石油埋在各个不同的油田里,抽不出来运不动,那就是废石头。联邦学习就是那个不用把石油挖出来就能炼出汽油的技术,你说它未来能有多大空间?
反正我见过的真落地的项目,已经赚着钱了。剩下的,交给时间就行。