系统可靠性设计:那些踩过的坑和救命的细节
前几天我们线上一个服务挂了,没啥大不了的——就是那种瞬间流量暴涨,然后整个链路全堵死的经典场景。当时我盯着监控大屏,看着一堆告警跳出来,心里只有一个念头:该来的总会来。
说实话,做系统这行,谁没个半夜爬起来看日志的经历?对吧。但问题在于,很多坑明明可以在设计阶段就避开。今天不聊空话,就聊聊那些真正救命的细节。
一、超时和重试:不是所有等待都值得
你有没有想过,一个请求到底该等多久?很多系统里,调用下游服务时直接没设超时——或者设了个30秒,结果下游一个慢SQL卡了20秒,整个线程池就满了。然后所有新请求排队,然后雪崩。我见过不止一次。
超时时间得合理。不是拍脑袋定,要看你的业务容忍度和下游的延迟曲线。更关键的是——重试必须带上退避策略。别一失败就立刻重试,尤其是在高并发场景下,那相当于给事故火上浇油。
有个朋友跟我吐槽过一句话:重试是把双刃剑,用好了救场,用不好就是二次事故。他们的服务曾经因为重试风暴把整个数据库打挂了。后来加了jitter(随机抖动),才缓过来。
对了,幂等性你懂吧?如果重试的请求不幂等,那后果……下单接口重复执行两次,你试试?所有写操作必须保证幂等,要么靠唯一键,要么靠状态机。这不是建议,这是硬指标。
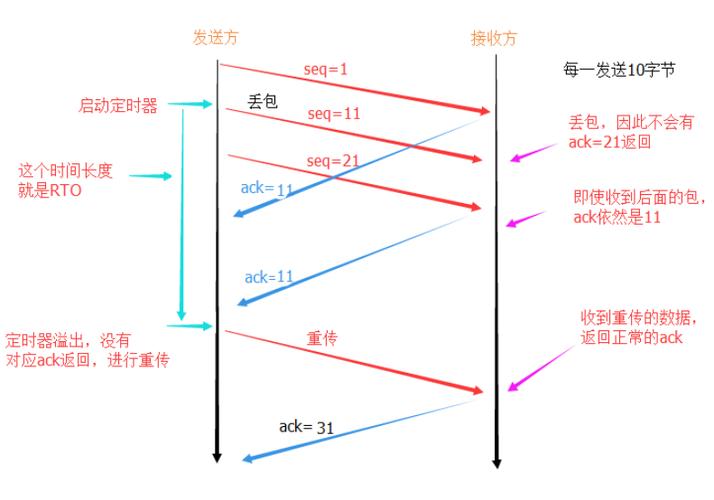 系统可靠性设计超时重试策略图
二、熔断和降级:不是所有功能都非得可用
有时候我真搞不懂,为什么大家总觉得系统每个功能都不能出问题?开玩笑呢?牺牲无关紧要的功能,保住核心链路,这叫断臂求生,不叫认怂。
熔断器的思想很简单:如果下游连续失败达到阈值,直接短路不调用,快速失败。Netflix开源的Hystrix大家都知道,但说实话,现在很多人直接用Resilience4j——轻量,而且支持Reactor栈。
降级就得有取舍。比如双十一的时候,非核心服务(比如商品详情页的个性化推荐)直接降级成默认数据。这事我在上一家公司干过,当时业务方还不太乐意,结果一压测,差点没给大促搞挂。后来所有人都闭嘴了。降级是主动的,别等系统崩了才被动的砍功能。
还有一个坑:熔断器触发后,恢复策略要设计好。别刚熔断个几秒就半开重放流量,下游可能还没缓过来。这里我建议用渐进式的恢复——先放5%的流量,慢慢加到最后全量。
三、故障注入和混沌工程:找茬不是没事找事
你肯定听过那个段子:服务器被管理员一脚踢掉电源。混沌工程就是把这种事故提前演练,而不是等真的发生了才一脸懵。
Netflix的Chaos Monkey有多出名就不用我赘述了。但国内很多团队搞混沌工程,纯粹是走形式——找个服务器杀个进程,然后看一眼监控,完了。这有什么用?真正的混沌工程要验证的是系统在故障下是否还能提供预期的可用性,而不是单纯测试“挂了能不能发现”。
举个例子,你可以杀一个Pod,然后看整个链路是否自动切换;你也可以网络延迟个几百毫秒,然后看依赖方会不会把超时拖垮。这些实验需要在生产环境做才有意义,但在生产环境做又很吓人,对吧?所以得有个红线:比如先从不影响核心业务的小流量开始,或者用影子模式。
我还看过一个研究,说通过故障注入发现了不少隐藏问题——比如证书过期、DNS缓存失效、连接池泄露啥的。这比你在测试环境模拟个“服务器崩了”靠谱多了。
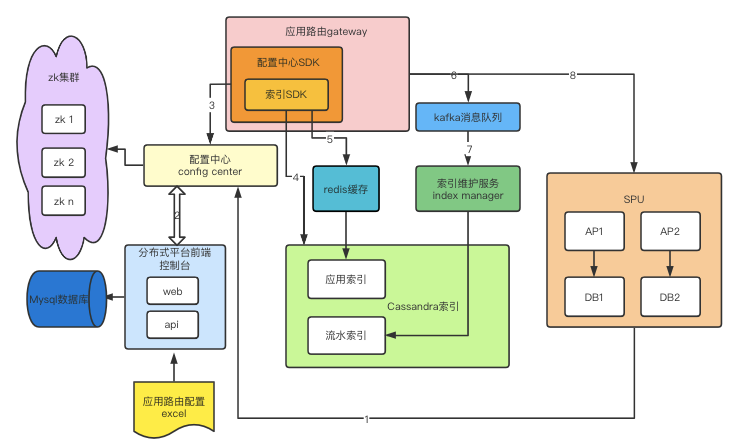 混沌工程故障注入模拟工具链图
四、可观测性:没有数据,谈什么可靠性
如果系统不透明,出了故障你只能干瞪眼。所以埋点、日志、指标、链路追踪,这些不是可选项,是必需品。
但光有监控还不够,关键得有告警阈值。这块我吃过亏:有次一个服务内存泄漏,而我设的告警是CPU超过80%才触发。结果进程OOM了,CPU当然很低——等我反应过来,整个集群都重启过一轮了。告警不能只看单项指标,你得会关联分析。
链路追踪也是个好东西。比如用OpenTelemetry,把一次请求从入口到DB的完整路径都串起来。之前遇到过查询慢的问题,靠链路追踪才发现是某个子服务里做了全表扫描,而调用方根本没注意到单次耗时已经500ms了。
顺便吐槽一下,很多公司的SRE团队天天在告警海里捞针,就是因为他们没有把告警分级。P0/P1/P2弄清楚,别让垃圾告警抢占注意力——否则真出事的时候,人已经麻木了。
五、容量规划:别等车撞墙了才想起刹车
 五、容量规划:别等车撞墙了才想起刹车
可靠性不光靠容错,还得有提前量的规划。容量压测不是做一次就完了,得持续做。
我们当时有个习惯:每次大促前都要做全链路的压力测试,并根据结果调整限流阈值。限流就是保证系统不被打瘫的最后一道防线。令牌桶还是漏桶?都好,但关键是要按业务场景配置限流策略,比如登录接口和搜索接口的限流阈值肯定不一样。
还有一个反直觉的坑:你以为扩容能解决一切?其实有时候扩容反而会引发更多问题——比如缓存击穿,比如分布式锁竞争。前阵子有个新闻,某平台大促时因为过度扩容导致数据库连接数爆了。所以别迷信“加机器”,先搞清楚瓶颈在哪。
六、那些不起眼的细节
 六、那些不起眼的细节
系统可靠性设计里,很多细节看着不起眼,但真能救命。比如时钟同步——很多分布式系统对时间戳敏感,如果机器时钟偏移,可能引发ID冲突或者分布式事务中的时间乱序。
再有就是连接池的设置,这东西太小了,小到没人会在开会时提。但连接池泄漏是线上最常见的故障之一。你最好建立一套连接池监控,比如活跃连接数、等待线程数这些,设置一个阈值,超过就要有告警。
还有,别忽略基础网络。上次我们排查一个诡异的问题——偶尔超时,查了半天代码,最后发现是某个交换机固件有bug。底层基础设施的可靠性,往往比其他层更决定整体可用性,但这恰恰是最容易被忽视的。
最后想吐槽一点:很多团队把可靠性设计当成一个“阶段性任务”,上线前搞一搞,然后就抛到脑后。但我觉得这更像是一种持续演进的习惯——每天都在小步优化,而不是等出了大事才大动干戈。
写到这里,突然想起一个观点,科研上也有个叫“拜占庭容错”的概念,就是假设节点会撒谎,你还能达成共识。放到工程里,这其实是在提醒我们:别信任你依赖的任何一个组件,默认它一定会出问题,然后围绕这个前提去设计。
好了,不扯远了。现在的系统越来越复杂,可靠性设计没有银弹,但那些被验证过的工程实践——超时、重试、熔断、幂等、混沌工程、可观测性……它们组合起来,能让你在凌晨的告警电话里稍微不那么手忙脚乱。
希望下次咱们聊的时候,你不在事故现场。真的。