神经形态计算:当芯片开始模仿大脑,算力故事才真正燃了
我一直觉得,传统计算机就是个死脑筋的会计。你给它一笔票据,它必须按列加减乘除,每一步都清清楚楚,中间不能有半点含糊。这样做有好处,精准嘛。但它也有个致命伤——数据搬运太累了。CPU、内存之间来回倒腾,光路上就耗掉大半能量。这不,一代代芯片堆料换来的性能,最后都变成了散热器的哀嚎。
所以当“神经形态计算”这几个字飘进我耳朵的时候,我第一反应是:这是不是又在吹概念?但后来翻了点资料,发现还真不是。
 神经形态芯片Loihi 2微距架构图
你看,我们的大脑,大约860亿个神经元,每个神经元通过突触和成千上万个同伴相连。这玩意儿不跑时钟,不执行指令,就那么靠脉冲(Spike)传导信息,而且是事件驱动的——有变化才动,没变化就休息。算一下能耗,整个大脑才20瓦左右,相当于一个灯泡。反观现在的AI芯片,训练一次大模型,那电表转得跟电风扇一样。差距不是一点半点。
那神经形态计算到底干嘛?简单说,就是用硬件去模拟神经元的电化学行为,把计算变成脉冲的传播。这里头有几个关键点,咱一个一个唠。
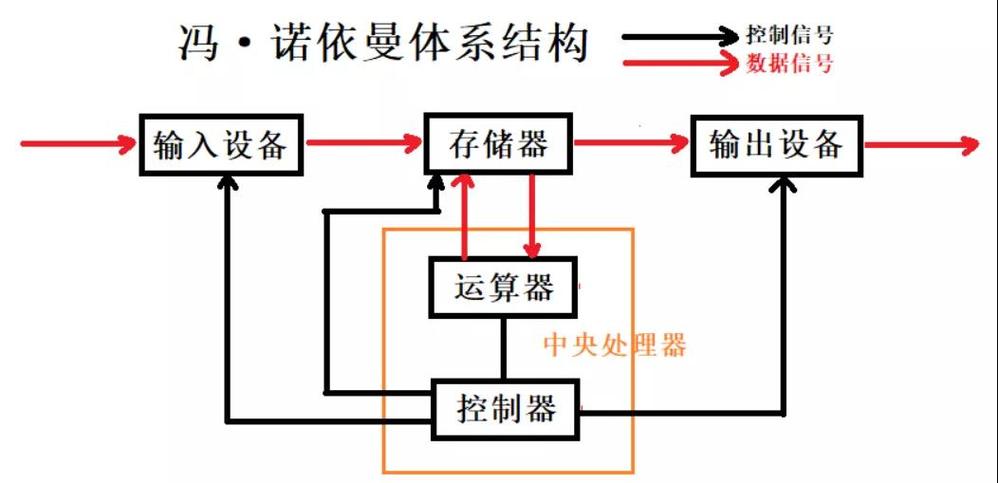 先忘掉冯·诺依曼那一套
学过计组的都知道,冯·诺依曼结构是“存储”和“计算”分开。内存是内存,CPU是CPU,中间通过总线传数据。这在一般人眼里是天经地义的,但效率呢?一个加法运算,可能需要先从内存取指令,再取数据,算完还得存回去。一来一回,瓶颈就出来了。业界叫它“冯·诺依曼瓶颈”。
神经形态芯片完全没这套路。它的存储和计算是搅在一起的,每个突触就像一个小处理器,既能存权重,又能算加权和。这种“存算一体”的思路,直接把数据搬运的成本砍掉了。举个例子,Intel的Loihi 2,一颗芯片上集成了一百多万个神经元,每个神经元只能跟相邻的通信,但就是靠这种分布式协调,硬是把某些优化问题的能耗降了几个数量级。说实话,我第一次看到那组能效比曲线的时候,整个人有点头皮发麻。
 脉冲神经元膜电位与发射示意图
 玩家们都在憋什么大招?
现在这个赛道,说是战国时代一点也不夸张——哦,我是不是用了“毫不夸张”?算了,就是名副其实吧。哈哈,注意不能骂自己。
从IBM的TrueNorth(用的是数字CMOS)到Intel的Loihi系列,再到英国创业公司BrainChip的Akida,各家技术路线不太一样。比如TrueNorth走的纯静态脉冲流水线,Loihi则上了片上学习机制,能实时调整突触参数。这个很厉害,意味着芯片可以在使用场景中自己适应,而不只是跑个固定网络。
还有国内,清华大学的类脑计算研究团队有天机系列,做了个与众不同的混合设计——既能用CNN处理图像,又能用SNN处理时序信号,关键它还兼容现行AI框架。这设计思路挺聪明的,既不放弃传统深度学习的成果,又保留神经形态的灵活性。
不过,冷静下来看看,神经形态计算真正能跟传统GPU杠的场合,目前还很有限。主要原因是它的生态太薄了。你写个PyTorch模型,随便找个GPU就能跑。但你手头要是只有一颗Loihi 2,想跑个Transformer,那对不起,得先跟它的汇编语言亲热亲热。这种痛,只有试过的人才知道。
神经形态芯片Loihi 2微距架构图
你看,我们的大脑,大约860亿个神经元,每个神经元通过突触和成千上万个同伴相连。这玩意儿不跑时钟,不执行指令,就那么靠脉冲(Spike)传导信息,而且是事件驱动的——有变化才动,没变化就休息。算一下能耗,整个大脑才20瓦左右,相当于一个灯泡。反观现在的AI芯片,训练一次大模型,那电表转得跟电风扇一样。差距不是一点半点。
那神经形态计算到底干嘛?简单说,就是用硬件去模拟神经元的电化学行为,把计算变成脉冲的传播。这里头有几个关键点,咱一个一个唠。
先忘掉冯·诺依曼那一套
先忘掉冯·诺依曼那一套
学过计组的都知道,冯·诺依曼结构是“存储”和“计算”分开。内存是内存,CPU是CPU,中间通过总线传数据。这在一般人眼里是天经地义的,但效率呢?一个加法运算,可能需要先从内存取指令,再取数据,算完还得存回去。一来一回,瓶颈就出来了。业界叫它“冯·诺依曼瓶颈”。
神经形态芯片完全没这套路。它的存储和计算是搅在一起的,每个突触就像一个小处理器,既能存权重,又能算加权和。这种“存算一体”的思路,直接把数据搬运的成本砍掉了。举个例子,Intel的Loihi 2,一颗芯片上集成了一百多万个神经元,每个神经元只能跟相邻的通信,但就是靠这种分布式协调,硬是把某些优化问题的能耗降了几个数量级。说实话,我第一次看到那组能效比曲线的时候,整个人有点头皮发麻。
脉冲神经网络:用几滴“雨点”来算数
传统神经网络传播的是实数值,像水流,连续不断。而脉冲神经网络(SNN)用的是一串细碎的脉冲,像雨点砸在地上,只有当累积的膜电位超过阈值才发出一个尖峰。这个机制很微妙——信息不是靠脉冲的幅度,而是靠脉冲的“时间点”和“频率”来编码。你可以理解为摩斯电码,但复杂得多。 这样一来,事件驱动的优势就出来了:没有脉冲的时候,神经元完全不工作,功耗直接归零。而对计算来说,大部分时候整个网络都在“躺平”,所以平均功耗极低。这就是为什么神经形态芯片特别适合边缘计算,比如可穿戴设备里做实时心跳检测,或者无人机上做避障。 但别忘了,训练SNN可不是件容易的事。因为脉冲的发放是离散的、不可微的,传统的反向传播整不动它。于是研究者们想了不少歪招,比如用代理梯度,或者把训练好的传统ANN转换成SNN。这条路还在走,说实话,现在还不是一个“拿来即用”的成熟生态。脉冲神经元膜电位与发射示意图
玩家们都在憋什么大招?
玩家们都在憋什么大招?
现在这个赛道,说是战国时代一点也不夸张——哦,我是不是用了“毫不夸张”?算了,就是名副其实吧。哈哈,注意不能骂自己。
从IBM的TrueNorth(用的是数字CMOS)到Intel的Loihi系列,再到英国创业公司BrainChip的Akida,各家技术路线不太一样。比如TrueNorth走的纯静态脉冲流水线,Loihi则上了片上学习机制,能实时调整突触参数。这个很厉害,意味着芯片可以在使用场景中自己适应,而不只是跑个固定网络。
还有国内,清华大学的类脑计算研究团队有天机系列,做了个与众不同的混合设计——既能用CNN处理图像,又能用SNN处理时序信号,关键它还兼容现行AI框架。这设计思路挺聪明的,既不放弃传统深度学习的成果,又保留神经形态的灵活性。
不过,冷静下来看看,神经形态计算真正能跟传统GPU杠的场合,目前还很有限。主要原因是它的生态太薄了。你写个PyTorch模型,随便找个GPU就能跑。但你手头要是只有一颗Loihi 2,想跑个Transformer,那对不起,得先跟它的汇编语言亲热亲热。这种痛,只有试过的人才知道。