联邦学习技术:我为什么说它是隐私计算里最‘接地气’的野路子
说实话,第一次听到“联邦学习”这四个字,我脑子里蹦出来的是“联邦快递”和“学习机”的混合体。后来在实验室里泡了三个月,啃了十几篇论文,才发现这玩意儿藏着大智慧。今天咱们不聊那些教科书式的定义,我就用大白话,讲讲它到底怎么偷偷把数据“借用”了,还不碰你的隐私。
一、数据不敢搬家?那就让模型去“串门”
你看啊,传统的人工智能训练,就像个霸道总裁——把所有数据拉到自己家里,关起门来训练。但现实是,数据在银行、医院、手机厂商手里,谁愿意把家底交出去?
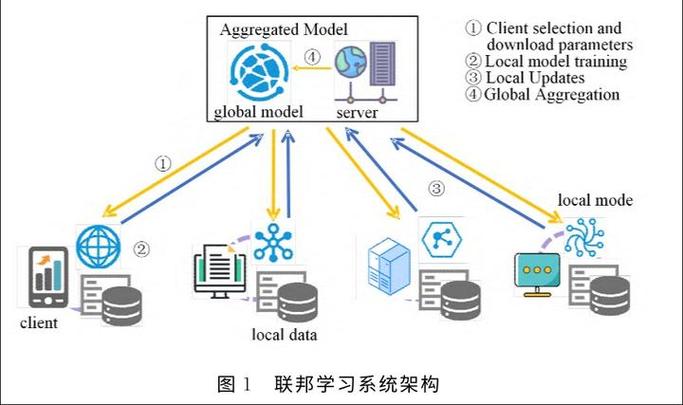
联邦学习不一样。它反着来。数据不动,模型动。每家机构在自己本地训练模型,然后把更新的“参数”或者“梯度”加密传出去。服务器只负责把这些参数汇总,再分发回去。就像一群朋友各自在家做饭,只把菜品的配方发群里共享,最后大家都能吃到满汉全席。
这个思路,当年我看第一眼就拍大腿——绝了!
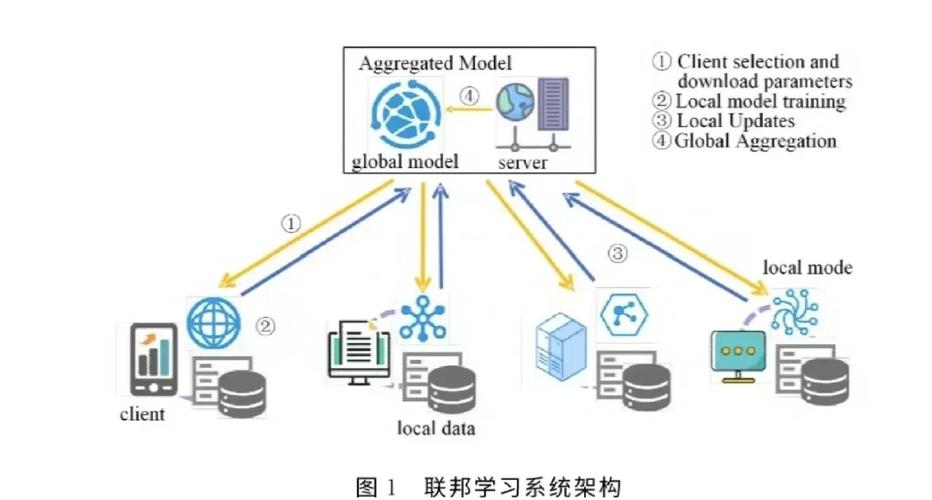 联邦学习架构示意图 数据不出本地 模型参数聚合
但别高兴太早。参数里其实藏着隐私。老话说得好,隔墙有耳,你发出去的梯度,黑客也可能反推出原始数据。所以联邦学习还得搭配一堆花活:同态加密、差分隐私、安全多方计算……
别被这些名词唬住。打个比方:你告诉朋友你晚上吃了辣火锅,这叫“梯度”;但你没说具体是哪家店,因为用了差分隐私加了点“噪音”。效果嘛,就是朋友知道你的大致口味,但记不住你精确的行程。
二、科研圈的“军备竞赛”
 二、科研圈的“军备竞赛”
这几年,联邦学习的论文量跟坐了火箭似的。谷歌、微胖、还有国内的 BAT,都在抢滩。为什么?因为数据法规越收越紧,GDPR、个保法,哪条不是悬在头上的剑?
我最近看了一篇量子位报道的谷歌论文,他们把联邦学习用在了手机输入法上。你打字时的习惯,比如“卧槽”和“我靠”哪个用得多,这些数据根本不用上传。模型就在你手机里学,学完只把“模型更新”交上去。最后输入法越来越懂你的口癖,但你的聊天记录,服务器根本没看过一眼。
你说这玩意儿是不是黑科技?它不黑,它只是聪明。
不过话说回来,联邦学习也不是万灵药。通信开销就是个无底洞。你想想,给十万台手机每轮都传几百MB的参数,那流量费谁出?所以现在很多研究都放在压缩通讯上。有的论文甚至用“三元组”来更新,就传那几个数字,简直抠门到了极致。
三、我从一个失败项目里悟出的坑
去年我们团队接过一个医疗项目,想用联邦学习做多中心肺结节识别。当时以为抱上大腿了,结果做了一半差点翻车。
医院A数据是CT影像,医院B只有病历文本,医院C干脆只有几页PDF。数据格式五花八门,模型结构根本统一不了。这就好比让北京人、上海人和广东人合伙做一桌菜,一个要卤煮,一个要生煎,一个要白切鸡——吵起来了。
后来我们用了一个变种叫“联邦迁移学习”,算是勉强解决了。但这经历让我明白:联邦学习不是即插即用的 USB,它需要极强的工程整合能力。
 联邦学习数据非独立同分布示意图 医疗场景
另外,安全攻防也是大坑。最近有篇论文展示了“梯度反演攻击”,你发出去的梯度,居然能直接还原出一张清晰的人脸图像。我当时看到那图,冷汗都下来了。所以啊,联邦学习一定要搭配差分隐私或者安全聚合,不然就是裸奔。
四、落地场景:哪些行业在偷着乐?
 四、落地场景:哪些行业在偷着乐?
金融领域最积极。几家银行想联合反欺诈,但客户流水是机密。联邦学习让它们在不共享数据的前提下,共同训练一个欺诈识别模型。比如 A 行发现某个 IP 段频繁操作,B 行发现同一 IP 也在自家系统里试探,两个本地模型一聚合,就能提前拦截。
还有智能交通。车联网数据太敏感了,你的轨迹、车速、刹车习惯,这些要是上传到云端,谁敢开?联邦学习让每一辆车在本地学习驾驶习惯,然后只把“怎么避障”的经验分享给车队,车自己越开越聪明,但行踪数据始终留在本地。
听说有的城市已经在试点“城市大脑”用联邦学习打破部门壁垒。想想就激动,但没有隐私焦虑的智慧城市,才是真正的未来。
五、未来?别吹上天,但确实有戏
 五、未来?别吹上天,但确实有戏
有人说联邦学习是银子弹,我呸。它目前最大的问题是“参与者的激励”。凭啥我贡献数据训练模型,你赚钱?所以现在有“联邦学习+区块链”,搞什么“贡献度证明”代币。这我倒是觉得有点意思,但别指望一夜暴富。
而且,联邦学习框架五花八门。TensorFlow Federated,PySyft,FATE,还有各种自研的。标准还没统一,就像当年 VHS 和 Betamax 之争,最终谁胜出,还得看生态。
不过我个人乐观。因为隐私计算这个大方向不会变,联邦学习是里面最务实的一条路。它不要求你彻底放弃数据主权,就能享受 AI 的红利。这不就是人类偷懒的智慧吗?
好了,我手都酸了。今天这篇算是真心话大杂烩。你要是刚入门,别被论文里的公式吓跑。找个开源框架,跑个 MNIST,看看它到底怎么“联邦”的。然后你也会像我一样,一边骂它难搞,一边又觉得……还挺香。真的。