计算机视觉技术:从实验室到我家门锁的奇幻漂流
说实话,我每天刷脸解锁手机的时候,偶尔会恍惚一下——这玩意儿到底是怎么认出我的?就手机那点算力,怎么就能在0.1秒内搞定一大堆数学计算,还偏偏认准了我这个三天没刮胡子的人?
后来我看了篇论文,才知道原来人脸识别这套东西,背后是三个神经网络在打架。一个负责找脸,一个负责把脸掰正,还有一个负责提取特征。你就说绕不绕吧!但更离谱的是,这套技术现在竟然已经便宜到可以塞进几十块钱的智能门锁里了。真不知道是该夸技术牛逼,还是该骂它内卷。
一、从“看图猜字”到“看穿一切”
早年的计算机视觉,说白了就是个死板的学生。你给它看张猫的图片,它只会记住这张图片里每个像素的颜色,换个角度它就蒙圈了。那时候做物体识别,全靠人工设计特征,比如边缘啦、纹理啦、颜色直方图啦……就跟你小时候背单词一样,死记硬背,换本单词书就废了。
后来深度学习一来,画风突变。卷积神经网络(CNN)直接把“看图”这事儿变成了“自动找规律”。你不跟它说什么是猫,它自己看几万张猫图,就知道“猫”长啥样了。那种感觉,就像你突然学会了开挂——但开挂归开挂,它还是容易犯二。你给它看张沙发,它可能认成猫,因为沙发上正好有只猫。这种傻事,现在也在发生。
但是话说回来,这几年技术迭代确实猛。尤其是Transformer架构杀进视觉领域之后,计算机视觉技术已经不再局限于“识别”了,它开始“理解”场景。比如,它能看出“一个人在马路上骑车”和“一个人在马路上骑单车”是同一件事,甚至能猜出下一秒那个人会不会拐弯。这种能力,就是现在自动驾驶、机器人抓取的核心。
最让我惊讶的是,现在的视觉模型居然开始具备“常识”了。比如你给AI看一张厨房的图,它能推测出灶台上正在烧水,水壶旁边还有一盒方便面。说实话,这已经不是视觉了,这是“脑补”。但脑补也有翻车的时候,比如它可能把一盆绿萝当成西兰花——这就很尴尬了。
二、数据标注:那些被活活累死的“人肉AI”
 二、数据标注:那些被活活累死的“人肉AI”
你可能会问,计算机视觉技术这么牛,是不是搞算法的都是神仙?错!真正的大头在数据标注。整个行业里有一群最底层的标注员,每天对着屏幕框出猫、框出新、框出红绿灯。他们的工作就是把“猫”这个词和一堆像素绑在一起。要不是这些人,你手机里的美颜相机根本不知道哪里是鼻子,哪里是脸。
我之前去一个数据标注公司参观过,那场景,真是绝了。一个小房间,十几台电脑,每个人面前都是密密麻麻的框和标签。有个妹子跟我说,她一天要标注三千多个“人行道”,眼睛都快瞎了。更惨的是,有些项目要求标注“骑自行车的人”和“骑电动车的人”要分开——但很多电动车长得跟自行车一个样,你说怎么标?
所以啊,计算机视觉技术的进步,背后是一堆人的“人工智障式劳动”。不过现在也有了一些自动标注工具,用预训练模型先粗标,再让人修正。但说实话,**真正的“零标注”学习,也就是少样本学习、自监督学习,目前还是个望梅止渴的饼。** 但不管怎么说,这个方向确实在带动整个行业往前跑。
三、大模型的“幻觉”与视觉的“现实”
 三、大模型的“幻觉”与视觉的“现实”
2023年那会儿,大语言模型火得一塌糊涂,人人都在聊ChatGPT。但计算机视觉技术没跟上趟,因为视觉信息比文字更难压缩。文字是离散的,一个词就是一个词,像素可不一样,同样的物体换个光照就面目全非。好在后来出现了多模态大模型,把语言和视觉揉在一起,才勉强让机器“看懂”了世界。
不过,这种融合也带来了新问题。大模型会“一本正经地胡说八道”,在视觉任务里就叫“幻觉”。比如你给它看一张斑马线,它能告诉你“这是一条人行横道,通常被画成白色和灰色相间的条纹”,但如果你在斑马线上放一个穿着斑马服的人,它可能会说“这是一只斑马”。这你敢信?反正我是不太敢完全把身家性命交给这种AI。
所以现在的工业界更倾向于“视觉基础模型+规则兜底”的方案。比如自动驾驶,会用视觉模型去感知周围环境,但关键决策还得靠手写的逻辑规则来兜底。毕竟,你不想因为一个视觉bug,让车直接撞上消防栓对吧?
四、落地场景:从工厂到菜市场
 四、落地场景:从工厂到菜市场
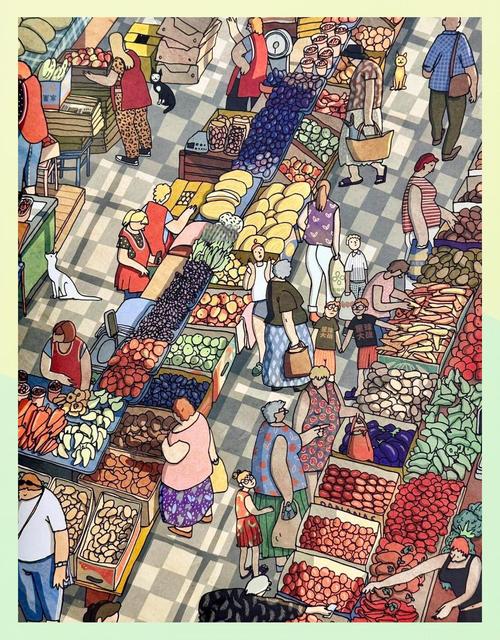
别看科研圈天天刷榜,真正把计算机视觉技术用出花来的,其实是工厂和农业。
我有个朋友在苏州做工业质检,他们用一套视觉系统检查电路板上的焊点。以前靠人工,一个质检员一天看几千块板子,眼睛都快瞎了,漏检率还高。现在换了视觉系统,缺陷检测的准确率达到99.8%,而且一天能看几万块板子。他说最爽的是,机器不知疲倦,不会因为加班到晚上就情绪崩溃。但机器也矫情,稍微有点灰尘就报警,搞得车间里比手术室还干净。
农业这边更有意思。有人用计算机视觉给芒果分级,按颜色、大小、瑕疵自动分拣。还有人用无人机飞过农田,拍几张照片就能识别出哪块地缺水、哪片叶子染了病。我见过一个案例,用视觉识别猪的体重——不用把猪赶出圈,直接拍张照,算法就能估算出重量。听着挺玄乎,但据说误差只有5%。养猪户再也不用扛着猪上秤了,这画面想想都好笑。
当然,也有翻车的。比如某家超市的自动结账摄像头,把顾客脑袋上的光头识别成了“蛋”。于是系统自动给顾客加购了两斤鸡蛋……后来超市不得不给摄像头加了个“人体部位过滤器”。
五、最头疼的事:隐私与“偏见”
 五、最头疼的事:隐私与“偏见”
计算机视觉技术落地最大的拦路虎,不是性能不够,而是隐私伦理。街上的摄像头越来越多,刷脸支付越来越常见——你真的愿意让每个商家都存你的面部特征吗?反正我很不舒服。
更让人头疼的是“算法偏见”。有些视觉模型在训练数据里种下了无形的地雷——比如训练数据里“教师”这个职业的图片大多是女性,模型就容易把男性教师自动归类为“校长”。这种偏见一旦用在社会监控、招聘筛选中,那可就真成“火上浇油”了。
所以现在很多研究机构都在推“联邦学习”和“差分隐私”。说白了,就是让数据留在本地,模型自己跑过来学,而不是把你的脸传到云端的某个服务器里。这种思路挺好,但技术难度也不小。毕竟,你要在一个只有几兆内存的摄像头上跑出一个还算不错的模型,这本身就是个“螺蛳壳里做道场”的活。
六、未来呢?我也不知道
 六、未来呢?我也不知道
很多人问我,计算机视觉技术下一步会怎么样?我真心不知道。我只知道,现在的视觉模型越来越“聪明”,但离真正的“智能”还差得远。它仍然会犯低级错误,比如把救生圈当成轮胎,把月亮当成路灯。但恰恰是这些不完美,才让人觉得这玩意儿还有学头。
也许再过十年,我们会拥有真正的视觉通用人工智能。它不仅能看出你在做饭,还能帮你把火关小点。但也许那时候,我们也会怀念现在这个偶尔犯二的AI。毕竟,一个不会把光头当成鸡蛋的世界,还是少了点乐趣。
反正我现在用手机刷脸的时候,心里还是会咯噔一下。万一哪天它心情不好,非说我是隔壁老王,那可就真叫天天不应了。