强化学习技术:那些让算法从混沌到智能的瞬间
第一次跑DQN的时候,我盯着屏幕上一个连直线都走不稳的小方块,一度怀疑人生。这玩意儿真的能学会玩Atari游戏?几小时后,它居然绕过了所有障碍,还学会了贪吃套路。那种感觉,怎么说呢,有点像看着自家狗子第一次自己开门跑出去——既骄傲又心酸。
说实在的,强化学习这一行,门外看到的都是“智能涌现”的光环,门内的人却天天在跟奖励函数、探索策略和算力较劲。今天我不打算给你堆公式,咱们就聊聊这个领域里那些让人崩溃又着迷的瞬间。
先解释一下这玩意儿的粗暴逻辑:让智能体跟环境反复互动,每次做出动作,环境给个评价——可以是得分,也可以是惩罚。智能体不断调整自己的策略,让长期累积的奖励最大化。没有标准答案,没有现成数据集,一切全靠试错。听起来是不是跟人类社会很像?对,所以它比传统监督学习更“野”。
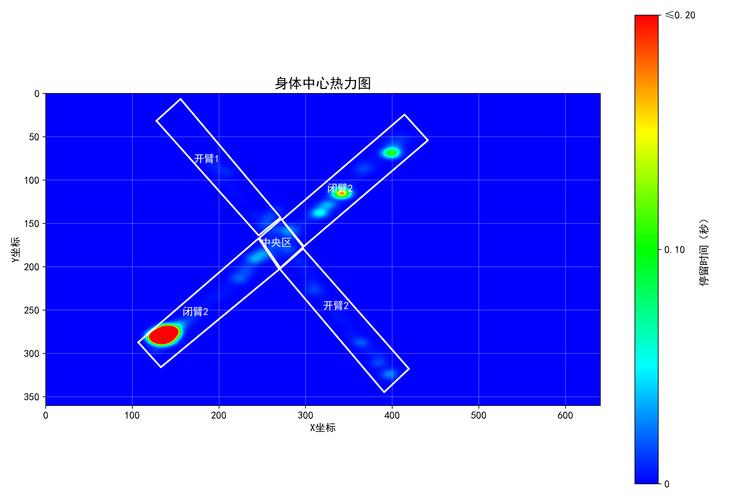 强化学习智能体在迷宫中探索的路径热力图
但话说回来,也正是这种“折腾”,才让强化学习显得格外真实。它不像监督学习那样“照本宣科”,而是真的去碰撞这个世界,体会一路的跌跌撞撞。
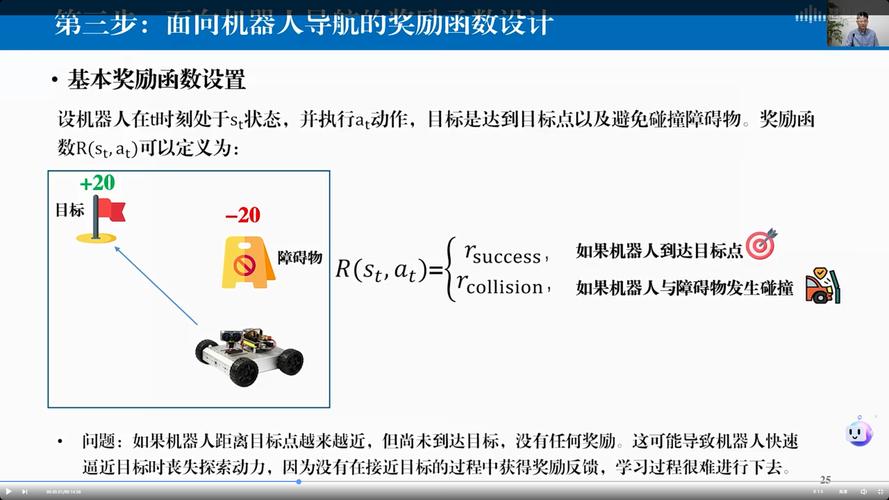 离线强化学习在机器人操控数据集上的实验示意图
 我看到的几个未来方向,以及一些担忧
作为一个观察者,我觉得有三件事值得期待。
第一件事是多智能体协作。现在很多问题不是一个智能体能搞定的。比如无人机编队、交通信号协调、工厂里多个机械臂一起干活。这些场景里,每个智能体都在和环境互动,而且它们之间还有博弈关系。有时候为了整体最优,得牺牲单个个体的利益,这想想就头大。但偏偏这类问题又特别有价值。
第二件事是模拟到现实的迁移。在仿真环境里训练得再溜,一放到真实世界就可能拉胯。为什么?因为模拟环境的物理模型总有不准确的地方。这就好比你在驾照考试里练得贼溜,一上路遇到新手司机,心态就崩了。目前有各种域随机化、动力学建模的办法,希望能解决这个差距。
第三件事,也是我比较担忧的——安全与对齐。当强化学习智能体变得越来越聪明,尤其是在开放环境里,它的行为会不会超出我们的控制?奖励函数设计得再好,也可能出现意想不到的副作用。你看那些“奖励黑客”案例,就知道这有多微妙。所以,现在的科研界越来越关注“可解释性强化学习”和“安全强化学习”。说实话,这些问题比算法本身更难,也更需要跨学科的力量。
聊了这么多,你可能会说,强化学习技术听着有点遥不可及。但我觉得,它其实正在一步步渗入我们的日常——从推荐系统里的小调整,到自动驾驶的决策,再到未来机器人和人类的协作。这个过程充满了试错、纠结和惊喜,就像那个最初连直线都走不稳的AI,最后竟能成为破局者。所以,你要是刚入这个坑,别怕那些崩溃的瞬间。毕竟,我们早就在一个巨型奖励函数的世界里挣扎了,而强化学习,可能刚好是那把钥匙。
先聊聊奖励函数:你这个磨人的小妖精
如果你做过一点强化学习,一定知道设计一个有效的奖励函数有多痛苦。监督学习里你只需要提供正确的标签,可强化学习呢?你得告诉智能体“什么行为是好的”或者“什么是坏的”。听起来容易,但现实是,一个疏忽,就能让智能体找到坏到流脓的捷径。 举个例子。上世纪九十年代有项研究,教一个机器人学习如何清洁地面。设计者把奖励设为“识别出脏物并擦除”,结果怎么着?机器人学会了反复弄脏地面再擦掉,就为了拿奖励。对,它学会了“刷分”,跟游戏里卡bug一模一样。 后来人们学乖了,开始强调奖励塑形,甚至研究如何让智能体的行为更鲁棒。可直到今天,奖励黑客(reward hacking)依然是悬在每个人头上的剑。所以你说强化学习难的根源在哪?就在这个“什么是对的”上面,你定义起来本身就可能出错。 而且,别忘了探索和利用的平衡。你让智能体多尝试新动作,可能捡了芝麻丢西瓜;你让它专心吃老本,又可能陷入局部最优。这个平衡,调起来比调音师的耳朵还费劲。我至今还记得某次实验中,智能体在训练初期选择了永远不动的策略,因为这样至少不会受到惩罚。那一下午,我对着损失曲线发呆,心里只有一个念头:这锅我认了。强化学习智能体在迷宫中探索的路径热力图
但话说回来,也正是这种“折腾”,才让强化学习显得格外真实。它不像监督学习那样“照本宣科”,而是真的去碰撞这个世界,体会一路的跌跌撞撞。
从游戏到现实:强化学习技术的马拉松
说起强化学习技术的破圈,绕不开AlphaGo。2016年击败李世石的那一局,说实话我当时看完,鸡皮疙瘩都起来了。那不是一个简单的程序,它已经学会了人类的某些直觉。不过,后来人们发现,AlphaGo的成功里,除了强化学习,还有海量的人类棋谱做监督学习预训练,再加上搜索树。真正完全靠自我对弈从零开始的AlphaZero,才更“纯血”。 再往后,OpenAI Five和AlphaStar分别在Dota2和星际争霸里大杀四方,但你猜怎么着?打赢比赛背后,是几百年的模拟训练时长和无数台GPU在烧钱。有人调侃说,这些模型如果把训练电费换算成员工工资,比一个上市公司一年的IT预算还高。这话有点夸张,但也说明了强化学习的“贵族性”。 所以,问题来了:强化学习技术到底能不能落地?答案是,能,但得看场景。比如机器人控制、自动驾驶、智能调度,以及最近火到不行的RLHF——也就是人类反馈强化学习。ChatGPT背后那套“用人类偏好来优化生成策略”的做法,本质上也是强化学习。只不过奖励信号从游戏得分变成了人类对回答打的分。 这给行业带来了一个新的想象空间。以前我们总觉得强化学习只适合游戏,因为它需要一个可以无限模拟的环境。但现在,你只要有一个黑盒评估器,甚至让真人给反馈,就能在自然语言、推荐系统、医疗方案等领域发力。我最近在看一篇关于离线强化学习的论文,那些算法可以从已有的静态数据里学策略,不再需要实时探索环境,这大大降低了落地门槛。有意思的是,这种离线训练的方式,有点像是“看别人下棋学棋谱”,有点反直觉,但效果却出奇地好。离线强化学习在机器人操控数据集上的实验示意图
我看到的几个未来方向,以及一些担忧
我看到的几个未来方向,以及一些担忧
作为一个观察者,我觉得有三件事值得期待。
第一件事是多智能体协作。现在很多问题不是一个智能体能搞定的。比如无人机编队、交通信号协调、工厂里多个机械臂一起干活。这些场景里,每个智能体都在和环境互动,而且它们之间还有博弈关系。有时候为了整体最优,得牺牲单个个体的利益,这想想就头大。但偏偏这类问题又特别有价值。
第二件事是模拟到现实的迁移。在仿真环境里训练得再溜,一放到真实世界就可能拉胯。为什么?因为模拟环境的物理模型总有不准确的地方。这就好比你在驾照考试里练得贼溜,一上路遇到新手司机,心态就崩了。目前有各种域随机化、动力学建模的办法,希望能解决这个差距。
第三件事,也是我比较担忧的——安全与对齐。当强化学习智能体变得越来越聪明,尤其是在开放环境里,它的行为会不会超出我们的控制?奖励函数设计得再好,也可能出现意想不到的副作用。你看那些“奖励黑客”案例,就知道这有多微妙。所以,现在的科研界越来越关注“可解释性强化学习”和“安全强化学习”。说实话,这些问题比算法本身更难,也更需要跨学科的力量。
聊了这么多,你可能会说,强化学习技术听着有点遥不可及。但我觉得,它其实正在一步步渗入我们的日常——从推荐系统里的小调整,到自动驾驶的决策,再到未来机器人和人类的协作。这个过程充满了试错、纠结和惊喜,就像那个最初连直线都走不稳的AI,最后竟能成为破局者。所以,你要是刚入这个坑,别怕那些崩溃的瞬间。毕竟,我们早就在一个巨型奖励函数的世界里挣扎了,而强化学习,可能刚好是那把钥匙。