分布式创新网络:当科研协作不再围绕一个中心
上周跟一个在杭州做脑机接口的朋友视频,他说他们实验室现在跟北京、上海、甚至波士顿的几个组,共用一套数据管道。论文还在审稿,代码已经提前挂到GitHub上了。我愣了一下。十年前我泡实验室那会儿,每个组都是个小王国,数据是私产,代码是压箱底的宝贝。现在呢?一切都像流水一样,流来流去。
后来我查文献,发现他们这个模式有名字,叫分布式创新网络。翻译成大白话就是:创新不再依赖一个物理场所的大集中,而是由散落在不同城市、不同机构、不同国家的人,围绕一个共同目标,在松散耦合的组织形式里协作。听起来挺学术?其实你天天都在用。
比如开源社区。Linux、Apache、Python,哪个不是分布式协作的产物?但科研领域的分布式网络,比那更复杂,因为科研还涉及数据、实验、经费、署名,一堆破事。
一、从“分工”到“协同”,这中间隔着一个互联网的进化
其实分布式科研协作并不是新鲜本。早在2003年人类基因组计划宣布完成的时候,那全球几十个实验室的合作方式,就已经是分布式了。但那时更多是“大项目分解”,你测序这段,我做拼接,最后合成。这种是串行分工,不是真正意义上的“协同”。
真正的拐点,是工具链的爆发。GitHub、Slack、Zoom、云文档、还有各种数据共享平台,把协作门槛打到了地板价。我现在跟国内外的同行对数据,直接开个共享白板,比当年写邮件发来发去效率高得多。再配合开放获取运动,论文和数据的围墙一点点被拆掉了。
于是,一个节点的灵感,能在几个小时内通过网络传递出去,被另一群人放大、修改、反馈。这就是协同涌现。我之前在Nature上读到一个分析,说2011-2021年间,科研论文里跨机构合作的密度增加了快三倍。地理距离的影响在减弱,但信任的距离反而增加了。
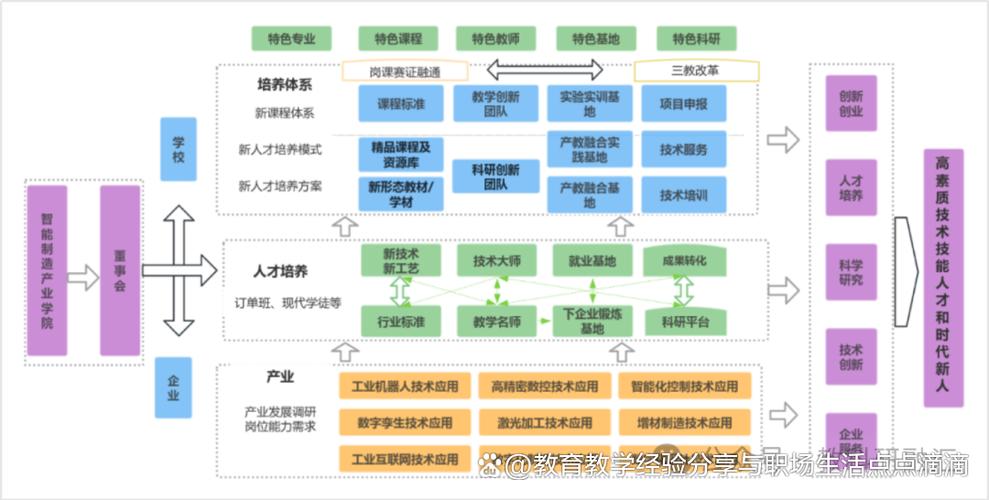 分布式创新网络跨机构科研协作模式示意图
二、分布式网络怎么运转?聊聊机制和玩法
 二、分布式网络怎么运转?聊聊机制和玩法
分布式创新网络不是把人都拉进一个群就完事了。它有几个核心机制。第一是模块化任务分解。一个大目标被拆成若干个子课题,每个小组负责一块,但接口要统一。比如研究气候变化,有的组做大气模拟,有的组做碳排放数据,有的组做政策分析,最后再拼起来。第二是开放共享的中间介质。代码、数据、实验流程,都得在保障隐私的前提下共享。不共享,协作就断了。第三是去中心化的治理机制。没有老大发号施令,而是靠共识和隐性的社会契约。这些问题没有标准答案,都是在碰撞中形成的。
我给你举个真实的项目。欧洲有个“人类脑计划”,当时几十个国家的实验室参与,大家意见不统一,差点崩盘。后来他们搞了个“虚拟实验室”,每个小组在数字空间里贡献自己的工具和数据,别人可以调用你的工具,但你保留所有权。这就有点像“共享经济”。这种玩法,其实是分布式网络的一种平衡。
还有一个更草根的例子。我认识一帮搞时空统计的人,他们自发维护了一个公开的R包库,全球几百个贡献者。每周末线上讨论,投票决定新功能。这个包现在被几十个论文引用。你说这算不算创新网络?肯定是。
三、现实中的坑:信任、知识产权、文化冲突
事虽好,坑也不少。最大的坑是信任。因为没有中央权威,你凭什么相信一个从没见过的合作者不卷包跑路?我听过一个悲剧故事:某高校团队跟另一个单位合作,共享了核心算法,结果对方转手就发了专利,自己反而被踢出局。这种事在学术圈不是个例。
知识产权就更纠结了。成果归属谁?论文作者顺序怎么排?我有一个合作方,为排序吵了两个月,最后按机构首字母排。你说荒不荒唐。但没办法,没有先例可循。
文化冲突也是一大内耗。有的团队崇尚敏捷,天天站会;有的喜欢憋大招,一个月才冒个泡。还有对“什么是完成”的理解,天差地别。我们跟德国人合作的时候,他们说“完成”就是所有流程都验证通过;我们这边的年轻研究生,觉得代码能跑就算完成。这种摩擦,特别消耗人。
但说实话,这些问题还不至于让分布式网络停摆。因为好处太明显了。你想想,一个团队不可能同时拥有所有资源,但网络上可以。算力、数据、设备、人才,都能按需调用。对于资源不足的中小机构,这是弯道超车的机会。
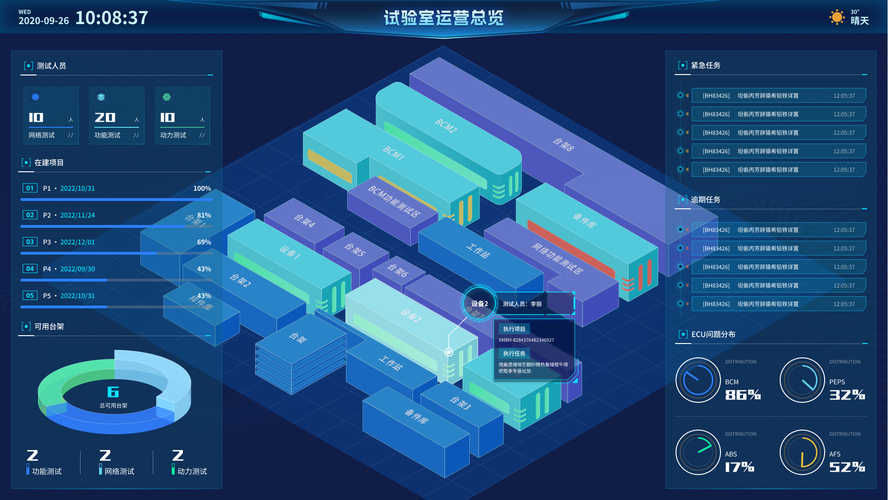 分布式科研协作平台功能界面截图
四、算力网络与AI大模型,是分布式创新网络的最新注脚
 四、算力网络与AI大模型,是分布式创新网络的最新注脚
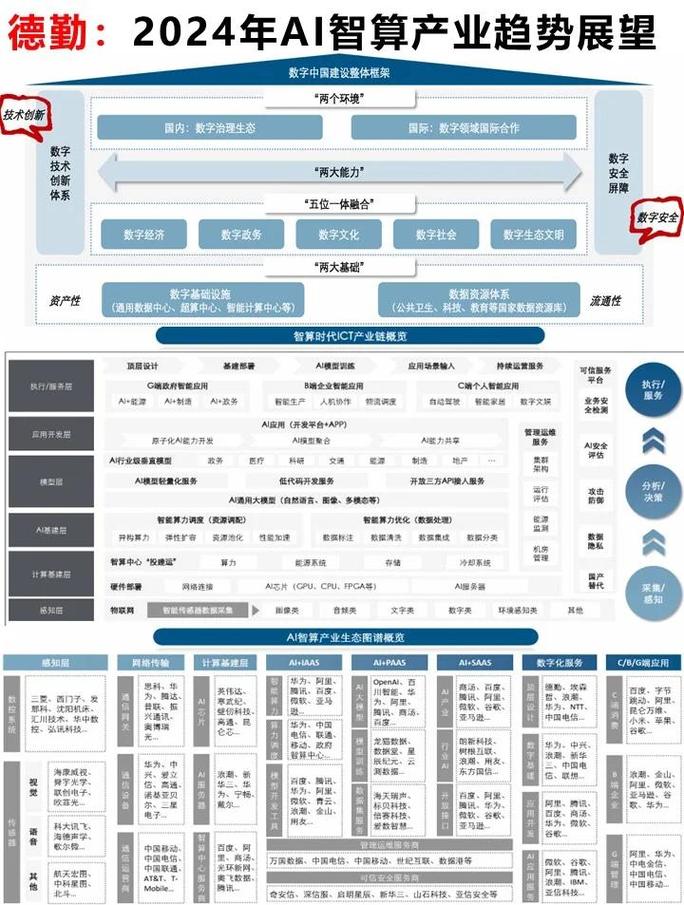
最近的AI大模型浪潮,把分布式创新网络推到了新高度。训练一个千亿参数模型,需要的算力,哪怕是巨头也要头疼。于是就有了分布式算力调度网络,比如那个“紫东太初”,或者民间的类脑智能云实验室。很多公司把闲散GPU捐出来,组成一个虚拟超级计算机,训练的开源模型再共享给社区。这波操作,就是分布式网络的典型应用。
更潮的是DeSci,即去中心化科学。有人想用区块链来做贡献记录和利益分配,让科研人员按贡献拿token。我不太喜欢炒作,但至少它提供了一个激励框架。设想一下,你参加全球某个罕见病研究网络,你贡献的每个数据点、每次审核,都被记录,然后按权重获得信用。当这个网络足够大,信用就是你的学术简历。这个未来,也许五年内就会落地。
还有一件让我兴奋的事:开放数据。现在很多基金的条款里,强制要求数据必须开源。比如美国国立卫生研究院有data commons,欧洲有EOSC。这些数据基础设施一旦连成一张大网,很多跨学科研究就能直接踩在巨人肩膀上。
说了这么多,我的感受是什么?分布式创新网络并不是要把所有科研都变成松散联盟。有些领域,比如粒子物理,还是需要中央大装置。但那股自上而下的权威之风,正在被一股自下而上的细流渗透。你可以在你的课题、你的实验室,试着接入这些网络,哪怕只是把代码丢到公开仓库。
我觉得,这可能会让你失去一点“独家优势”,但换来的是更清晰的科学进程,以及不可预知的碰撞。就像我妈说的,多个人多双手,但哪有那么多便宜事。可科研这东西,本来就不是请客吃饭。
好了,就说这些。说不定哪天,我们会在一个分布式网络里碰面,然后一起搞票大的。