抗风险技术设计:别等出了事再挠头
上周四凌晨三点,我被一通电话吵醒。
生产环境又挂了。而且,挂得莫名其妙。
一个边缘服务的内存泄漏,像多米诺骨牌一样,拖垮了整个核心链路。说实话,那一刻我真的很想骂人——我们明明做了那么多预案,写了那么多文档,怎么还是这么脆弱?
不过话说回来,这种深夜惊魂,大概是每个搞技术的都躲不掉的劫。问题出在哪儿?我们总以为加了几个 try-catch,挂了个监控,就算“抗风险”了。其实,差得远呢。
真正要命的地方,往往是那些你自以为考虑周全的角落。对吧?
 服务器机房深夜告警场景
别把“抗风险”做成“应付检查”
很多团队一提到抗风险,脑子里蹦出来的就是:年度演练报告、冗长的容灾方案、还有领导开会时那句“我们要确保万无一失”。然后呢?方案锁进柜子,代码里该单点还是单点,该同步阻塞还是同步阻塞。这不是抗风险,这是自我欺骗。
抗风险技术设计的本质,是直面不确定性。你得承认:系统一定会出问题,人也一定会犯错。在这个前提下,去构建即使局部崩塌也能继续存活的能力。这不是一次性工程,而是一种持续演进的肌肉记忆。
我特别烦一种说法——“我们的系统很简单,不需要搞那么复杂”。说这话的人,往往在第一次流量洪峰到来时,第一个懵掉。复杂度的确要控制,但不能拿“简单”当免死金牌。尤其是现在,微服务一拆,调用链长得像迷宫,一个小小的时间超时,经过层层放大,就能变成全链路雪崩。这种事,我见得太多了。
怎么办?先丢掉那种“一次搞定”的幻想。然后,从最脆弱的地方开始动刀。
 混沌工程实验注入机制示意图
科研成果里的真相:混沌工程与韧性设计
说起来你可能不信,抗风险设计里最有价值的几个理念,其实来自十年前一篇论文——《混沌工程原则》(Principles of Chaos Engineering)。那时候 Netflix 刚搞出 Chaos Monkey,随机干掉生产环境实例,所有人都在骂他们是疯子。但结果呢?他们真的把系统练出了金钟罩。
混沌工程的核心思想很简单:通过受控的实验,主动注入故障,来验证系统是否具备预期韧性。别等线上莫名其妙崩溃,你直接把它搞崩——当然,是在可控范围内。你知道问题会出在哪儿,然后提前加固。这比任何纸上谈兵都管用。
不过,我得吐槽一下:现在有些团队把混沌工程当成了时尚单品。装个 ChaosBlade,跑个 CPU 满载实验,截图发朋友圈,完事。这跟真正的工程实践差太远了。实验设计要贴近业务场景,比如模拟下游服务延迟突增、数据库主库宕机、注册中心网络分区……而且,必须要有观测体系兜底,不然你连炸了之后发生了什么都不知道。
再往深了说,科研界一直在探索“韧性工程”(Resilience Engineering)这个概念。它不像传统风险控制那么僵硬,而是强调系统在扰动下的自适应能力。听起来玄乎?其实就几句大白话:出问题时,系统能不能先撑住不崩?能不能部分降级保留核心功能?能不能快速恢复?能不能从故障中学习?这四个“能不能”,比一百页容灾方案都好使。
接地气的设计套路:从冗余到隔离
理论说了那么多,落回代码里,到底怎么做?我列几个自己踩过坑、验证过有效的路子。绝对不是什么银弹,但至少能让你少接几个凌晨电话。
第一,冗余最怕“伪冗余”。你以为做了多活,结果两个机房用的同一个光纤,被挖掘机一铲子同时干断。或者主备数据库,数据根本就没实时同步。这种冗余,纯粹是心理安慰。真正的冗余,必须考虑故障域隔离——比如不同可用区、不同云厂商,甚至不同物理区域。成本高?当然高。但比起一次事故赔掉的钱,划算。
第二,限流降级要带上脑子。不是简单加个令牌桶就完事。你得想清楚:当流量超出阈值,是直接怼回去,还是排队?哪些接口可以降级返回静态兜底?哪些业务必须死保?我见过一个支付系统,大促时把商品浏览页给限了流,结果用户看不见东西,订单反而跌得更惨。这就属于典型的降级策略与业务目标脱节。
第三,隔离,隔离,还是隔离。线程池隔离、进程隔离、服务器隔离,这些玩意儿越细越好。一个非核心服务的慢查询,把整个应用线程都占满的例子,每天都在发生。用 Hystrix 或者 Sentinel 搞线程池隔离,虽然会增加一些资源开销,但真的能救命。别怕麻烦,出了事更麻烦。
第四,发布是最大的风险源,没有之一。灰度、蓝绿、金丝雀,这些词你都听腻了,可实际落地烂得一塌糊涂。关键在于监控和回滚速度。灰度发布时,不但要看错误率,还要看业务指标——比如下单成功率、支付耗时。一旦异常,必须能在秒级切回老版本。做不到秒级?别扯什么灰度。
另外,说个反常识的点:不要过度设计。刚起步的小项目,单点就单点,手动运维也够用。强行上一套 K8s + 多活 + 全链路压测,结果团队能力跟不上,反而引入更多风险。抗风险要和业务规模匹配,动态演进。
哦对了,还有可观测性。没有好用的监控、日志、链路追踪,抗风险设计就是瞎子。出故障时,你连哪颗螺丝松了都看不见,还谈什么修复?
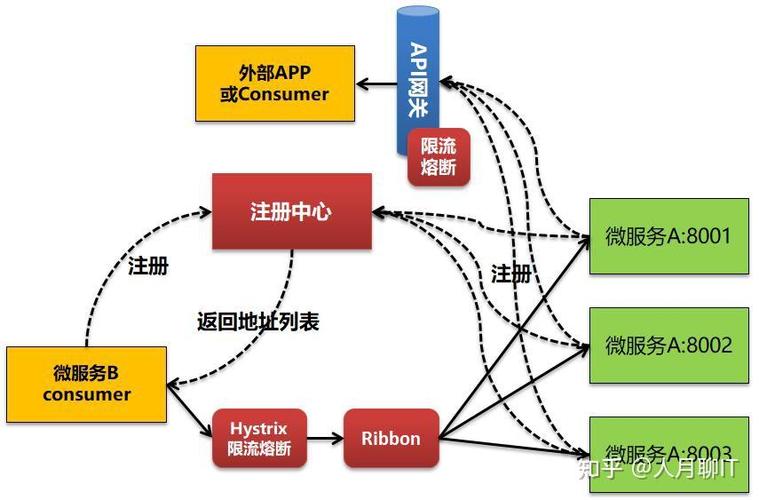 微服务限流降级策略示意图
让演练成为习惯,而不是表演
前面说的这些,如果不经常练,等于白搭。我特别反感那种半年一次的全公司级“红蓝对抗”——剧本提前写好,演练前一小时通报,大家按部就班走个过场。这是演给领导看的,不是真给系统防风险。
真正的故障演练,应该像吃饭一样平常。每周挑一个非高峰时段,随机注入一个故障,不通知任何人。然后看团队反应速度、系统自愈效果。一开始肯定鸡飞狗跳,但多搞几次,你就会发现大家不再恐慌,甚至开始主动提“我们这儿是不是再加固一下”。这才是健康的文化。
说实话,我见过的最强的一个团队,他们把故障演练集成到了 CI/CD 流水线里。每次发布,自动触发一批混沌实验,任何指标异常自动中止发布。这需要相当高的工程成熟度,但确实是方向。
最后,我想强调一点:抗风险技术设计,最怕的就是“以为没事”。现实世界没有完美系统,只有不断对抗熵增的过程。你我都是这条路上的摸爬滚打者,别迷信权威,多试试,多炸几次,自然就懂了。