聊聊韧性技术系统:别等崩塌才后悔
为什么你的系统总在凌晨三点崩?
为什么你的系统总在凌晨三点崩?
说实话,这问题困扰我很久了。每次大促、流量洪峰,半夜告警电话就响。真的烦。有人说加机器,有人说做熔断——可该崩还是崩。直到我读了那篇ACM的论文,突然就悟了:我们缺的不是技术,是韧性。对,韧性。不是可靠性,也不是高可用,是那种被揍了一拳还能晃晃悠悠站起来的劲儿。
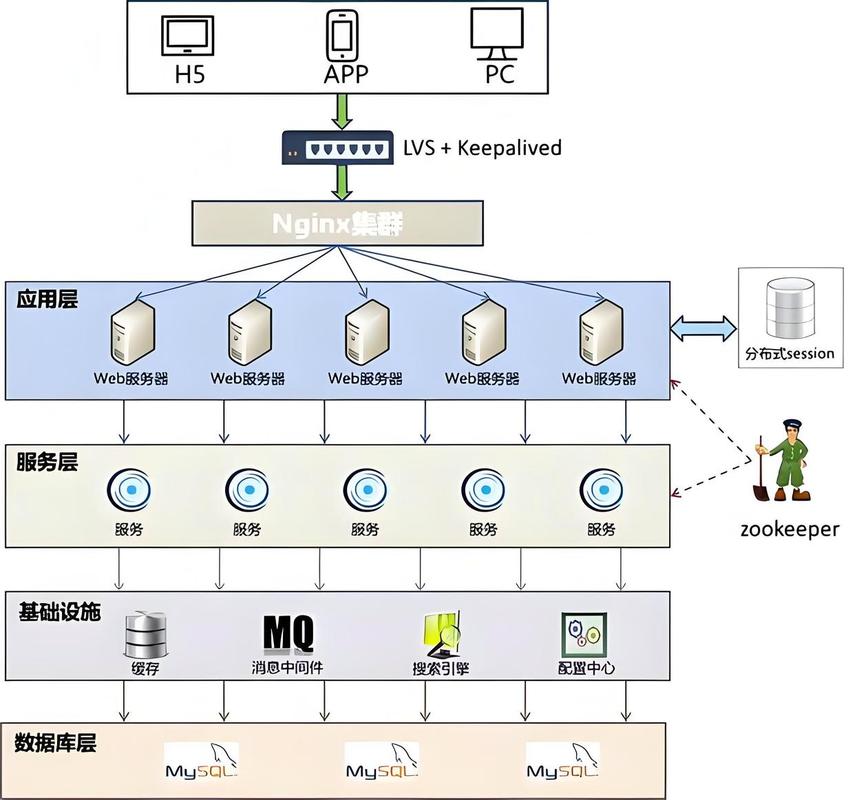
分布式系统韧性架构示意图
你想想,传统架构像玻璃,硬但脆。现代分布式系统?更像竹子。风来了,弯一下,风走了,弹回来。这就是韧性(Resilience)的核心。它不保证不死,但保证很快活过来。混沌工程大家现在都在搞,Netflix那套Chaos Monkey,其实就是在练这副筋骨。
不过,练得走火入魔的也不少。有些人随便搞个故障注入就觉得自己韧性了,结果线上真故障一来,反而更乱。丢人啊。
自适应容错:别蠢蠢地重复失败
最近AWS re:Invent 上有个分享挺有意思。他们提到了“细胞化架构”(Cell-based architecture)。把系统切成一个个独立细胞,一个烂了,其他没事。这玩意儿不是新概念,但结合现在Serverless、边缘计算,威力就大了。
细胞化架构与韧性设计模式对比
我就想起N年前的一线体验。那时候团队给金融系统做容灾,双活数据中心,看起来牛吧?结果一次光纤挖断,切换过程直接数据冲突,修复了三天。为什么?因为我们把韧性等同于冗余,却忘了
错误隔离和
自愈能力。冗余只是给你多备几块玻璃,该碎还是一起碎。
现在学术界搞的那个“自驱动韧性”(Self-driven Resilience),用机器学习预测故障,提前迁移工作负载。听起来科幻,但Google的Spanner不就这么干的?不过话说回来,ML引入新风险,模型漂移导致误判,这事儿也不是没发生过。对吧,技术债总是要还的。
文化层面的韧性——人比系统更脆弱
最逗的其实是这个。你系统设计得再牛,人一出问题全完蛋。去年有份SRE报告说,70%的事故跟变更有关,而变更又是人做的。所以真正的韧性技术系统,得把人也纳入设计。
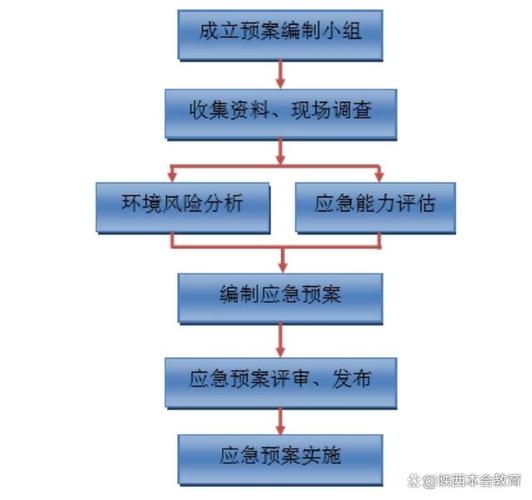
故障处理中人的应急反应与协作
我们团队试过搞Game Day,模拟全站瘫痪,让大家真刀真枪干。一开始手忙脚乱,键盘敲得啪啪响,还有人急得爆粗口。但几次之后,那种冷静的节奏就有了。
事故预案不是文档,是肌肉记忆。 而且,最好玩的是,事后复盘时大家不再甩锅,而是争着说“这个坑我跳过一次,下次我教你们怎么绕”。这比什么灾备演习都管用。
别忘了监控的可观测性。 日志、指标、链路追踪三位一体,老生常谈。但多少人真的在凌晨三点接到告警时,能一眼看出根因?仪表盘花花绿绿,关键时刻不顶用。我见过最狠的,直接把告警接给AI助手,自动诊断,连修复方案都给你列好了。当然,AI有时也会犯二,把内存泄漏当磁盘满,让你重启服务器——那场景,哭笑不得。
韧性技术系统不是个产品,也不是某个算法。它是一种思维方式:承认失败不可避免,然后练习如何优雅地应对失败。就像学摔跤,不是学不摔倒,而是学摔倒后怎么站起来,还能拍拍土给别人一个微笑。
所以,下次架构评审,别再只问TPS多少、QPS多少。问问:如果数据库突然丢一半节点,你能撑几分钟?如果你的SRE团队全去度假了,系统能自己活多久?答不上来?那就赶紧回去练吧。