容器化部署技术:一个科研搬砖工的避坑指南,从环境地狱到一键起飞
「在我机器上能跑」这句话,我听到就想摔键盘
你应该也遇到过。复现一篇论文,作者丢给你一个 GitHub 链接,README 里轻描淡写一句「Install dependencies: pip install -r requirements.txt」。你照做,然后:报错。 缺这个 .so 文件,那个包版本不对,CUDA 版本低了,cuDNN 又高了。最离谱的是,有程序非得用 Python 3.6 和 TensorFlow 1.12,那是从文物里挖出来的组合吧!我为此重装过 3 次系统——别笑话,那时候真没别的招。每次格盘都像割肉,几百 G 的数据倒来倒去。现在想起来,那纯粹是自虐。
 科研软件环境依赖地狱痛苦示意图
后来开始用 conda,以为得救了。可它管得了 Python 包,管不了系统包。有一次跑一个生物信息学的流程,里面有个 C 扩展死活编译不过,原因是它需要 gcc 7.5,而 Ubuntu 20.04 自带的是 9.4。conda 说:这不归我管。我盯着终端里那个刺眼的 error: command 'gcc' failed,想砸显示器。直到师兄甩过来一句:上 Docker。我当时想,又是什么花里胡哨的东西?试了一下,啧,真香。
一个能跑的 Dockerfile,比论文代码还金贵
Docker 的原理其实就一句话:把应用程序和它所有的烂摊子依赖,连同操作系统级的库,一起打包成一个镜像,然后无论在哪儿跑,它看到的都是同一个世界。这就像你把你家重新装修了一遍,然后连房子带家具打包在一个集装箱里,拉到任何地方打开,立刻就能住。舒服。
写 Dockerfile 却是门手艺活。我的第一个 Dockerfile 写了 20 行,构建出来镜像有 8 个 G。同事看了一眼,问:你是把整个实验室服务器都打包进去了吗?我脸一红。后来才明白,镜像层是叠加的,每一条 RUN 指令加一层,而 apt-get 的缓存、pip 的下载缓存不清理的话,都会永远留在层里。后来我把安装和清理写在一个 RUN 里,像这样:
RUN apt-get update && \
    apt-get install -y --no-install-recommends some-package && \
rm -rf /var/lib/apt/lists/*这招学废了,镜像体积瞬间瘦身一半。还有个坑:构建上下文。 我图省事,在 Dockerfile 所在目录放了十几 G 的数据集文件夹,结果 docker build 的第一步——发送上下文到守护进程——就卡了 10 分钟。当时真想把发明 COPY . 的人揪出来对质。后来学会用 .dockerignore,世界清净了。这些坑,官方文档可不会把它们加粗,全是血泪。
 Dockerfile轻量化层缓存优化技巧对比图
别小看 docker-compose,它救了实验室好几个项目
单容器跑跑脚本还行,一到正经项目就抓瞎。比如搞个 Web 服务做在线推理,前面得放 Nginx,后端是 Flask,再加上 Redis 做缓存,可能还得有个 GPU 容器跑模型。手工敲 docker run 命令,参数能绕地球半圈,而且每次启动顺序还不能乱。有一天我看到同事在一个 bash 脚本里写满了 docker stop、docker rm 和一堆 --link,头皮发麻。后来他改用了 docker-compose,一个 yaml 文件配好服务依赖,docker-compose up,齐活。这玩意儿简直就是为科研项目量身定做的——轻量,配置即代码,而且能一键把整个环境搬到任何有 Docker 的机器上。我们组现在所有实验代码,除了 README,一律附赠 docker-compose.yml。新的协作学生来,不用费劲配环境,直接 up,立刻开始改代码。那感觉,就跟从泥泞小路一下上了高速。
不过有一个问题千万注意:GPU 支持。 普通 Docker 连不上 GPU,得装 nvidia-container-toolkit。一开始我不知道,在容器里跑 torch.cuda.is_available() 永远返回 False,急得我满世界搜。确认安装后,记得 compose 里加上 reservation: devices: - driver: nvidia count: 1。还有一次,我忘了指定容器里的 CUDA 库路径,结果能识别 GPU 却报 libcuda.so.1 找不到,又是半天光阴。细节,全是细节。
k8s 在科研圈是真火还是假火?反正我劝你冷静
这两年 Kubernetes 大火,各种会议都在吹,好像你不用 k8s 就落伍了。学校里一些课题组也跟着上,搞个集群管理。我看在眼里,急在心里:咱做科研的,大部分时间是在开发和调试,部署的复杂度千万别超过实验本身。k8s 那套概念——Pod、Service、Deployment、Ingress——门槛不低,维护起来能把半个精力吃掉。除非你真的有几十个服务要编排,需要自动伸缩,需要滚动更新,否则 docker-compose + 一个强大点的 GPU 服务器,足以应对 90% 的科研场景。别为了显得「先进」去硬套一套牛逼框架,真没必要。有次隔壁组用 k8s 部署一个简单的 Flask 应用,各种配置搞了两周,而同样的东西我用 compose 一下午就上线了,而且还可以轻松迁移到其他机器。省下来的时间,去读论文不香吗?
当然,如果你做的是大型联邦学习、超大规模推理服务,那另说。但大部分人,真的,别想不开。如果你非要上,我建议试试 Podman + Pod,或者轻量级的 k3s,学习曲线会柔和许多。我始终觉得,工具的目的是减轻痛苦,不是增加痛苦。对了,最近发现一个好东西:Apptainer(原 Singularity),专为 HPC 和科研设计,天然支持 GPU 而且不需要守护进程,权限也友好,实验室场景可能比 Docker 更合适。我现在已经部分切了过去,美滋滋。
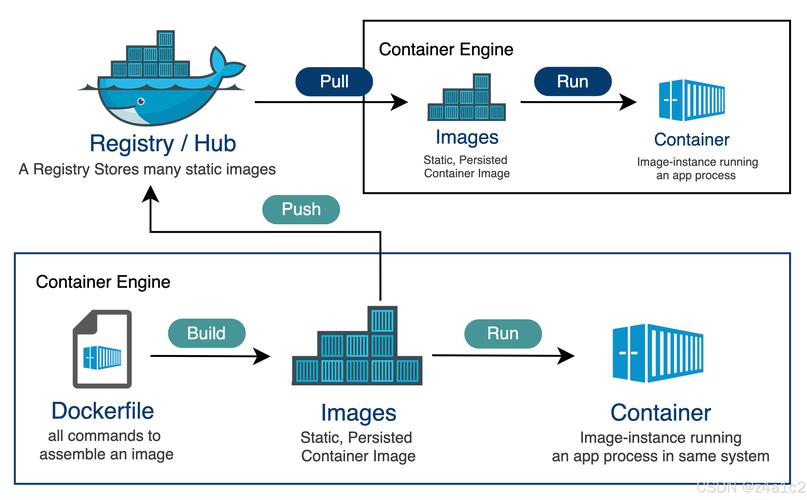 科研容器化工具选型Docker对比Podman Apptainer
这些年折腾下来,最大的感悟是:让代码能跑、能复现,是科研诚信的一部分。容器化技术不是银弹,但它至少给了我们一把趁手的锤子。以前配环境两天,跑实验五分钟;现在配环境五分钟,跑实验两天——别笑,这不代表我代码写的慢了嘛!但至少,时间花在刀刃上了。