持续集成技术:别让‘在我机器上能跑’成为甩锅名言
那个没有CI的年代,联调就是一场噩梦
十年前,我刚入行那会儿,团队还在用SVN。每个人都觉得自己写的代码没问题,一合代码,直接炸了——编译不过、数据库冲突、配置文件被覆盖……
“在我机器上能跑啊!” 这句话都快成程序员的口头禅了。说实话,那时候每次提测前,版本管理员就像个救火队长,手动合并代码,然后提心吊胆地跑一遍流程。出错了?靠吼和邮件通知,那效率,啧啧。
传统软件开发手动集成导致混乱场面
后来有人提了个工具,叫CruiseControl。我记得第一次看到那个仪表盘,红红绿绿的构建状态,感觉很新奇。但那东西配置起来超级麻烦,XML文件写得人头大。还得自己搭服务器,搞个定时任务,每天半夜跑一次构建。如果失败了,第二天早上邮箱里一堆报错,看着就血压飙升。那时候的持续集成,还只是个“理想丰满,现实骨感”的概念。
Jenkins,我又爱又恨的老伙计
Jenkins一出来,算是把CI的门槛拉低了一截。插上插件就能用,web界面点点点,pipeline也能搞了。但用久了才发现,这玩意儿也是坑。插件多如牛毛,版本更新不兼容是常有的事。
有次一个插件升级,整个构建脚本全挂了,查了半天发现是新插件改了环境变量的命名方式…… 简直想砸键盘。而且Jenkins的界面……怎么说呢,有种粗糙的极客感,但你说它不好用吧,人家社区又那么活跃,几乎什么需求都能找到插件。直到现在,还有大把公司在用,一边骂一边离不开。
Jenkins构建失败控制台红色报错
不过话说回来,有了Jenkins,我们的开发模式确实变了。提交代码后自动触发构建、跑单元测试、静态代码检查,如果失败,全组人都知道是谁的锅。这种透明化的压力,反而让代码质量上去了。谁也不想当那个经常弄红构建的人,对吧?
从CI到CD,自动化部署的狂野之路
持续集成做稳了,自然就想搞持续交付和持续部署。但这一步,可不是加个脚本那么简单。环境一致性是个大坑。测试环境能跑,生产环境就出问题——又是“在我机器上能跑”的变体。Docker的出现简直救了命。
把应用和依赖打成镜像,再也不用担心环境差异了。 然后Kubernetes编排,让部署变得像搭积木。现在想起来,那段时间技术栈更新飞快,从Jenkins pipeline到GitLab CI,再到GitHub Actions,CI/CD的工具链越来越傻瓜化,可定制性却越来越强。但问题也来了:工具太多了,选择困难症。有时候为了选型,能开好几次会,结果还是随大流用社区最活跃的那个。
我特别喜欢GitLab CI的YAML文件,清晰明了,版本控制起来也方便。但有一次,我不小心把生产环境的配置变量暴露在了日志里——
那种后怕的感觉,现在还记得。 安全性,在自动化流程里绝对不能忽视。现在很多团队引入DevSecOps,在流水线里嵌入安全扫描,这是大势所趋。
云原生时代的持续集成进化
如今,云原生、微服务,让持续集成又面临新挑战。服务拆得细了,一个应用可能包含几十个微服务,构建和测试的耗时急剧增加。于是就有了分层构建、并行流水线、依赖缓存这些优化手段。比如用Tekton,在Kubernetes集群里动态创建和销毁构建任务,弹性伸缩,又快又省资源。另外,低代码平台也在偷师CI/CD的理念,搞可视化流程编排,但说真的,对专业开发来说,还是代码化的配置更可靠。
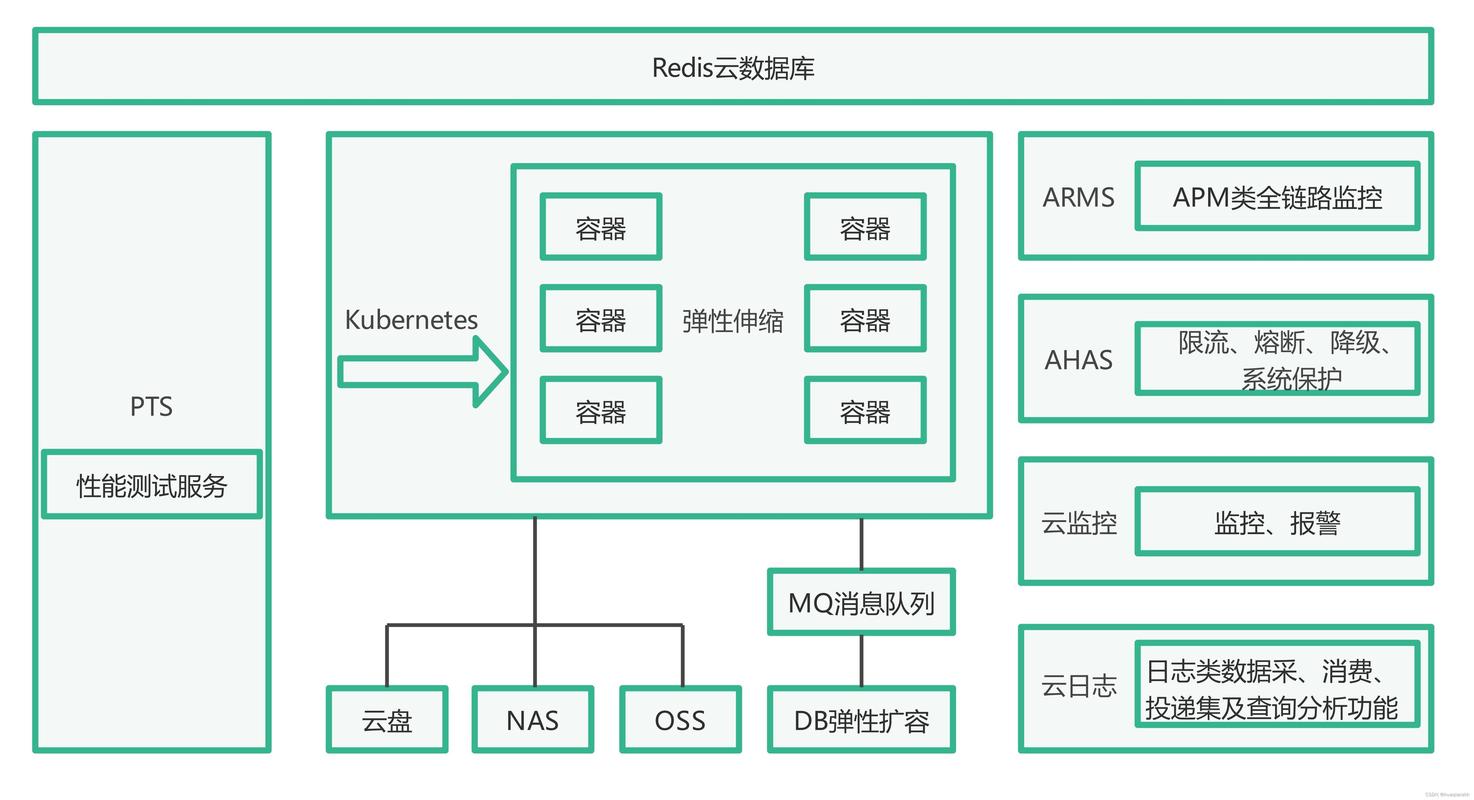
云原生CI/CD流水线架构图
我最近还观察到,AI开始侵入CI领域了。比如用机器学习预测构建失败的概率,或者自动修复简单的构建错误。虽然还处于早期,但万一真能实现,估计又能解放一批生产力。不过我倒是不担心失业——工具永远取代不了人的判断力,尤其是在处理那些诡异的构建错误时,经验比算法更重要。
好了,就聊这么多。回过头看,持续集成技术从无到有,从简陋到智能,真的就像软件工程的缩影:永远在解决“人”的问题——沟通成本、信任成本、容错成本。不管你用多花哨的工具,核心还是那个简单的理念:频繁集成,快速反馈,别让问题过夜。这是最朴素,也最有效的方法论。