深度学习技术:这两年,我算是看明白了
记得几年前,我还跟朋友吹嘘,说深度学习能荡平一切问题。现在回头看,脸有点疼。但也不是没有惊喜。比如去年,一个叫Sora的东西,直接把视频生成从玩具变成了工具——至少演示里是这样。我当时熬夜看了好几遍,真的,那种感觉就像第一次看到AlphaGo下棋,心里咯噔一下。就一种莫名的激动,虽然我明知道那是精心挑选的案例。人啊,就是容易被这种炫技打动。
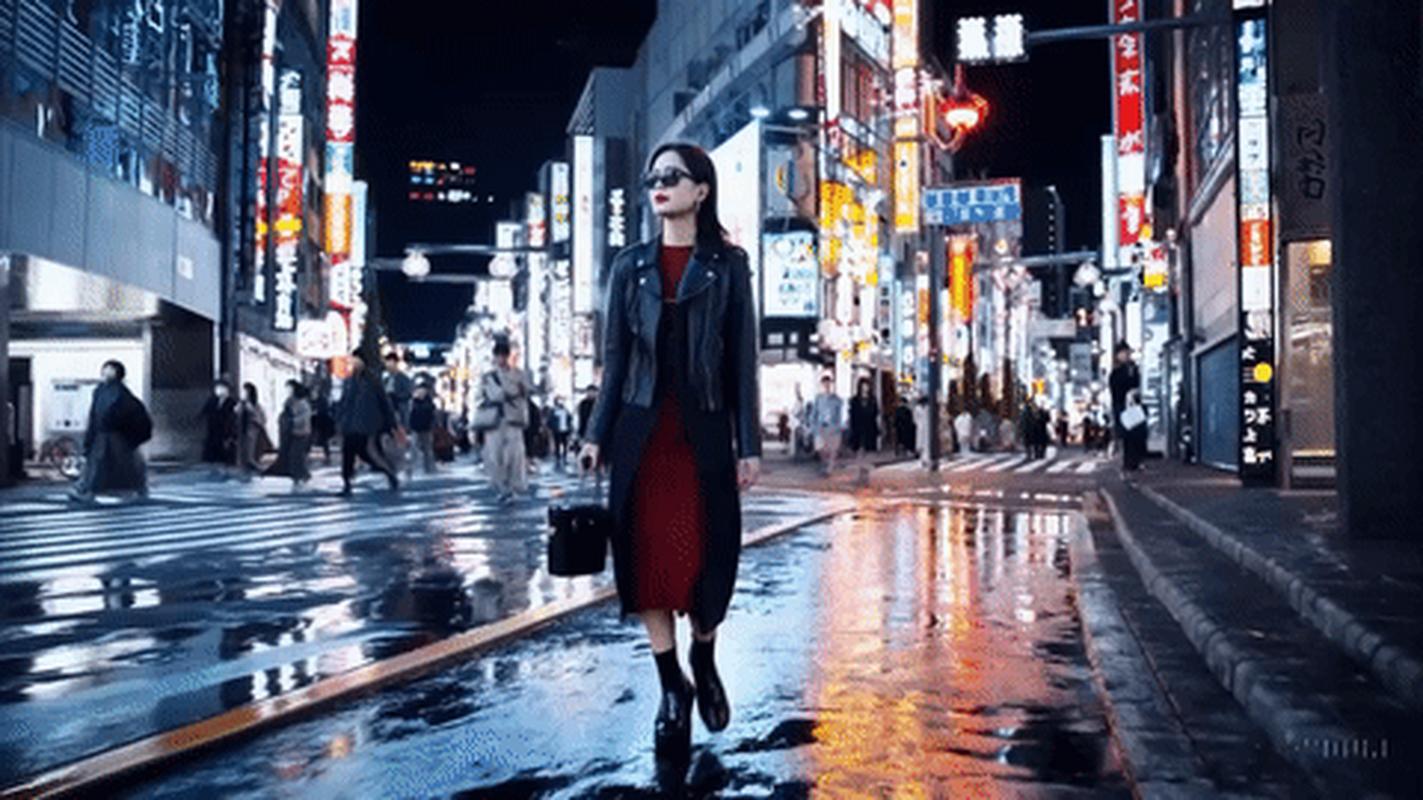 OpenAI Sora生成的视频截图,一个时尚女性走在东京街头,雨滴反射霓虹灯光
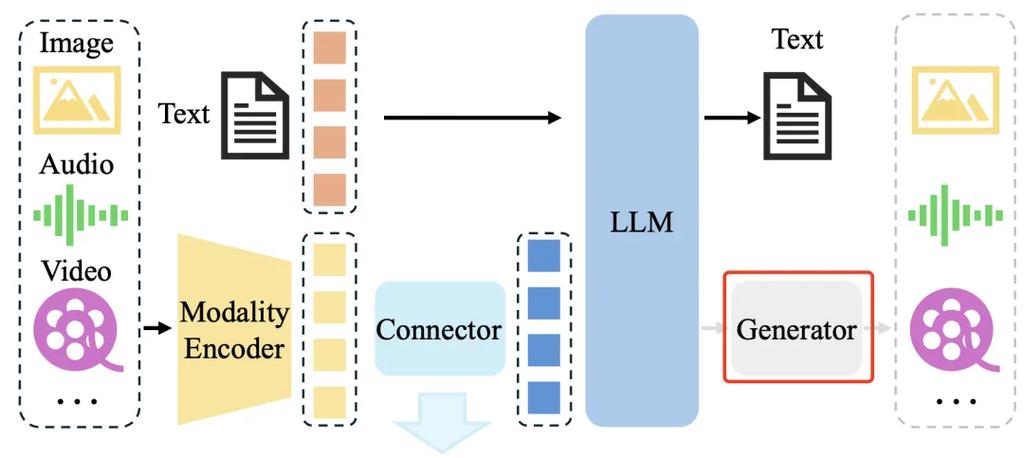 多模态AI系统架构图,展示文本、图像、音频的融合处理流程
扩散模型在图像生成上的进展,更是一路狂奔。从最早的模糊一团,到现在的能以假乱真,也就两三年。Midjourney V6出来的时候,有个叫“教皇穿羽绒服”的假照片,连我妈都信了,转发到家庭群。我不得不专门打电话解释。这其实挺可怕的,对吧?但另一方面,我表弟学建筑,用AI生成效果图,老师都分不清是渲染的还是画的,最后逼得学校改考核方式。这冲击,可能才刚刚开始。
 图像生成模型偏见示例,输入“成功人士”输出全是白人男性的截图对比
还有能耗。训练一次 GPT-4 级别的模型,排放的碳够一个家庭用上几十年。现在都在喊 ESG,但算力中心像不花钱一样建。我总觉得,这种不计成本的竞赛,早晚得翻车。除非能源有突破,比如可控核聚变,但那是另一个话题了。
 Hugging Face社区页面截图,展示多个开源深度学习模型和数据集
最后,我总在想,我们到底要什么?一个无所不能的黑箱,还是一个可以被审视的工具?我自己也分裂。做应用的时候,我恨不得模型再强一点;写到论文局限性部分,我又感叹它太不通透。也许,这就是深度学习的魅力吧,它逼着我们去思考智能的本质,也逼着我们面对人性的短板。用句矫情的话收尾:深度不再深,而在于度。
OpenAI Sora生成的视频截图,一个时尚女性走在东京街头,雨滴反射霓虹灯光
那些让人拍大腿的突破
先说大模型。GPT-4刚出来那会儿,我拿来测它解数学题,一道积分的题目,它居然能一步步推,不是死记硬背。那一刻我后背有点发凉。但你也别全信,它犯傻的时候也不少。比如有次我问它“如何把大象放进冰箱”,它给我列了个三步法,最后一步是“关上冰箱门”——看似有逻辑,但完全没考虑大象的尺寸。这就是现在最大的矛盾:能力忽高忽低,像个不稳定的天才。 不过,多模态确实是个分水岭。以前的模型,只能处理单一模态,现在?给张图,它能描述场景;给段音频,它能转成文本,再生成摘要。我前两天用 Gemini 1.5 Pro 测试,丢进去一个小时的会议录音,它几分钟就整理出带重点的纪要,连谁说了冷笑话都标出来了。这种体感上的便利,是实打实的。我认识的一个做自媒体的朋友,现在写稿、做图、配乐,全用AI,虽然偶尔会跟我抱怨“又给我推荐三只手的人”,但总体效率翻了几倍。多模态AI系统架构图,展示文本、图像、音频的融合处理流程
扩散模型在图像生成上的进展,更是一路狂奔。从最早的模糊一团,到现在的能以假乱真,也就两三年。Midjourney V6出来的时候,有个叫“教皇穿羽绒服”的假照片,连我妈都信了,转发到家庭群。我不得不专门打电话解释。这其实挺可怕的,对吧?但另一方面,我表弟学建筑,用AI生成效果图,老师都分不清是渲染的还是画的,最后逼得学校改考核方式。这冲击,可能才刚刚开始。
但是,真的有那么神吗?
我踩过的坑可不少。去年跟着一个医疗项目,用卷积网络分类皮肤病变。开源数据集训练出来的模型,准确率百分之九十几,看起来很美。结果拿到合作医院一跑,直接掉到七十出头。为啥?因为训练图都是专业设备拍的,医院的图是手机随手照的,光线、角度全变了。这就是泛化能力的问题,模型根本没学到病灶特征,它学的是设备噪音。当时团队所有人都傻了,钱花了,时间没了,最后不了了之。这种挫败感,不亲身经历很难体会。 还有黑盒。你问模型为什么输出这个答案,它给你一个置信度,然后就没有然后了。这就像去看病,医生只说你有病,不开药也不解释,你敢信?现在很多关键领域不敢用AI,就是这个道理。我认识一个搞金融风控的,他们模型识别欺诈很准,但监管部门要求必须有解释。他们搞了一年多“可解释AI”,头发掉了一地,最后还是妥协用了线性模型。你说讽刺不? 数据偏见更是老生常谈,但从来没真正解决。有次我用一个图像生成,打“成功人士”,出来的全是白人男性,我用中文输的都不行。我自己都想笑,真的无力吐槽。这能怪模型吗?数据就是那个鬼样子。更深层的是,这种偏见会自我强化。如果大家都这么用,未来的网络数据会更加偏,下一代模型就更歪。恶性循环。图像生成模型偏见示例,输入“成功人士”输出全是白人男性的截图对比
还有能耗。训练一次 GPT-4 级别的模型,排放的碳够一个家庭用上几十年。现在都在喊 ESG,但算力中心像不花钱一样建。我总觉得,这种不计成本的竞赛,早晚得翻车。除非能源有突破,比如可控核聚变,但那是另一个话题了。
下一步,往哪儿走?
现在行业有点分裂。一边拼命卷参数,万亿、十万亿,恨不得把整个互联网都塞进去。另一边在反思,是不是路走偏了。图灵奖得主 Yann LeCun 就一直在说自回归模型不是正途,要搞“世界模型”,让 AI 真正理解物理世界。他那个 JEPA 架构,说实话我没完全看懂,但我喜欢这种不随大流的劲儿。万一他是对的呢? 具身智能也是个热闹地儿。把大模型和机器人结合,不再是固定的机械臂,而是能听懂人话、能观察环境、能随机应变的家伙。我看过 Google 的 RT-2 演示,让人形机器人去捡指定零食,它还真做到了,虽然慢得像树懒。我隔壁实验室在做养老机器人,目标是能帮老人拿东西、聊天。听着很暖,但一谈起可靠性,导师就直摇头——现在这水平,陪聊天都怕胡说八道吓着老人。 开源社区是我最迷恋的部分。没有 Hugging Face 上那堆人,深度学习会乏味很多。一个高中生,用 LLaMA 微调个写诗模型,发到网上几百个赞;几个印度学生搞了个方言翻译,救了边缘语言。这些故事让我觉得,技术不该被垄断。虽然开源也有风险,比如被滥用,但那种活力和善意,千金不换。Hugging Face社区页面截图,展示多个开源深度学习模型和数据集
最后,我总在想,我们到底要什么?一个无所不能的黑箱,还是一个可以被审视的工具?我自己也分裂。做应用的时候,我恨不得模型再强一点;写到论文局限性部分,我又感叹它太不通透。也许,这就是深度学习的魅力吧,它逼着我们去思考智能的本质,也逼着我们面对人性的短板。用句矫情的话收尾:深度不再深,而在于度。