机器学习技术:别再神话它了,咱们聊点实在的
上周读了一篇CVPR的论文,差点把咖啡喷在屏幕上——不是因为它太惊艳,而是作者把ResNet和Transformer堆叠起来,换个数据集刷了点,就叫“重大创新”。 哎。 这种感觉,做这行的估计都懂:整个领域似乎被一种诡异的氛围笼罩。 发论文像流水线,工业落地又四处碰壁。 你说它没用? 可人脸识别、推荐系统,确实改变生活了。 你说它万能? 稍微换个场景,模型就装死给你看。
 卷积神经网络特征图可视化热力图示例
可这些技术离普及还远着呢。 而且,学术圈那点事... 你懂的。 动不动就声称“超越人类表现”,结果都是在封闭测试集上。 一扔到真实世界,光照变一下,精度掉得比股票还快。 对抗样本攻击更是一大软肋。 我记得有次在一个安全论坛上,有人演示用贴几个小贴纸,就让特斯拉的摄像头把停车标志识别成限速牌。 现场一片倒吸凉气。 这就是我们信任的系统? 所以别一听“人工智能”就觉得高大上,背后的脆弱,从业人员心里门清。
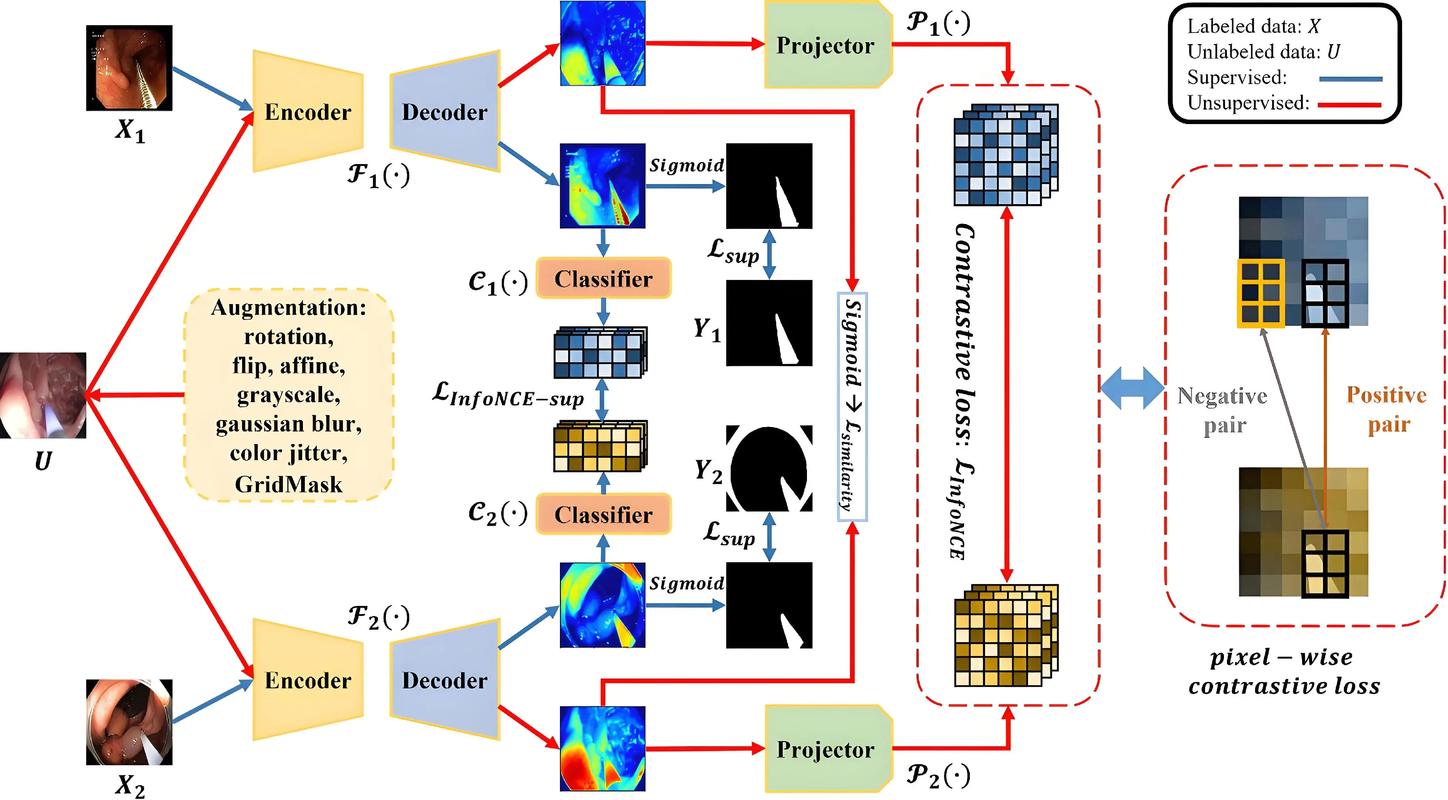 图像分割模型Segment Anything分割效果对比图
然而,开源社区也有人吵。 说Meta藏着掖着,模型太大根本不好微调。 还有人质疑数据隐私——毕竟它用了1100万张图训练,谁知道里面有没有爬取到你家窗台上的那盆花? 看吧,越是大的突破,麻烦事越多。
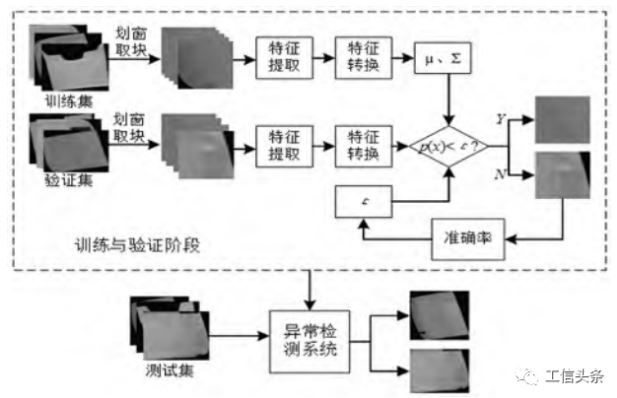 边缘计算设备部署机器学习模型示意图
最后说点个人感受。 入行十年,兴奋过、迷茫过、愤怒过。 机器学习的潜力远远没有被挖掘,但泡沫也大得吓人。 每当一个技术被资本裹挟,就很容易变成皇帝的新衣。 可我还是乐观的——因为身边总有那么一些踏实的工程师,在脏乱差的工业现场调着参数,在医院的嘈杂里听医生抱怨。 他们不在乎发不发顶会,只在乎这东西能不能用。 或许,这才是技术本来的样子。 不是炫技,是解决问题。
以上,算是一通牢骚吧。 如果能引起你一点共鸣,或者让你对机器学习技术多了些接地气的认识,那这篇胡言乱语就没白写。
那些被捧上神坛的“黑盒”
说实话,我们这帮人开会的时候常自嘲:搞深度学习的,一半是调参侠,一半是炼丹师。 模型内部发生了什么,很多时候没人说得清。 这不可怕吗? 一家银行用神经网络做信贷风险评估,拒绝了一个客户,却没办法向监管解释为什么——因为那几十万参数的黑箱,你根本追踪不了决策路径。 可解释性(XAI)喊了多少年,去年NeurIPS上关于这方面的workshop挤破头,但实际落地的方案有几个? 大部分还是用SHAP或者LIME这类工具糊弄一下,报告里画个特征重要性柱状图——你看,年龄最重要! 然后呢? 业务方苦笑一下,罢了。 不过话说回来,最近有个有意思的进展。 MIT那帮人搞出个叫“概念激活向量”的东西,能像个侦探一样,一层层扒开卷积网络,看它到底关注图像里的哪个物体部位。 这玩意儿用在医疗影像上就很有价值——医生至少能知道AI判断肿瘤,是基于形态还是纹理,而不是瞎猜。卷积神经网络特征图可视化热力图示例
可这些技术离普及还远着呢。 而且,学术圈那点事... 你懂的。 动不动就声称“超越人类表现”,结果都是在封闭测试集上。 一扔到真实世界,光照变一下,精度掉得比股票还快。 对抗样本攻击更是一大软肋。 我记得有次在一个安全论坛上,有人演示用贴几个小贴纸,就让特斯拉的摄像头把停车标志识别成限速牌。 现场一片倒吸凉气。 这就是我们信任的系统? 所以别一听“人工智能”就觉得高大上,背后的脆弱,从业人员心里门清。
科研圈的内卷与突围
说到学术圈,我不得不吐槽。 现在的顶会论文,越来越像行为艺术。 CVPR、ICCV,每年几千篇,能真正推动产业的有多少? 大部分在拼计算资源、拼导师大腿。 谷歌一年在计算集群上烧的钱,可能够一所普通大学运营十年。 这种军备竞赛下,小实验室怎么活? 只能往偏门的方向钻,搞什么少样本学习、自监督——听起来高级,其实也是被逼的。 但也不是完全没有清流。 最近Meta开源那个Segment Anything模型(SAM),就让我眼前一亮。 那种零样本分割能力,真的有点通用人工智能的味道了。 虽然离完美还差得远,边缘处理还是粗糙,但它开放权重、数据量大,一下子把很多下游任务的门槛打下来了。 你想想,以前做个图像分割项目,光标注几百张mask,实习生都能累出工伤。 现在直接用SAM做个预标,人稍微改改就行,效率提升十倍。 这才是科研该干的事:要么打开新思路,要么实实在在降本增效。图像分割模型Segment Anything分割效果对比图
然而,开源社区也有人吵。 说Meta藏着掖着,模型太大根本不好微调。 还有人质疑数据隐私——毕竟它用了1100万张图训练,谁知道里面有没有爬取到你家窗台上的那盆花? 看吧,越是大的突破,麻烦事越多。
工业落地:理想很丰满,现实骨感
我有个朋友,在制造业做视觉检测。 去年被老板逼着上深度学习,说“工业4.0,智能制造”。 他调研了三个月,选了YOLOv8,收集了几万张缺陷图,模型训练出来准确率99%。 上线那天,全厂都来了,大屏幕实时跳动检测结果。 帅不过三秒——产线速度一加快,漏检率飙升;新来一批原材料,纹理稍有不同,误报率直接失控。 他苦笑着说:“实验室是温室,产线是丛林。” 这就是典型的领域漂移问题。 训练数据永远无法覆盖所有生产状况。 更头疼的是,工厂环境里粉尘、振动、灯光频闪,摄像头拍的图经常带噪点,预处理得另外搞一套。 他们现在学乖了,用了一种叫做“持续学习”的策略,让模型在线更新,见一个错学一个错,慢慢适应——但稳定性又成了新坎,怕学坏了。 你看,学术上漂漂亮亮的SOTA,到实际中就是一场修行。 还有个死穴:算力。 云端推理有延迟,边缘端设备性能又弱鸡。 一个简单的ResNet-50,在树莓派上跑起来像幻灯片。 模型压缩、量化、蒸馏,这几年火得不行,就因为知道部署是大麻烦。 TensorFlow Lite、ONNX Runtime各种框架拼命优化,但效果还是比不上专门的NPU。 所以你看,华为、苹果都在往芯片里塞神经处理单元,软硬结合才是出路。 这又拉高了入场门槛。 小公司想用机器学习,要么上云被费用吓死,要么买个带TPU的开发板自己捣鼓。边缘计算设备部署机器学习模型示意图
最后说点个人感受。 入行十年,兴奋过、迷茫过、愤怒过。 机器学习的潜力远远没有被挖掘,但泡沫也大得吓人。 每当一个技术被资本裹挟,就很容易变成皇帝的新衣。 可我还是乐观的——因为身边总有那么一些踏实的工程师,在脏乱差的工业现场调着参数,在医院的嘈杂里听医生抱怨。 他们不在乎发不发顶会,只在乎这东西能不能用。 或许,这才是技术本来的样子。 不是炫技,是解决问题。
以上,算是一通牢骚吧。 如果能引起你一点共鸣,或者让你对机器学习技术多了些接地气的认识,那这篇胡言乱语就没白写。