数据可视化技术:别再搞那些花里胡哨的图表了,行吗?
先讲个鬼故事。上周帮一个朋友看他的项目路演PPT,满屏的3D旋转饼图、霓虹色折线、还有那个能闪瞎眼的动态气泡图。我问他,你想表达啥?他说,呃……数据很酷?那一瞬间我真的很想把键盘摔了——倒不是针对他,而是这么多年过去了,大家怎么还把‘可视化’理解成‘让图表更好看’?
说实话,这锅得那些工具背。Tableau、Power BI,没错,它们让做图表像搭积木一样简单,但也纵容了一种可怕的思维:选个炫的模版,颜色配得妖一点,完事。可科学可视化,压根就不是这门手艺。它更像是……一种翻译。把那些冷冰冰、纠缠在一起的数据纤维,翻译成人类视觉皮层能秒懂的语言。而这种翻译的讲究,深了去了。
从‘看’到‘感知’:视觉编码的科学,不是玄学
最近两年在可视化领域的顶会IEEE VIS上,有一个风向非常明显:大家不爱聊新图表类型了,全在挖人眼和人脑是怎么‘吃’进信息的。什么预注意加工啦,格式塔原理啦。你可能觉得这是老生常谈,但新就新在,研究者开始用眼动仪和脑电帽搞事情了。
比如,犹他大学有个团队做了一组实验,挺损的。他们让受试者看散点图,然后故意在角落里放一个颜色特别跳脱的异常点。结果呢?几乎所有人在50毫秒内目光就被拽过去了,根本控制不住。好,这证实了我们天生会被高对比度的东西吸走注意力。但更有意思的在后面——当实验中把这个异常点用相同的颜色、但放大了它的尺寸时,目光抢夺效应竟下降了30%。这说明什么?说明我们的大脑在极早期视觉处理阶段,对色相的优先级,要远远高于面积。
听到这你可能会说,哦,那我以后做图表,重点数据全标成大红大绿不得了?慢着。另一个来自哈佛视觉实验室的研究立刻啪啪打脸。他们发现,当页面中高饱和色超过三个时,视觉搜索效率反而断崖式下跌。因为你制造了太多的‘视觉噪音’,大脑直接摆烂了。这不是很讽刺?越想强调,越让人看不见。
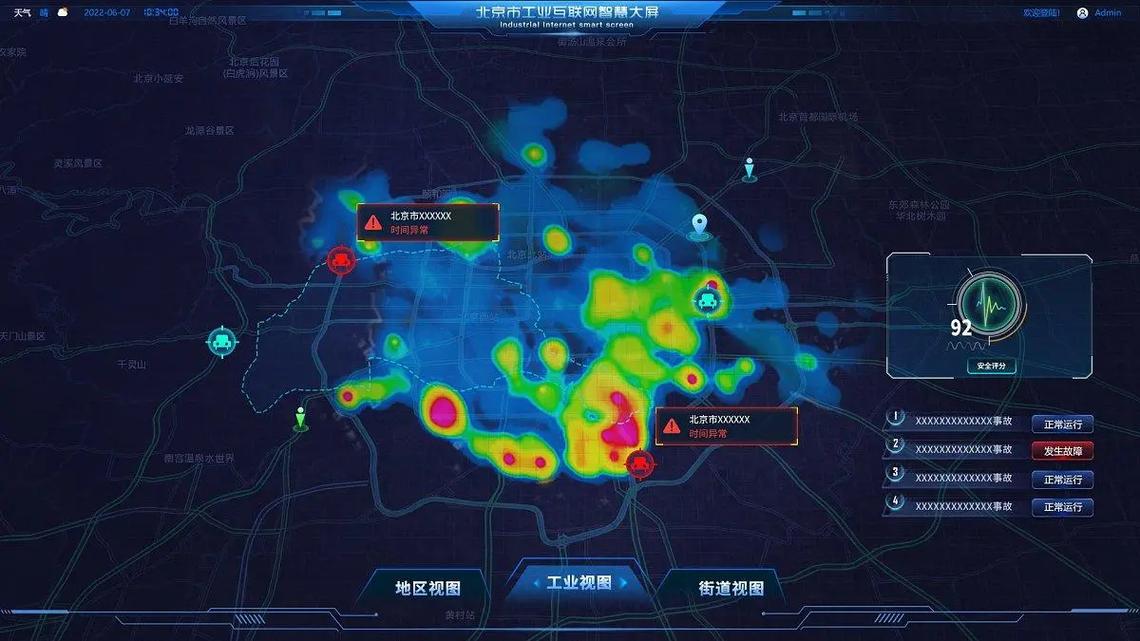 数据可视化视觉注意力热力图与眼动轨迹对比
你看,就这么一个简单的颜色问题,背后就是一套完整的神经美学博弈。再讲个让我很兴奋的应用。麻省理工媒体实验室搞出了一个叫“DataDancer”的东西,它不画图,而是把多维数据映射到一段舞蹈动作里!时间序列变成身体的旋转速度,数据异常变成舞者突然的抽搐……听起来很疯对不对?但我看了一段演示视频,鸡皮疙瘩起来了。当那个舞者因为数据暴跌而骤然倒地时,我内心真的咯噔了一下。那种情感的冲击力,是任何柱状图都给不了的。这才是具身认知在可视化里的终极玩法——让你用整个身体去‘理解’数据。
叙事可视化:别让观众当福尔摩斯
传统的数据可视化,总喜欢摆出一副‘朕已阅,你自己看吧’的架势。给你一堆交互过滤、上卷下钻,然后觉得用户自己会去探索。天真,太天真了。人类天生爱听故事,而不是侦探。
叙事可视化(Narrative Visualization)就是干这个的。它不是做死板的仪表盘,而是用数据讲一个有起承转合的序列。你跟着设计者的节奏,一步一步发现 insight。就像看了一场迷你纪录片。这几年最让我拍案叫绝的案例,是《纽约时报》2023年做的那篇关于‘全球珊瑚白化’的报道。他们没有贴一张温度变化地图了事,而是做了一个滚动驱动的旅程。你往下滑,首先看到一片绚丽的珊瑚礁,然后随着年份推进,色彩一点点褪去,变成惨白,最后统计数字像墓碑一样浮上来。那种震撼,你读一篇一万字的报告都体会不到。
不过话说回来,叙事可视化有个大坑——操纵感。因为你在引导注意力,很容易变成数据欺骗。我见过最恶劣的一个例子,某家公司把营收增长率强行按‘喜’字型的曲线去拟合,用动画速度的缓急来掩盖中间两次大跌。这已经不是可视化,这是视觉诈骗。
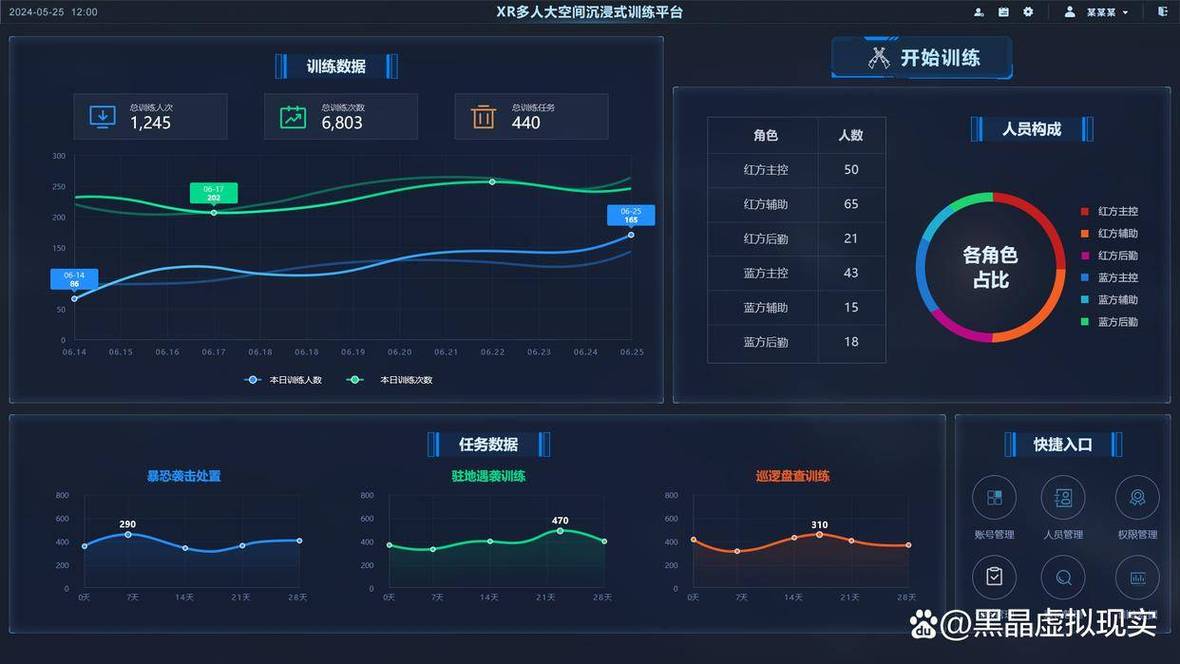 沉浸式数据故事滚动交互页面设计
所以现在学术界在狂推一个概念叫“语义联接”,让它无缝实现动态演化。在AI的加持下,这个过程可以半自动化。这才是未来该卷的方向。
AI 给可视化灌了口春药,但也可能让它阳痿
突然想聊点刺激的。ChatGPT出来以后,所有行业都在嗷嗷叫,可视化圈也一样。现在GitHub上最火的项目是什么?不是哪个图表库,而是Text-to-Chart那类东西。你输入一句‘帮我用折线图展示过去半年的销售趋势’,哗,图表出来了。看起来很美,对吧?
但作为一个亲手腌过无数数据的人,我要说一句:省省吧。AI现在最擅长的是生成‘正确但毫无灵魂’的图表。它不懂上下文,不懂用户认知负荷,更不懂审美。有一次我测试某款AI可视化工具,输入一个多层分组的数据集,它给我生成了一个有27种颜色的堆叠直方图,密密麻麻像调色板爆炸。我想要的是一个清晰的主次对比,它却给了我一场视觉灾难。
问题的根儿在哪?在于AI只学会了图表语法,没学会视觉修辞。它不知道什么时候该用‘借代’(用局部代表整体)、什么时候用‘夸张’(放大小数目的影响来引起警觉)。而修辞,恰恰是数据沟通的灵魂。国内浙江大学可视化与可视分析小组最近出的一篇论文很戳这个痛点,他们提出了一种叫‘审美意图嵌入’的方法,试图在模型生成图表时,加入‘简洁’‘戏剧性’‘可信赖’这样的高层指令。方法还很初步,但方向绝对是对的。
 AI生成数据可视化对比人工设计优劣案例
不过,AI也不是一无是处。在数据清洗和异常检测阶段,它简直是我的亲爹。以前手动找异常点,眼要瞎,脊柱要断。现在用上轻量级模型,分分钟把那些藏在角落里的坏点揪出来,还能自动建议视觉编码——虽然建议经常很蠢,但至少是个起点。我现在的创作流程变成了:AI出草图(大概20分),我再去注入故事性、调整视觉层次(提到80分),最后再抠像素级的细节。这大概也是目前人机协作最现实的模式了。
一点点私货:工具在谋杀思考
最后说点不好听的。前面吐槽了那么多工具,但根本问题不在工具,在人。我们太依赖软件提供的‘最佳实践’了,以至于丧失了‘为什么这个数据应该用面积而不是长度来表达’的批判性思考。我记得很清楚,读研时导师让我用半个月,纯手绘了一个多维数据的可视化方案,不让我碰电脑。那半个月痛苦得要死,但一直影响我到现在。因为当我必须用铅笔和尺子去度量每一个数据点的位置时,我才真正理解了数据里的物理质量——有些信息就是重,有些轻如鸿毛,而图表必须体现这种重量感。这种感觉,是你在软件里拖拽一个色块时永远得不到的。
所以,回到开头那个朋友的3D饼图。我后来没摔键盘,而是花了两个小时,帮他把所有数据重新梳理,最后只保留了一条加粗的折线和一个色块对比图。路演结束,他拿了第三名。他发消息说,投资人觉得‘逻辑特别清晰’。你看,这才是真正的酷。不是让图表跳舞,而是让数据自己开口说话。