大数据分析技术:踩过坑才敢说,这些坑你别跳
那次促销分析,我差点被数据淹死
记得去年双十一,老板扔过来一句话:“把上次大促的用户行为分析一下,做个预测模型,下周要。” 我拍胸脯,简单。结果——数据量直接超了单机内存。傻眼。加载个几百万行就死机。说好的大数据呢?我吐槽。后来硬着头皮上Spark,结果配置不熟,OOM错误一波接一波。发誓再也不临时抱佛脚。
数据量是双刃剑,给你洞察,也给你宕机。特别是现在的实时流,每秒几十万条进来,你用传统的批量处理?等结果出来黄花菜都凉了。所以,后来学乖了,先用采样,再慢慢上集群。不过话说回来,采样也有坑,偏差太大,模型直接抓瞎。
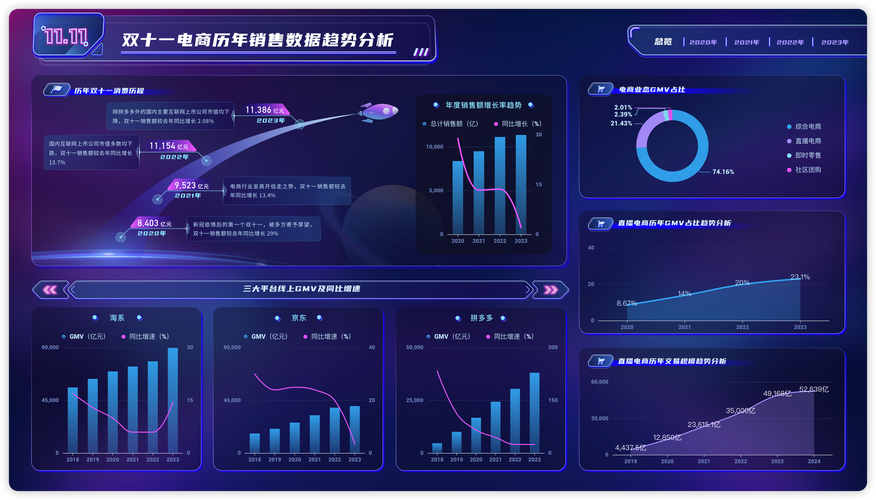 促销活动用户行为实时数据看板
那段时间,我天天盯着监控,心跳跟着延迟走。动不动就报警,内存快爆了。有一次半夜三点还在调优。我想骂人。真的,大数据分析入门容易,但要在生产环境稳如狗,那是另一回事。你想想,clickstream,推荐系统,风控,哪个不实时?一停就损失真金白银。
技术那么多,到底该押哪家?
说完失败的,聊聊科研成果吧。学术界这几年也是卷得飞起。什么批流一体,什么数据湖,什么湖仓一体,概念满天飞。我记得2019年看到一篇文章,讲基于Apache Flink的实时特征工程,简直惊艳。他们把特征计算延迟从分钟降到毫秒,模型效果直接提升15%。这才是实打实的技术进步,不是吹概念。但公司实际落地,呵呵,又是个大工程。我们试过,光是数据清洗和对接,就搞了两个月。研发说,你这需求没提清楚啊!我回,那数据这么脏,我能怎么办?——有种有苦说不出的感觉。
还有那个图计算,用在反欺诈上真的绝。知识图谱一建,团伙识别准确率飙升。但是图数据库选型又是一场血战。Neo4j?JanusGraph?各有千秋。我们选了个开源的,结果社区不活跃,遇到bug只能自己啃源码。我那个月头发掉了不少。所以啊,技术选型真的不能只看论文,要看生态和团队能力。对吧。有时候最先进的不一定最合适。
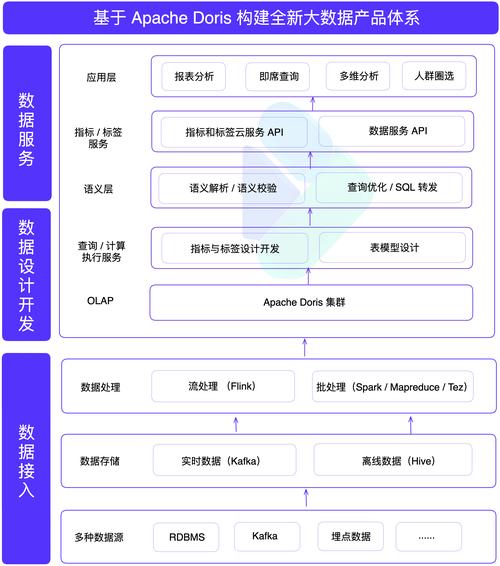 大数据技术栈生态图谱2025
另外,MLOps现在也被吹上天,说什么模型全生命周期管理。但小公司哪有人力搞那个?搞个自动训练就了不起了。我们当初模型上线,靠手工导出pmml,还老出错。后来用了个简单的调度,才总算喘口气。说实话,不是大厂,别一上来就整整套平台,会死得很惨。先解决问题,再谈工程化。
工具是天使还是魔鬼?聊几款我离不开的
做大数据分析,工具选得对,下班早。我偏爱Jupyter,虽然它有时卡得像乌龟,但交互式分析就是方便。配合pandas和polars,处理几百万行没问题。当然,再大的数据,就得Spark SQL。PySpark写起来跟SQL似的,但调优让人头秃。 shuffle partition 设多大?内存怎么分?搞不好就性能雪崩。有次生产任务跑了6小时,查下来就是一个参数没设对。这些细节才是经验的差距。
可视化工具呢?Tableau太贵,用开源的吧,比如Superset,功能还行,但权限管理一塌糊涂。我们内部搞了个hack,才勉强用起来。然后就是数据血缘——databricks的Unity Catalog挺好,但 vendor lock-in 让人不放心。我常想,要是能有个开源的统一元数据中心就好了。可惜目前还得各家自己拼。
再说说实时分析,ClickHouse是真的快,但运维复杂。我们团队曾经为了调优,专门抽出一个人研究物化视图。效果是真好,查询毫秒级。但后来数据量涨了,又要分片扩容,又是一通折腾。所以说,没有银弹。新出来的那些像StarRocks、Doris,也都不错,但迁移成本又高。技术选型永远是个坑,越深越难爬。
 ClickHouse查询性能监控仪表盘
哦对了,还有数据质量,这是个容易被忽略的大问题。我们曾经因为上游数据源字段变更,导致下游报表全错。老板在会上脸都绿了。从那之后,我们强制加了数据校验层,用Great Expectations做了自动检查,才算挽回点面子。所以说,数据分析,数据不准,分析就是垃圾。这道理简单,做起来难。
2024了,AI让数据分析师下岗?别逗了
最近ChatGPT code interpreter火的时候,很多人喊数据分析完蛋。我用过,确实能写SQL,但业务理解一塌糊涂。一次让它分析用户流失,它给我做了个相关性,完全没考虑幸存者偏差。我火大。但不得不说,像GitHub Copilot for Data那种,自动补全pandas代码,倒是真香。还有用大模型做数据标注的,省了人力。这算是AI真的帮了忙。不过,去年阿里云发表的论文,用LLM自动生成特征工程,那才是炸裂,据说在多个数据集上击败了人工。我试了他们开源的demo,确实能找出一些冷门特征。但落到企业数据上,还得人工校验,毕竟业务逻辑千变万化。所以,AI更像增强,而不是取代。至少现在还是。
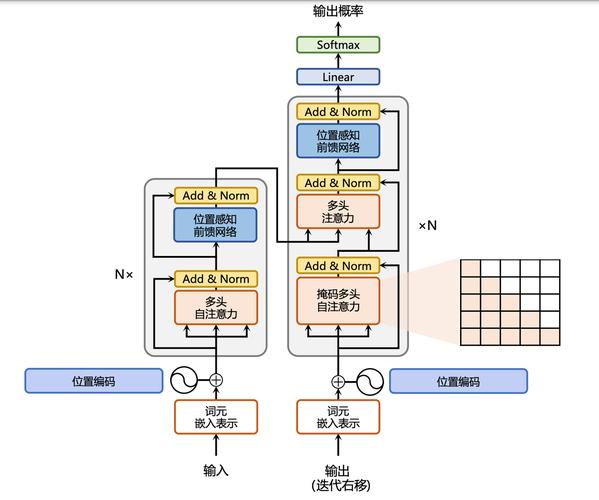 大语言模型自动特征工程流程图
这条路还长,继续踩坑吧。