别把知识沉淀当打卡:拆解组织学习机制的真实运行逻辑
上周在南京软件大道的一家制造业数字化服务商聊,他们去年砸了近两百万做内部知识库,搞了强制的每周学习打卡,到现在打开后台,87%的文档浏览量都是行政为了凑KPI刷的,一线销售和工艺工程师根本不碰。
说真的,这事我听了都觉得离谱。两百万啊。够给一线团队发多少奖金了。
很多人一提组织学习,第一反应就是要建平台、搞考核、定指标,恨不得把每个员工的学习时长都精确到秒。但真扎到企业里待过就知道,那些看起来流程完美的学习体系,大多从设计的第一天起,就没摸到真正的核心。
为什么90%的企业建的学习体系从根上就错了
之前去江宁的一家汽车零部件厂做调研,车间里的一位有着二十多年调试经验的老技师,去年办了退休。他走了之后,新招的设备工程师碰到进口机床的同款报警代码,要拆三个小时的机壳挨个排查,有时候折腾一整天都找不到问题根源——而老技师当年碰到这个代码,蹲下来听半分钟机床运转的声音,20分钟就能定位到是哪个传感器的间隙出了问题。
这些藏在老技师脑子里的经验,从来不是看几本设备说明书就能学会的。组织学习的核心不是让每个人多看书、多上课,而是把分散在个体身上的默会知识,转化成能跨场景复用的组织记忆。
很多企业的问题恰恰在这里:他们把学习等同于“个体学习的简单加总”,觉得只要每个人都完成了规定的学习任务,组织的能力就自动提升了。根本不是这么回事。你让一个天天在产线处理设备故障的工程师,花两个小时去学什么宏观的行业发展趋势、抽象的管理模型,他当然会开着课程挂在后台,人跑去处理产线的紧急问题。
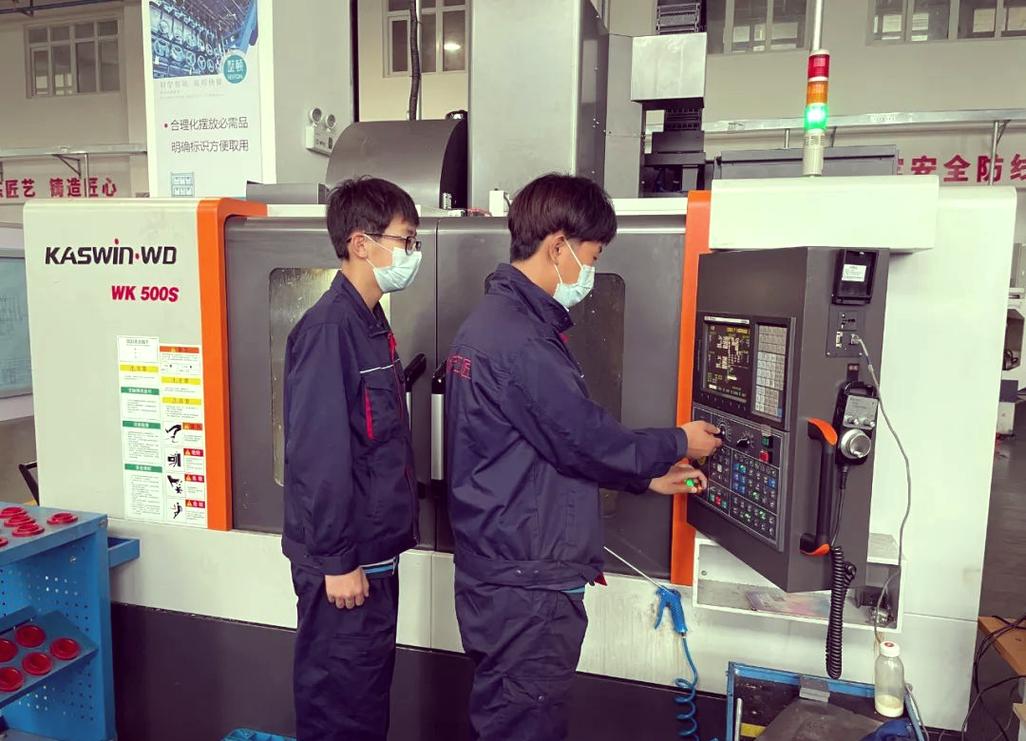 制造业车间老技师带徒调试数控机床现场
那些被错配的学习内容、被强制要求的打卡任务,本质上是把学习变成了员工和HR之间的猫鼠游戏。平台上的完课率、学习时长看起来都达标了,真碰到跨部门的棘手问题,大家还是要挨个发微信找当年经手的老员工问情况,之前沉淀的所谓“知识”,半点儿用都没有。
真正能跑通的闭环,从来不是靠行政强制
我接触过的几家真正把学习循环跑顺的企业,没有一家是靠强制打卡撑起来的。
南京本地一家做工业软件的团队,他们从来没有要求员工每个月必须学够多少小时,也没有什么专门的培训部门天天追着大家要学习笔记。但他们定了一个很简单的规则:每解决一个客户现场的棘手bug,负责处理的工程师要把整个排查过程、踩过的坑、最后验证有效的解决方案,整理成不超过两页的短笔记,存在内部的共享空间里。只要这个笔记被其他同事在实际项目中引用过,写笔记的人就能在项目奖金池里累计对应的积分,到了年底,这些积分可以兑换成带薪休假、项目分红,甚至是优先参与核心研发项目的资格。
跑了不到一年,这个共享空间里攒了近三千条笔记,新入职的工程师根本不需要花两周时间参加封闭培训,碰到问题先搜一下笔记,80%的常见问题都能直接找到解决路径。组织学习的激励锚点,从来不是“你学了多久”,而是“你沉淀的知识帮团队省了多少时间、少踩了多少坑”。
 工业软件工程师整理客户现场bug排查笔记场景
反过来再看那些靠行政强制撑起来的学习体系。之前在杭州见过一家电商企业,给每个员工定了每月8小时的在线学习要求,完不成的话直接扣当月绩效。最后大家摸出了应对方法:上班的时候把学习平台的页面开在屏幕后面,人该干嘛干嘛,挂够时长就直接关掉。平台后台的完课率月月都是100%,但真的碰到大促的突发问题,团队还是要临时拉群挨个问之前碰到过类似问题的同事,知识库翻半天找不到对应的解决方案。
本质上,这些失败的体系都犯了同一个错:把知识的沉淀和传播,当成了员工必须完成的义务,而没有把知识贡献的价值,和员工的实际收益挂钩。你让员工觉得写笔记、攒知识是在给公司干活,他自然会应付。你让他觉得这些知识能帮自己少加班、多拿奖金,根本不需要你催。
容易被忽略的边界:不是所有知识都适合进组织记忆
 容易被忽略的边界:不是所有知识都适合进组织记忆
很多企业做学习体系的时候,总想着要把所有的信息都塞到知识库里,恨不得把每个部门的文档、每封邮件、每次会议纪要都上传上去,显得知识库内容特别丰富。但真的用起来就会发现,找个有用的信息要翻几十页的无效内容,检索的时间比自己重新摸索的时间还长,最后大家干脆就不用了。
实际上,有三类知识根本不适合强制要求员工沉淀到公共知识库:
第一类是高度依赖个体直觉的判断。比如资深销售跟客户谈合作的时候,怎么从对方的语气、回复的速度里判断真实的预算和决策周期,这些内容是员工在十几年的从业经历里慢慢磨出来的直觉,根本没法写成标准化的操作手册,你硬让他写,他也只能编点正确的废话凑数。
第二类是跟特定项目强绑定的临时信息。比如某个短期项目的临时对接人联系方式、项目周期内的临时协调规则,等项目结项三个月之后,这些信息就完全失去了价值,塞到知识库里只会增加检索的噪音,让真正有用的内容被埋掉。
第三类是涉及跨部门协作矛盾的敏感经验。比如员工在项目推进中碰到的部门墙、推诿扯皮的情况,这些内容如果强制要求公开写出来,大家反而会藏着掖着,根本不会说真话,最后知识库里面全是歌功颂德的表面文章。
那到底什么内容值得沉淀?就是那些重复出现的、能实实在在减少一线试错成本的内容。比如同样的客户投诉,之前已经有三个同事处理过了,把当时的处理路径、客户的核心诉求、最后双方都能接受的方案整理出来,这才是真的有价值的学习素材。
这里还要提一个很容易踩的坑:很多企业为了追求知识库的“丰富度”,给每个部门定了每月要上传多少篇文档的考核指标。结果大家为了凑数,把网上随便能搜到的通用行业报告、没有任何针对性的管理鸡汤都传上去,整个知识库看起来内容好几千篇,实际上跟自己的业务半毛钱关系没有,最后变成了一个没人维护的数字垃圾场。
别把AI当成帮员工刷课的工具
 别把AI当成帮员工刷课的工具
现在很多企业上了大模型,第一反应就是把原来的录播课、知识库文档都喂给大模型,让员工可以随时问大模型知识点,觉得这样就实现了智能化的学习。实际上这根本是把AI用错了地方。
真正能帮组织降低学习成本的AI应用,从来不是帮员工更快刷完课程,而是当组织记忆的“自动分拣员”。比如平时员工在企业微信的沟通记录、项目文档、客户售后的聊天记录里,AI可以自动识别出那些重复出现的、有实用价值的经验,自动整理成可检索的短笔记,根本不需要员工专门抽时间写。
之前接触过一个做跨境电商的客服团队,他们根本没有专门的知识沉淀环节,AI自动把客服跟客户的聊天记录里的高频售后问题、对应的解决方案提取出来,整理成动态更新的应答手册。新进来的客服根本不需要花两周时间参加集中培训,碰到问题直接查手册就能上手,团队的整体响应速度提了近40%。
当然这里也有明确的边界:AI不能替代人对知识的最终校验。之前有个团队的大模型自动提取内容的时候,把之前给某个特殊客户的专属折扣政策,当成通用规则写进了应答手册,结果新来的客服给所有咨询的客户都报了这个折扣,前前后后亏了近三十万。所有自动提取的内容,还是需要业务端的人定期审核校准,不然错误的经验传播得越快,给组织造成的损失就越大。
上次跟那个砸了两百万做知识库的服务商老板吃饭,他说之前总觉得组织学习是个很虚的事,要靠大家的自觉性,要靠企业文化的熏陶。后来才发现,根本不是大家不自觉,是你搭的机制,从一开始就没站在一线员工的角度想问题。
说白了,你要是让员工学的东西,能帮他少加班、多拿奖金,他根本不用你催。
你要是让他学的东西,跟他每天干的活半毛钱关系没有,就算你装了监控盯着他看屏幕,他也会在脑子里盘算晚上下班去吃什么。