被低估的校准:重新理解系统效能评估
被曲解的评估目标:不是打分,是找病灶
大部分人对这件事的认知都错了。从诞生之初,它的核心就不是给系统盖一个“合格”或者“优秀”的戳,而是在复杂的耦合关系里,找到哪里拖了后腿,哪里留了余量。
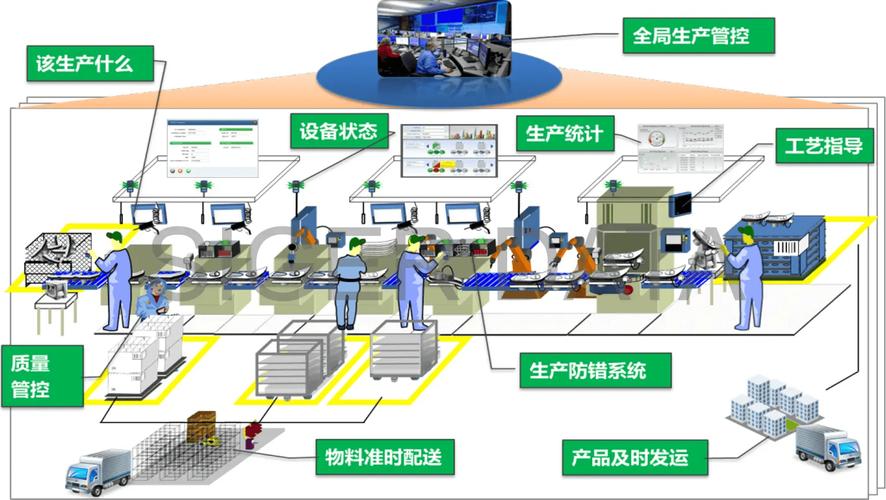 智能制造产线系统效能瓶颈定位图
前几年跟着朋友去看一个城轨项目的复盘,供应商给的评估报告里,所有指标都符合验收要求,甚至有三项还超标了。可早高峰的时候,新线的信号系统就是会卡那么三五秒,天天被乘客投诉。查来查去才发现,评估阶段用的测试数据全是平稳均匀的发车流量,根本没模拟早高峰站台上一下子涌进去两三千人的突发脉冲,信号系统处理拥堵的冗余设计根本没触发测试,当然全达标。真的,白瞎了大几千万的投入,就因为评估的时候走了过场,把找病灶的事做成了发奖状。
很多团队做评估,上来就先定指标权重,凑齐几十个维度打个分,最后加总出一个百分制的结果,看起来科学,实际上把最核心的问题掩盖了。系统里各个模块的联动损耗,极端场景下的性能跳水,这些才是最影响实际使用的东西,可这些往往因为不好量化,就被放到了权重极低的位置,甚至直接忽略。
非稳态场景下的核心矛盾:怎么处理不确定项
过去的评估方法,大多是给稳态系统设计的。什么是稳态系统?就是输入可控,边界清晰,所有变量都能放在实验室里测一遍。可现在越来越多的新系统,天生就是非稳态的。边界模糊,输入随机,你根本没办法用固定的指标框住它。
比如现在企业都在用的大模型驱动的智能客服,很多评估只算“问题解决率”“平均响应时长”,这两个指标漂亮就算效能好。可实际上,智能客服解决不了的问题转人工的时候,会不会把用户前面十几分钟的对话历史全部清空,需要用户再说一遍?这个衍生的负向体验,会不会增加人工客服的工作负担?这件事很多评估模型根本不会算进去。
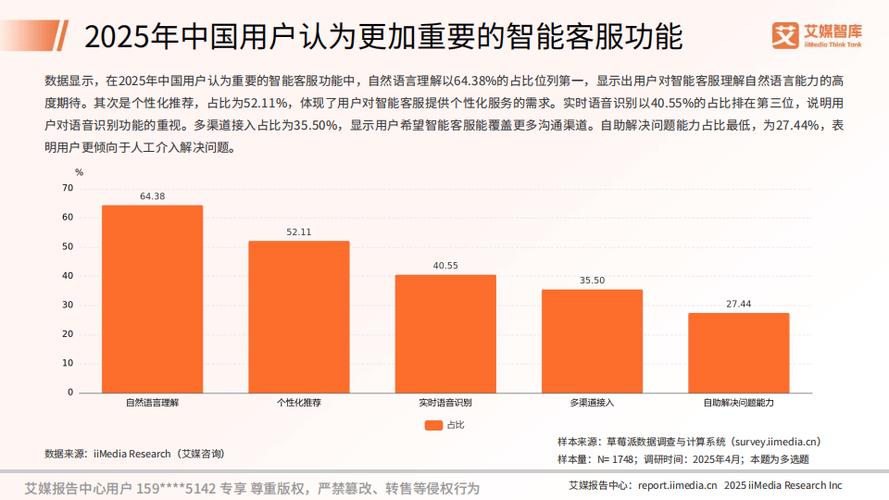 大模型智能客服效能影响因子权重分布图
现在行业里通行的做法,是把所有不确定的、不好量化的项都归为“系统误差”,直接剔除出评估范围。可讽刺的是,大部分系统出问题,恰恰就出在这些被剔除的不确定项里。
之前看到过一个案例,南方某地的智慧防汛系统,验收评估的时候准确率超过95%,各项指标全优,结果一场超标准洪水过来,系统直接发错了预警等级。追查原因才发现,评估的时候为了方便计算,把流域内多个水库联动的调度延迟给平均化了,没有考虑极端情况下来不及调度的时间差,就是这个被忽略的不确定项,直接让整个系统的效能打了对折。
说实话,很多做评估的人都在避重就轻。好算的指标往死里权重拉满,不好算的就往后躲,反正最后出个合格结论就行,出了问题也不是评估的锅。
可落地的实现路径:别追求完美,先分层校准
 可落地的实现路径:别追求完美,先分层校准
我见过太多追求完美评估框架的方案,最后落地的时候全死了。模型搞的几百层,谁都看不懂,算一次要跑三天,根本不可能日常用。其实不用搞那么复杂,先分层校准,就能解决80%的实际问题。
第一层是边界锚定,先搞清楚这个系统到底能干什么,不能干什么,在什么场景下生效,什么场景下不生效。别上来就算整体效能。比如自动驾驶的测试评估,你先把能覆盖的城市道路、雨天雾天、夜间行车这些边界一块一块标清楚,每个边界内算各自的效能,比你混在一起算一个总分数有用的多。
第二层是动态权重分配,别一套权重用到黑。同样一个城市交通调度系统,平峰的时候,通行效率的权重肯定最高,早晚高峰的时候,排队疏散速度的权重就得往上调,要是碰上突发事故,那应急响应速度就是第一权重,所有其他指标都得往后靠。固定权重看起来统一规范,其实脱离实际。
第三层是负向效能记账,一定要把系统带来的衍生成本算进去。很多数字化系统,看起来把原来人工的活干了,效率提升了,但是每个月要花几十万做维护、更新模型、修bug,还要养专门的技术团队,这个隐形成本原来很多评估根本不算,等到上线了才发现,省下来的钱还不够维护成本,这能叫效能好?
不过话说回来,这套分层方法也有它的应用边界。如果是完全从0到1的创新系统,没有任何历史数据做参照,那你就别硬套量化框架,先做定性分析就好,硬凑出来的数字毫无意义。如果本身就是为了应付验收走流程的项目,那再科学的方法也没用,人家要的就是一个合格结论,你讲半天道理也没用。
这里还有一个容易被忽略的点,就是评估的反向激励。很多单位把评估结果和项目团队的绩效直接绑定,结果就是团队为了拿高分,刻意回避难的场景,挑容易出成绩的部分做。比如说,很多地方的政务服务线上系统,为了提高“一次办结率”,把很多复杂的事项直接设置成“请线下办理”,线上根本不接收材料,那数据当然好看,可办事的群众一点好处都没捞着,这套评估反过来害了用户。
现在越来越多的团队开始把评估嵌到系统的日常运行里,不用等项目验收再做一次,边跑边评,实时调参数,这个方向肯定是对的。但也要注意,过度的评估数据采集本身也会占用系统的资源,反而拉低整体的运行效率,这个度得慢慢摸。说白了,所有的工作,本质都是帮我们看清系统里的堵点,不是为了做一张好看的报告给别人看。