算力网络:把散落在全国的“计算碎片”拼成未来生产力
上个月去南方某算力枢纽参会,饭桌上跟运营商负责项目的老大哥聊天,他说的一句话,当场把我惊着了。
现在客户找他们,第一句话不是问能拉多大带宽了,是问“能不能给我调一百P算力过来用三个月”。
放五年前,谁敢想算力能像带宽一样按需调?
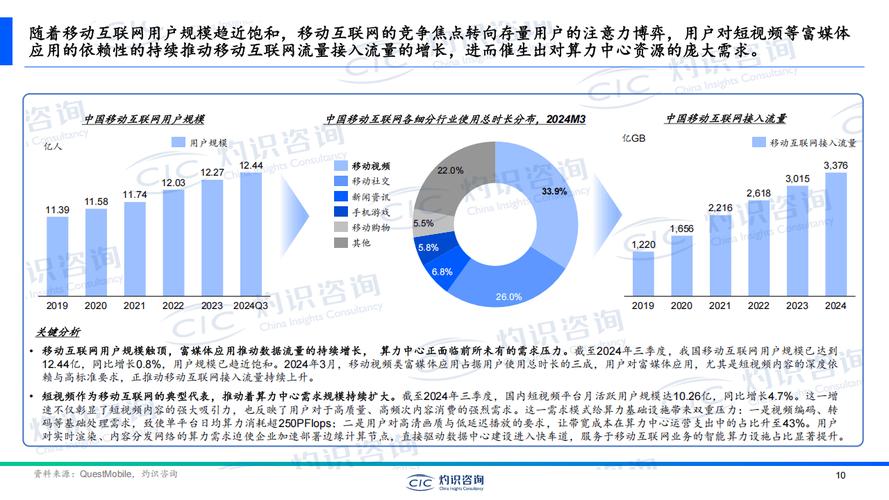 传统分散数据中心算力利用率对比柱状图
我前段时间看信通院的公开数据,国内存量数据中心的平均算力利用率还不到50%。一半的计算资源就这么浪费着,另一边无数AI创业公司抢不到算力,只能停掉项目等机位。
算力网络干的就是把这些插排连起来的活。
算力网络不是建更多新机房,是把已经建好的闲散算力盘活,像电网输电能一样,哪缺算力输到哪。东数西算推进到第三年,很多人还没反应过来,核心不是把东部的数据搬到西部存,是把西部闲置的算力给东部用,靠的就是算力网络当骨架。
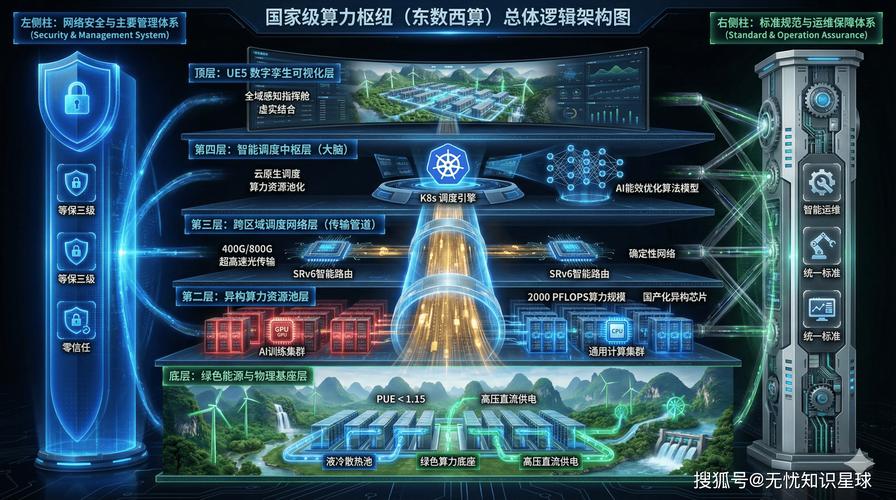 东数西算算力网络节点调度实景图
工业领域用得更早。珠三角做汽车零配件的工厂,生产线要跑AI质检模型,以前要么自己买服务器堆车间,成本高利用率低,要么把数据传到千里外的大算力中心,延迟高还怕数据泄露。现在呢?直接通过算力网络调用百公里外另一个城市边缘节点的闲置算力,延迟压到10毫秒以内,成本比自己买服务器降了六成。
太香了。
不过话说回来,很多人对算力网络的理解错得离谱。算力网络的核心从来不是“算力”,是“网”。以前的互联网是传数据的,现在的算力网络,是带着算力一起传数据。你不用为了算一个任务,把几十T的数据整坨搬到千里之外,也不用花大价钱把算力整坨拉到你门口,网络直接把计算任务拆分,调度到离你最近、闲著的算力节点上,算完把结果给你就行。
这才是真的算力网络。
 接下来要闯的坎,比建网难多了
现在能跑试点,能做项目,不代表全行业铺开就一帆风顺。
第一个坎就是标准不统一。不同厂商的服务器、不同运营商的网络、不同云厂商的调度接口,现在还是各玩各的。你想从A运营商的网络调度B云厂商放在C节点的算力,还要走一堆人工审批,接一堆定制接口,折腾半个月才能连上,根本做不到随用随调。
第二个坎是计价体系没跟上。现在算力都是按年卖机位,按月卖流量包,未来算力网络要做到像水电一样,用多少算多少钱,用一小时付一小时的钱,弹性扩缩容,这个计价、结算、计量的体系,现在还没摸出成熟的路。
还有最关键的安全问题。算力调度过程中,计算任务会不会被劫持?敏感数据会不会泄露?怎么给不同等级的算力做安全隔离?这些问题现在都还在一个个磨试点。
但是啊,哪有新基础设施一开始就是完美的?当年全国电网刚建的时候,各个省的电压都不统一,不也一点点磨成了现在插插头就能用的样子?
现在所有人都盯着大模型炒热点,抢参数卷规模,却很少有人提,算力网络才是真正能让AI落地的底座。没有能按需调度的便宜算力,大模型永远只是少数头部公司玩得起的游戏,中小创业公司拿不到弹性算力,根本没机会做创新。
我那天跟老大哥道别,他站在高铁站口抽烟,风把烟吹得歪歪扭扭,他说再给三年,你看。以后要用算力,就像现在开自来水龙头一样,开了就有,用多少算多少钱。那时候,才真的是AI的春天。
对吧。
别再把算力当机房里的死砖头了
很长一段时间里,算力就是堆在机房里的固定资产。大公司建自己的机房,中小公司买云厂商的算力包,超算中心养着一堆高性能机器,大部分时间闲着落灰,小公司想用还排不上队。 说白了,就是全国的算力像散落在各个房间的空插排,你在客厅手机没电,只能用客厅的插排,卧室的插排哪怕空着,你也用不了。 很多地方建数据中心,盯着GDP拼着上项目,建完才发现本地根本用不完那么多算力,一半机器都在空转耗电,连电费都赚不回来。传统分散数据中心算力利用率对比柱状图
我前段时间看信通院的公开数据,国内存量数据中心的平均算力利用率还不到50%。一半的计算资源就这么浪费着,另一边无数AI创业公司抢不到算力,只能停掉项目等机位。
算力网络干的就是把这些插排连起来的活。
算力网络不是建更多新机房,是把已经建好的闲散算力盘活,像电网输电能一样,哪缺算力输到哪。东数西算推进到第三年,很多人还没反应过来,核心不是把东部的数据搬到西部存,是把西部闲置的算力给东部用,靠的就是算力网络当骨架。
已经落地的算力网络,早就能干活了
说实话,我之前也以为算力网络是喊口号的概念,要十几年才能落地。结果今年跑了两个试点,直接打脸。 今年夏天AI大模型训练爆单,广州一批做垂直大模型的创业公司,本地算力抢完了,排机要等三个多月,直接通过三大运营商的算力 backbone,调度了贵州贵安节点的两百多P闲置算力,训练成本直接降了三成,不用等机位,拿到权限就能开跑。 还有做影视后期渲染的公司,以前做一部院线电影的特效,要在头部云厂商排队等一个月,现在直接打开算力网络的调度平台,挑全国最便宜的闲置算力,渲完把成品传回来就行,成本能砍一半还多。东数西算算力网络节点调度实景图
工业领域用得更早。珠三角做汽车零配件的工厂,生产线要跑AI质检模型,以前要么自己买服务器堆车间,成本高利用率低,要么把数据传到千里外的大算力中心,延迟高还怕数据泄露。现在呢?直接通过算力网络调用百公里外另一个城市边缘节点的闲置算力,延迟压到10毫秒以内,成本比自己买服务器降了六成。
太香了。
不过话说回来,很多人对算力网络的理解错得离谱。算力网络的核心从来不是“算力”,是“网”。以前的互联网是传数据的,现在的算力网络,是带着算力一起传数据。你不用为了算一个任务,把几十T的数据整坨搬到千里之外,也不用花大价钱把算力整坨拉到你门口,网络直接把计算任务拆分,调度到离你最近、闲著的算力节点上,算完把结果给你就行。
这才是真的算力网络。
接下来要闯的坎,比建网难多了
接下来要闯的坎,比建网难多了
现在能跑试点,能做项目,不代表全行业铺开就一帆风顺。
第一个坎就是标准不统一。不同厂商的服务器、不同运营商的网络、不同云厂商的调度接口,现在还是各玩各的。你想从A运营商的网络调度B云厂商放在C节点的算力,还要走一堆人工审批,接一堆定制接口,折腾半个月才能连上,根本做不到随用随调。
第二个坎是计价体系没跟上。现在算力都是按年卖机位,按月卖流量包,未来算力网络要做到像水电一样,用多少算多少钱,用一小时付一小时的钱,弹性扩缩容,这个计价、结算、计量的体系,现在还没摸出成熟的路。
还有最关键的安全问题。算力调度过程中,计算任务会不会被劫持?敏感数据会不会泄露?怎么给不同等级的算力做安全隔离?这些问题现在都还在一个个磨试点。
但是啊,哪有新基础设施一开始就是完美的?当年全国电网刚建的时候,各个省的电压都不统一,不也一点点磨成了现在插插头就能用的样子?
现在所有人都盯着大模型炒热点,抢参数卷规模,却很少有人提,算力网络才是真正能让AI落地的底座。没有能按需调度的便宜算力,大模型永远只是少数头部公司玩得起的游戏,中小创业公司拿不到弹性算力,根本没机会做创新。
我那天跟老大哥道别,他站在高铁站口抽烟,风把烟吹得歪歪扭扭,他说再给三年,你看。以后要用算力,就像现在开自来水龙头一样,开了就有,用多少算多少钱。那时候,才真的是AI的春天。
对吧。