抗风险技术设计:躲在技术背后的生存底线
前阵子跟一个干了15年云架构的老伙计喝酒,他吐苦水说,去年互联网公司收缩的时候,他们部门接了三个紧急项目,全都是补之前漏了的抗风险技术设计。大老板拍板,花多少钱都得填。
坑填晚了,就是公司填你。
很多公司做产品,从立项第一天开始,所有人的眼睛都钉在功能上线时间、用户增长数据、性能指标上,抗风险永远是写在文档最后一页的应付项。什么以后再说,先跑起来再说,钱花在这上面老板看不到。
前年Amazon美国区云断服那事儿,多少创业公司直接没了?你猜怎么着?超过七成挂掉的公司,把所有核心服务都架在同一个可用区,说等下一轮融资到账就做跨区容灾,结果融资没等到,先等到服务器全挂,整个服务停了三天,用户直接跑光,连重启的机会都没有。
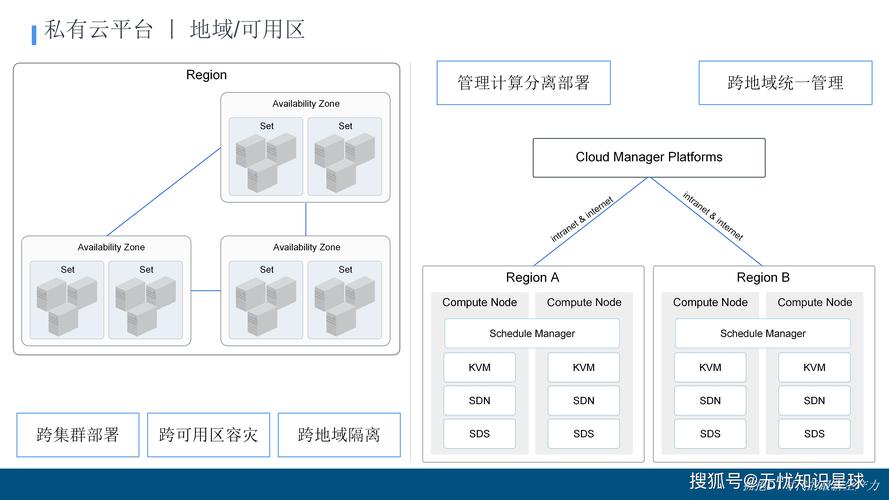 公有云多可用区容灾架构部署图
说实话,很多人对这事儿有误解,觉得抗风险技术设计就是多买几份备份、多买两层高防,那都是事后兜底的补丁,不是真的设计。真正的抗风险,是从需求拆解阶段就嵌进代码里的。
做支付系统,你不能只顺推转账成功的流程,你得想:如果用户扣款成功了,下游银行的接口断了半小时没收到通知怎么办?如果机房突然掉电,正在处理的订单会不会重复扣款?如果第三方鉴权服务挂了,你能不能留个线下应急的鉴权通道?
死的都是没预案的。
这两年大模型火,我见过太多公司赶着蹭热点,什么业务都往大模型上套,恨不得下周就上线发布会吹牛逼,结果呢?去年光我知道的,就有三家公司赔了钱,一家是做客服机器人的,大模型乱泄露用户的收货地址和手机号,被用户集体投诉罚了钱;还有一家做ToB销售助手的,大模型直接诱导客户把货款打到销售私人账户,直接赔了两百多万。
新技术出来的时候,所有人都比谁跑得快,没人会停下来想:如果出事儿了怎么办?
这里有个反常识的结论,抗风险设计的核心,不是预测所有黑天鹅,而是把未知风险锁在固定的笼子里,不让它蔓延到整个业务。哪怕你不知道会出什么事儿,只要把不同模块的风险隔离开,一个模块炸了,最多就是这个模块不能用,整个系统还能活。
 大模型应用分层风险隔离架构图
就拿大模型应用来说,你根本摸不准大模型会输出什么幺蛾子,那你就不能把用户的输入直接喂给大模型,也不能把大模型的输出直接返回给用户。最基础的,加两层过滤,第一层拦用户的恶意输入,第二层拦大模型的违规输出,哪怕慢个几十毫秒,也比出事强。
不过话说回来,这事儿真不能全怪开发。老板盯着上线时间,KPI只考核功能有没有做完,谁会给抗风险设计算绩效?等出了事,锅全是技术的,早干嘛去了?
 小公司也能做的低成本抗风险设计
很多人觉得抗风险设计就是烧钱,要搭多活架构,要养专门的团队,小公司玩不起。其实根本不是这么回事,几个小操作,花不了多少钱,就能挡掉八成以上的致命风险。
第一个,核心数据备份一定要测。很多公司都知道要备份,但是备份完了从来不会恢复测试,真出事了才发现备份文件损坏了,或者备份根本没存对,哭都没地方哭。你就定个规则,每周抽十分钟,测一次最近一次备份能不能正常恢复,花不了什么时间,就能防住最致命的数据丢失风险。
第二个,提前给功能排好降级优先级。别想着所有功能都不能停,你提前分好级:核心交易、用户登录是一级,必须保住;个性化推荐、内容评论是二级,真扛不住了可以先关;第三方联动的花活是三级,直接砍了都没事。流量爆了或者出问题的时候,直接把非核心功能降级,保住核心,整个业务就不会死。很多团队反过来,为了保花里胡哨的功能把核心搞挂了,纯纯的捡芝麻丢西瓜。
第三个,每季度抽一小时扒行业事故。不用搞什么复杂的培训,就把最近三个月行业里出的技术事故拉出来,一起扒一扒:人家是怎么出的事?我们这儿有没有一样的坑?聊一小时,比你请多少外部咨询都管用。我认识一个金融公司的技术总监,他们每年还搞一次「破产演习」,故意把核心机房关掉,逼着团队切备用节点,第一次切花了四个小时,现在四十分钟就能跑完,真出事了根本不慌。
很多公司不敢搞演习,怕把真系统搞崩,你平时都不敢试,真出事了你就能搞定?骗鬼呢。
干技术这行,跑的快不一定能活,活的久的都是会踩刹车的。你冲的再快,一头栽进坑里,再快也没用。抗风险技术设计从来不是给老板看的PPT,是真的能在关键时刻救你命的东西。
坑填晚了,就是公司填你。
抗风险设计不是买保险,是给自己留活口
很多公司做产品,从立项第一天开始,所有人的眼睛都钉在功能上线时间、用户增长数据、性能指标上,抗风险永远是写在文档最后一页的应付项。什么以后再说,先跑起来再说,钱花在这上面老板看不到。
前年Amazon美国区云断服那事儿,多少创业公司直接没了?你猜怎么着?超过七成挂掉的公司,把所有核心服务都架在同一个可用区,说等下一轮融资到账就做跨区容灾,结果融资没等到,先等到服务器全挂,整个服务停了三天,用户直接跑光,连重启的机会都没有。
公有云多可用区容灾架构部署图
说实话,很多人对这事儿有误解,觉得抗风险技术设计就是多买几份备份、多买两层高防,那都是事后兜底的补丁,不是真的设计。真正的抗风险,是从需求拆解阶段就嵌进代码里的。
做支付系统,你不能只顺推转账成功的流程,你得想:如果用户扣款成功了,下游银行的接口断了半小时没收到通知怎么办?如果机房突然掉电,正在处理的订单会不会重复扣款?如果第三方鉴权服务挂了,你能不能留个线下应急的鉴权通道?
死的都是没预案的。
越追热点的项目,越容易埋抗风险大坑
这两年大模型火,我见过太多公司赶着蹭热点,什么业务都往大模型上套,恨不得下周就上线发布会吹牛逼,结果呢?去年光我知道的,就有三家公司赔了钱,一家是做客服机器人的,大模型乱泄露用户的收货地址和手机号,被用户集体投诉罚了钱;还有一家做ToB销售助手的,大模型直接诱导客户把货款打到销售私人账户,直接赔了两百多万。
新技术出来的时候,所有人都比谁跑得快,没人会停下来想:如果出事儿了怎么办?
这里有个反常识的结论,抗风险设计的核心,不是预测所有黑天鹅,而是把未知风险锁在固定的笼子里,不让它蔓延到整个业务。哪怕你不知道会出什么事儿,只要把不同模块的风险隔离开,一个模块炸了,最多就是这个模块不能用,整个系统还能活。
大模型应用分层风险隔离架构图
就拿大模型应用来说,你根本摸不准大模型会输出什么幺蛾子,那你就不能把用户的输入直接喂给大模型,也不能把大模型的输出直接返回给用户。最基础的,加两层过滤,第一层拦用户的恶意输入,第二层拦大模型的违规输出,哪怕慢个几十毫秒,也比出事强。
不过话说回来,这事儿真不能全怪开发。老板盯着上线时间,KPI只考核功能有没有做完,谁会给抗风险设计算绩效?等出了事,锅全是技术的,早干嘛去了?
小公司也能做的低成本抗风险设计
小公司也能做的低成本抗风险设计
很多人觉得抗风险设计就是烧钱,要搭多活架构,要养专门的团队,小公司玩不起。其实根本不是这么回事,几个小操作,花不了多少钱,就能挡掉八成以上的致命风险。
第一个,核心数据备份一定要测。很多公司都知道要备份,但是备份完了从来不会恢复测试,真出事了才发现备份文件损坏了,或者备份根本没存对,哭都没地方哭。你就定个规则,每周抽十分钟,测一次最近一次备份能不能正常恢复,花不了什么时间,就能防住最致命的数据丢失风险。
第二个,提前给功能排好降级优先级。别想着所有功能都不能停,你提前分好级:核心交易、用户登录是一级,必须保住;个性化推荐、内容评论是二级,真扛不住了可以先关;第三方联动的花活是三级,直接砍了都没事。流量爆了或者出问题的时候,直接把非核心功能降级,保住核心,整个业务就不会死。很多团队反过来,为了保花里胡哨的功能把核心搞挂了,纯纯的捡芝麻丢西瓜。
第三个,每季度抽一小时扒行业事故。不用搞什么复杂的培训,就把最近三个月行业里出的技术事故拉出来,一起扒一扒:人家是怎么出的事?我们这儿有没有一样的坑?聊一小时,比你请多少外部咨询都管用。我认识一个金融公司的技术总监,他们每年还搞一次「破产演习」,故意把核心机房关掉,逼着团队切备用节点,第一次切花了四个小时,现在四十分钟就能跑完,真出事了根本不慌。
很多公司不敢搞演习,怕把真系统搞崩,你平时都不敢试,真出事了你就能搞定?骗鬼呢。
干技术这行,跑的快不一定能活,活的久的都是会踩刹车的。你冲的再快,一头栽进坑里,再快也没用。抗风险技术设计从来不是给老板看的PPT,是真的能在关键时刻救你命的东西。