开放数据平台:为啥说它是科研圈的隐形基建
上个月去参加国内生命科学界的年度闭门会,听到个事儿挺炸的。一个刚出站的博士后,靠扒公开的基因组数据,发了篇顶刊。而隔壁同方向课题组,花了两年砸了两百万做测序,原始数据还没整理完。你说气不气人?
这个博士后用到的,就是现在国内越来越完善的开放数据平台。很多人只听过名字,不知道它早就悄悄改变了科研圈的游戏规则。
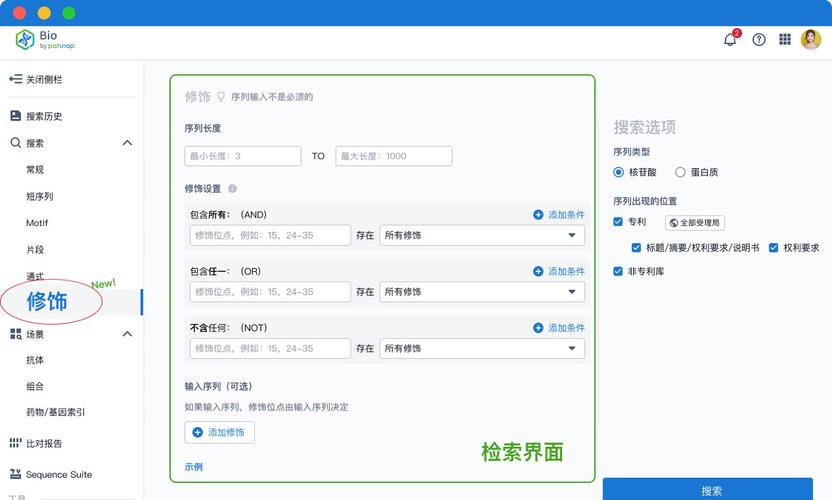 生命科学开放数据平台检索界面
我前两年帮一个硕士生改课题,他本来想做阿尔茨海默症的转录组差异分析,自己瞎找了三个零散公开数据集,拼在一起差异基因都对不上,蹲在实验室哭了快一周。后来我让他去国家基因库的开放数据平台找统一预处理好的整合数据集,人家已经把批次效应都处理完了,他半个月就跑出了核心结果,顺利毕业。
说白了,开放数据平台就是科研圈的共享厨房,食材厨具都给你备好了,但是你得会摘菜会开火,不是端上来就能吃的现成饭。会用的人,能省好几年的力气,不会用的,只能对着一堆数据骂骂咧咧说没用。
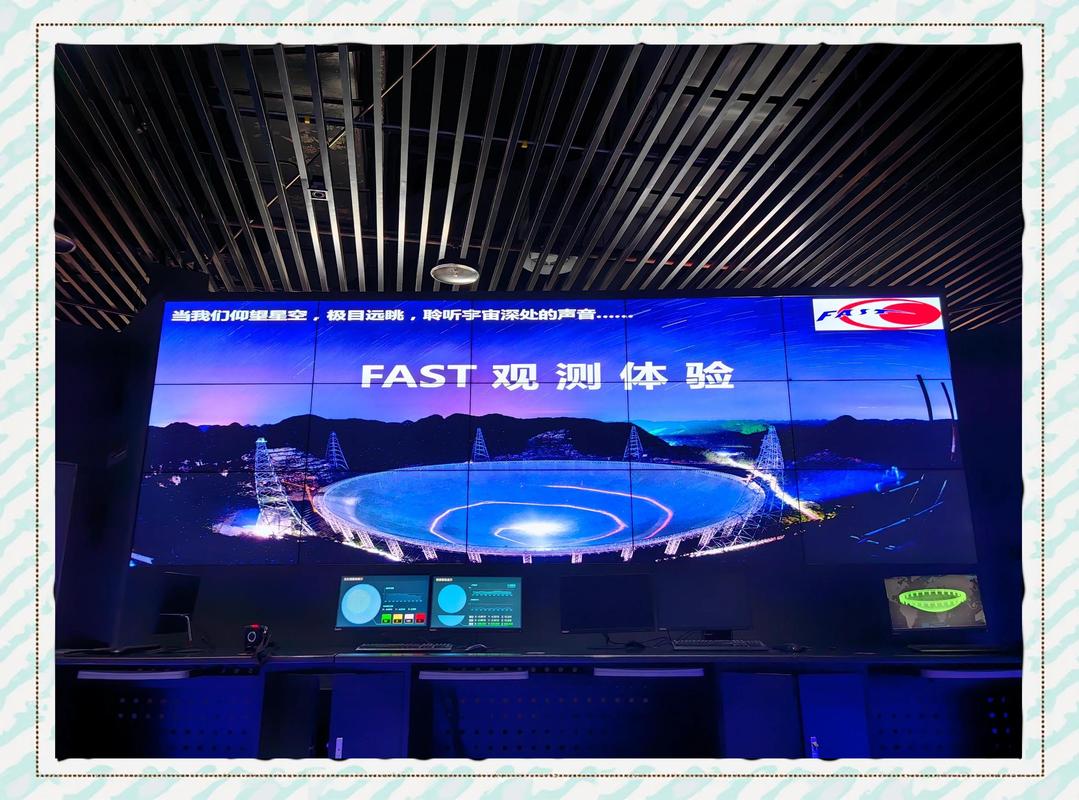 FAST开放天文数据平台在线分析页面
真正能打的开放数据平台,核心价值早就从“共享存储”变成“共享计算”了。
这几年高通量测序、天文观测、遥感探测这些领域,数据量涨得比房价还快,一个课题的数据动不动就几十上百个T,普通双非院校的超算中心,排个队都要半个月,很多年轻学者刚工作,没资源没设备,根本玩不起。有了开放数据平台,人家直接把数据和算力都给你准备好了,几千块钱都花不了,就能做顶刊级别的研究。这不就是把原来被头部院校垄断的科研资源,掰开了分给更多人吗?
前两年还有个大二的本科生,就在FAST的开放平台上自己挖数据,找到了新的射电暴信号,发了SCI,放在十年前,哪有这种机会?
 国内开放数据平台,还差哪一口气?
不过话说回来,国内的开放数据平台,比起国外老牌的,还是差了点意思。
最大的问题就是数据不通。你做个流域生态的研究,要水文数据、气象数据、土地利用数据、植被样方数据,水文局一个平台,气象局一个平台,生态环境部一个平台,中科院还有一个,你得注册四五个账号,填四五份申请,等好几个审批,折腾半个月才能把数据凑齐。真的烦。
其次就是维护跟不上。好多平台上线的时候热热闹闹,开完发布会就没人管了。用户上传数据出问题,搜不到教程,发邮件问客服半个月没人回,最后只能去B站找网友扒的野教程,说出去都好笑。还有些平台数据更新慢,去年发的论文要求存数据,今年年底了都搜不到,等于白存。
还有个观念上的坎儿。很多老研究员还是把自己攒的数据当家底,捂着不肯放,觉得我辛辛苦苦跑了十几年野外攒的数据,凭什么放给别人用?别人拿我的数据发了好文章,我不是亏了?
其实真不是。现在开放数据已经从加分项变成了科研的基本要求,你申请基金,评职称,开放共享做得好,本来就是加分项。而且你把数据放上去,别人用了就得引用你,你的引用量涨了,影响力上去了,只会更赚。我认识一个生态所的研究员,前年把自己十几年跑了几十个样点的植被数据全部公开,去年拿了千万级的重点项目,评审会上专门有人提,他的开放共享做得好,给学界做了大贡献。
不过这两年变化真的快,我五年前写基金,根本没听说过什么数据管理计划,现在申请任何国家级项目,都必须写清楚你的数据打算存在哪个开放平台,怎么开放,要求越来越明确了。
以后的科研,肯定是越来越开放的。原来拼是谁能拿到数据,谁能攒数据,以后拼的是谁会读数据,谁能从海量开放数据里挖出别人没发现的新东西。
开放数据平台从来不是什么高大上的概念,就是科研圈的公共马路。路修得越宽,跑的车越多,才能跑出更快的新发现。对吧?
科研圈的“共享厨房”,不是免费食堂
很多人对开放数据平台的误解还停留在:这不就是个放数据的公共网盘吗?谁都能下,白嫖就行。 真不是。说实话,正经的开放数据平台,从数据上传的标引,到格式统一,到版权说明,每一步都有规矩。就拿生命科学领域来说,NCBI的GEO,国内国家基因组科学数据中心的开放平台,要求上传者必须把测序的样本信息、处理参数、批次校正记录全部写清楚,不是随便扔个压缩包就完事儿。生命科学开放数据平台检索界面
我前两年帮一个硕士生改课题,他本来想做阿尔茨海默症的转录组差异分析,自己瞎找了三个零散公开数据集,拼在一起差异基因都对不上,蹲在实验室哭了快一周。后来我让他去国家基因库的开放数据平台找统一预处理好的整合数据集,人家已经把批次效应都处理完了,他半个月就跑出了核心结果,顺利毕业。
说白了,开放数据平台就是科研圈的共享厨房,食材厨具都给你备好了,但是你得会摘菜会开火,不是端上来就能吃的现成饭。会用的人,能省好几年的力气,不会用的,只能对着一堆数据骂骂咧咧说没用。
现在的开放数据平台,早就不止“存数据”了
最早搞开放数据,其实就是杂志社要求,你发论文必须把原始数据存进去公开,方便别人重复你的结果,说白了就是个存档库。 现在早就变了。我上个月听国家天文观测中心的朋友聊起FAST的开放数据平台,人家现在直接把分析工具都搭在了平台上。你不用把几个T的观测数据下载到自己电脑里——普通课题组哪有这么大的存储和算力?直接在线上传任务,平台用自己的超算帮你跑,跑完直接出结果。FAST开放天文数据平台在线分析页面
真正能打的开放数据平台,核心价值早就从“共享存储”变成“共享计算”了。
这几年高通量测序、天文观测、遥感探测这些领域,数据量涨得比房价还快,一个课题的数据动不动就几十上百个T,普通双非院校的超算中心,排个队都要半个月,很多年轻学者刚工作,没资源没设备,根本玩不起。有了开放数据平台,人家直接把数据和算力都给你准备好了,几千块钱都花不了,就能做顶刊级别的研究。这不就是把原来被头部院校垄断的科研资源,掰开了分给更多人吗?
前两年还有个大二的本科生,就在FAST的开放平台上自己挖数据,找到了新的射电暴信号,发了SCI,放在十年前,哪有这种机会?
国内开放数据平台,还差哪一口气?
国内开放数据平台,还差哪一口气?
不过话说回来,国内的开放数据平台,比起国外老牌的,还是差了点意思。
最大的问题就是数据不通。你做个流域生态的研究,要水文数据、气象数据、土地利用数据、植被样方数据,水文局一个平台,气象局一个平台,生态环境部一个平台,中科院还有一个,你得注册四五个账号,填四五份申请,等好几个审批,折腾半个月才能把数据凑齐。真的烦。
其次就是维护跟不上。好多平台上线的时候热热闹闹,开完发布会就没人管了。用户上传数据出问题,搜不到教程,发邮件问客服半个月没人回,最后只能去B站找网友扒的野教程,说出去都好笑。还有些平台数据更新慢,去年发的论文要求存数据,今年年底了都搜不到,等于白存。
还有个观念上的坎儿。很多老研究员还是把自己攒的数据当家底,捂着不肯放,觉得我辛辛苦苦跑了十几年野外攒的数据,凭什么放给别人用?别人拿我的数据发了好文章,我不是亏了?
其实真不是。现在开放数据已经从加分项变成了科研的基本要求,你申请基金,评职称,开放共享做得好,本来就是加分项。而且你把数据放上去,别人用了就得引用你,你的引用量涨了,影响力上去了,只会更赚。我认识一个生态所的研究员,前年把自己十几年跑了几十个样点的植被数据全部公开,去年拿了千万级的重点项目,评审会上专门有人提,他的开放共享做得好,给学界做了大贡献。
不过这两年变化真的快,我五年前写基金,根本没听说过什么数据管理计划,现在申请任何国家级项目,都必须写清楚你的数据打算存在哪个开放平台,怎么开放,要求越来越明确了。
以后的科研,肯定是越来越开放的。原来拼是谁能拿到数据,谁能攒数据,以后拼的是谁会读数据,谁能从海量开放数据里挖出别人没发现的新东西。
开放数据平台从来不是什么高大上的概念,就是科研圈的公共马路。路修得越宽,跑的车越多,才能跑出更快的新发现。对吧?