低碳计算技术:藏在万亿算力里的绿色新赛道
低碳计算不是虚概念,是算出来的真需求
前两年大模型爆火之后,全世界都在堆参数,从亿级跳到万亿级,训练一次的能耗有多恐怖?有公开论文算过,训练一个千亿参数的大模型,直接碳排放能超过500吨,差不多是一辆普通私家车开20年的总排放。这谁顶得住?再这么不加节制堆下去,再过十年,全球算力行业的碳排放就能赶上整个日本全国的排放量,这不是开玩笑。
原来做计算机科研,发顶会论文只比谁准确率高,谁的模型效果好。现在不一样了,大半顶会都要求作者标清楚模型的碳排强度,不比只比准确率,还要比每提升百分之一准确率消耗多少碳。说白了,就是逼着学界从根上改变对计算的评价标准。
别搞错了,低碳计算从来不是只给环保凑KPI,核心是从算法设计、硬件架构到算力调度全链条优化,把每一份算力的碳消耗实实在在降下来。
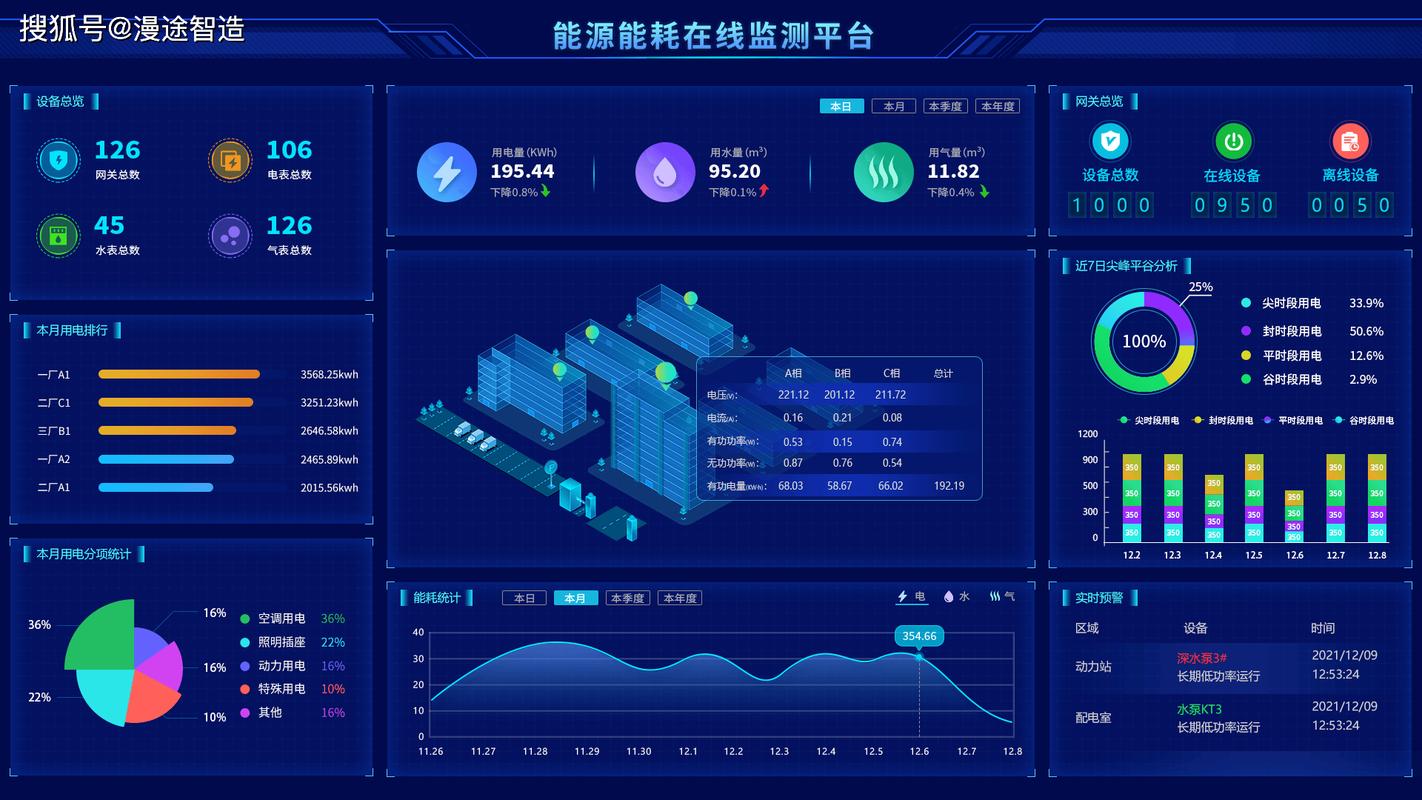 数据中心低碳计算能耗监测大屏实景
别觉得这只是大厂才需要考虑的事。现在国内算力租赁价格涨得有多快?去年到今年,高端GPU的租赁价格涨了快一倍,一方面是AI需求爆发,另一方面,电费和碳成本已经占了数据中心运营成本的六成以上。省碳就是省钱。这个逻辑太直白了,没人会和钱过不去。
当前低碳计算已经跑出了哪些落地成果?
我前阵子看中国信通院发的最新行业报告,现在技术路线其实已经很清晰,分多个层面落地,实打实出效果。
最直观的就是算法层面的优化,大家最熟悉的大模型稀疏化剪枝,就是把模型训练和推理过程中没用的冗余参数砍掉,大部分场景下,剪完之后模型效果只掉零点几个百分点,碳排和能耗直接砍一半多。今年上半年国内多家厂商发布的低碳大模型,推理能耗降了超过三成,推理速度还提了十几个百分点,这不就是双赢?
再往底层说就是硬件架构层面的创新,现在很火的近存计算、存算一体,原来的冯诺依曼架构里,百分之七八十的电都耗在数据在内存和计算核心之间的来回搬运上了。现在把计算挪到内存旁边,甚至直接用存储单元做计算,电能消耗一下子就降下来了,国内多家科研团队已经流片成功,实测能耗降了一半以上。
还有算力调度层面,咱们国家的东数西算工程,本质上就是低碳计算的超大实践——东部算力紧张、电价高,西部多风电光伏绿电、电价低,把对实时性要求不高的训练任务、离线计算任务,全调度到西部去跑,直接用绿电替换火电,碳排放一下子就降下来了,现在宁夏、贵州的节点已经承接了上亿核小时的离线计算任务,减碳效果非常明显。
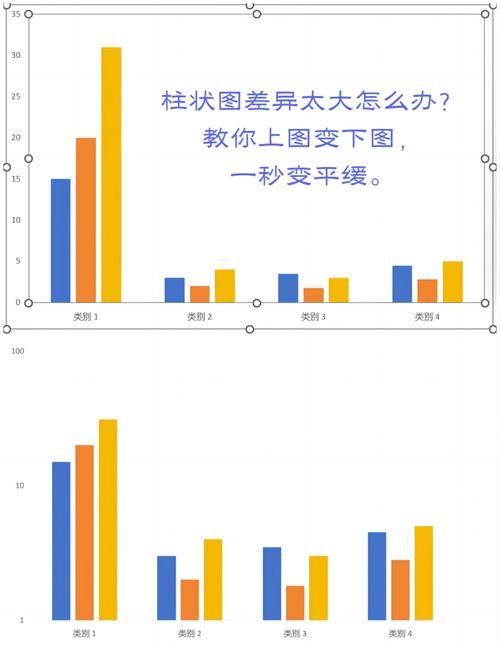 大模型稀疏剪枝前后能耗对比柱状图
我最意外的是边缘低碳计算这块,现在很多城市的智慧路口、安防摄像头,原来都是把数据全传回核心数据中心算,来回传输耗流量又耗电。现在直接把轻量优化后的模型放在边缘节点本地计算,不仅延迟低,整体能耗能降七成多。去年杭州在一百多个智慧路口试了,光一年每个路口就能省两三千度电,要是全城铺开,一年省几十万度电轻轻松松,都是实打实的成果。
热炒之下,还有哪些坎要过?
 热炒之下,还有哪些坎要过?
现在低碳计算火了,什么牛鬼蛇神都出来了。原来做数据中心普通节能改造的,换个PPT封皮就说自己做低碳计算,原来卖分布式光伏的,也说自己提前布局低碳计算。换个皮就出来割韭菜,吃相真的不好看。
不过话说回来,概念炒归炒,真实的需求和技术进步是骗不了人的。现在行业最大的问题其实是标准不统一,你说你的技术降了30%碳,我说我降了50%,到底怎么算?不同机构用不同的测算方法,结果差一倍都有可能,整个行业还没出来统一的碳足迹核算标准,这块也是现在科研攻关的重点。
还有很多中小创业者觉得,低碳计算是大厂玩的,和自己没关系。其实真不对,哪怕你是个做小程序的,把冗余的页面代码精简一下,把没用的后端定时计算砍掉,不仅用户加载变快,还省服务器电费,省下来的都是纯利润啊。
未来碳肯定会变成可交易的有价资产,你现在多降一克碳,未来就多一分竞争力。我上次和一个做芯片设计的老教授聊天,他说,二十年以前,整个行业比谁的计算速度快,十年以前,我们比谁的计算成本低,现在,我们要比谁的计算更低碳。算力越滚越大,需求越来越多,碳的账本,迟早要算到每一行代码、每一块芯片头上。低碳计算不是什么公益项目,是未来所有算力生意的入场券。对吧?