聊聊系统可靠性设计:从大厂宕机事故里抠出来的实战经验
去年双十一下午三点多,某头部电商的支付链路突然挂了十分钟,坊间传闻损失直接超过十亿。
后来内部流出的复盘写得很扎心——不是没加机器,不是没做容灾方案,核心链路一个不起眼的配置没做灰度,一次上线直接干崩了全链路。
很多人聊起系统可靠性,第一反应就是加预算、买机器、堆集群。
这真的错得离谱。
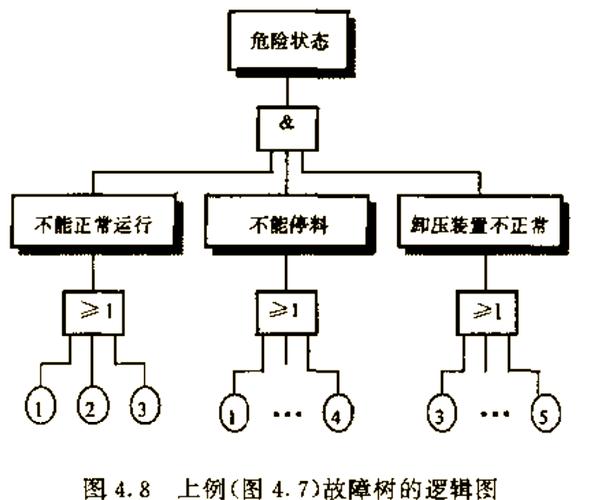 系统可靠性设计单点故障示意图
可靠性设计的核心,从来不是提升单个点的承载力,而是把风险打散,不让任何一个单点的死亡拖垮整个系统。
说白了就是,你得假设每个零件都会坏,然后想好它坏了之后怎么办。
冗余、故障隔离、降级、熔断,这些说烂了的概念,核心都是这个逻辑。
之前某头部短视频平台出过一次大范围的上传故障,原因就是一个边缘存储节点的硬盘故障,引发了连锁反应,因为没做租户隔离,直接拖垮了整个集群的写入能力。
要是设计的时候就把不同用户的存储资源隔离开,哪怕一个节点炸了,影响也不过百分之一的用户,根本不会闹得全站都用不了。
很多人说我花了那么多钱买机器,怎么还出问题?你把所有鸡蛋都放一个篮子里,哪怕这个篮子是金子做的,掉地上照样全碎。对吧?
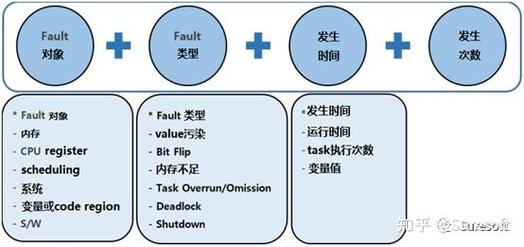 混沌工程系统故障注入测试流程图
真正靠谱的系统可靠性设计,都是"炸"出来的。
阿里大促之前,团队会定期主动干掉核心集群的几个节点,就看剩下的系统能不能正常扛住流量。
Netflix 更早,早在十多年前就搞了个"猴子军团",天天随机在生产环境砍服务,就是为了逼得你把可靠性做扎实。你主动找故障,总比故障在你最忙的时候找上门好一万倍。
很多小团队觉得混沌工程是大厂玩的高端东西,我们小项目养不起这个成本。
扯呢。你哪怕就花半小时,上线前把你的核心依赖停掉,看看你的降级逻辑能不能正常生效,把主数据库停了看看容灾切换能不能走通,这就是最有用的混沌工程。
我之前帮一个做客户管理SaaS的朋友调架构,他们天天念叨担心数据库出问题,做了主从复制却从来没试过切换。
我拉着他们找了个周末,直接把主库断电了,结果一测发现从库同步延迟了三个多小时,真出事儿客户数据都得丢。
后来赶紧调整了同步策略,改了切换逻辑,现在两年多了,再也没出过类似的幺蛾子。
要是当年没测,真等出问题再改,客户都跑光了。
 可观测性是可靠性设计的隐形底座
聊可靠性设计,十个人有九个会聊架构、聊冗余、聊容灾,很少有人提可观测性。
可你连系统哪儿出问题都不知道,谈什么可靠性?
我之前碰见过一个做直播的团队,他们做了三重节点冗余,理论上来说任何一个节点坏了都能自动切,可就是偶尔有不到百分之一的用户说卡顿,找了半个月都找不到问题在哪。
最后把全链路的日志、追踪都打通了,才发现是某个第三方存储的域名解析,在南方某运营商那里有缓存异常,刚好这个域名没加监控,之前所有测试都没覆盖到这个场景。
就这么一个不起眼的小问题,折腾了他们快一个月。没有可观测性,所有可靠性设计都是盲人摸象。
很多团队现在堆了一堆监控指标,面板上花花绿绿好几百个,真出问题了翻半天找不到哪个指标不对。
其实核心就是盯关键路径,你做电商,支付链路的成功率、每一跳的延迟就是核心,你做直播,帧率、卡顿率就是核心,别搞那些花里胡哨的无关指标占位置。
不过话说回来,现在云服务商的可观测性工具已经做的很成熟了,小团队根本不用自己从零造轮子,每个月花几百块钱就能把核心链路监控起来,性价比高得很。
一次宕机事故丢的,不止是当天的营收,还有用户攒了好几年的信任。
很多创业公司觉得我现在业务还没做起来,先堆功能,可靠性以后再说。
等你用户量上来了,一次故障就能把你攒了好几年的用户全带走,到时候再补,成本比现在高十倍都不止。
系统可靠性设计,本质上就是你愿意为未来的风险提前买一份保险。
这份保险,买得越早,越划算。
别拿堆机器当系统可靠性设计的全部
我前两年帮一个创业公司做架构评估,老板拍着胸脯说我们可靠性做得到位,平时流量十万,我们买了一百万流量容量的机器,绝对不会崩。 结果当年做618活动,刚开场十分钟就全挂了。 排查下来差点笑出声——整个支付回调的核心逻辑,只部署了一个实例。 所有流量都打在这一个实例上,哪怕你集群有一百台空闲机器,根本接不到请求啊! 这不是容量不够,这是从设计根儿上就没考虑可靠性。系统可靠性设计单点故障示意图
可靠性设计的核心,从来不是提升单个点的承载力,而是把风险打散,不让任何一个单点的死亡拖垮整个系统。
说白了就是,你得假设每个零件都会坏,然后想好它坏了之后怎么办。
冗余、故障隔离、降级、熔断,这些说烂了的概念,核心都是这个逻辑。
之前某头部短视频平台出过一次大范围的上传故障,原因就是一个边缘存储节点的硬盘故障,引发了连锁反应,因为没做租户隔离,直接拖垮了整个集群的写入能力。
要是设计的时候就把不同用户的存储资源隔离开,哪怕一个节点炸了,影响也不过百分之一的用户,根本不会闹得全站都用不了。
很多人说我花了那么多钱买机器,怎么还出问题?你把所有鸡蛋都放一个篮子里,哪怕这个篮子是金子做的,掉地上照样全碎。对吧?
混沌工程才是可靠性设计的试金石
设计方案写得再漂亮,纸面推演一百次,都不如真砍你一刀来得实在。 说实话,我见过太多团队,容灾切换的文档写了几十页,步骤清晰得能当教材,真出问题要切的时候,发现切换脚本三年没人动过,依赖的权限早就被回收了,甚至连从库的同步都停了大半个月没人知道。 你说这设计有啥用?混沌工程系统故障注入测试流程图
真正靠谱的系统可靠性设计,都是"炸"出来的。
阿里大促之前,团队会定期主动干掉核心集群的几个节点,就看剩下的系统能不能正常扛住流量。
Netflix 更早,早在十多年前就搞了个"猴子军团",天天随机在生产环境砍服务,就是为了逼得你把可靠性做扎实。你主动找故障,总比故障在你最忙的时候找上门好一万倍。
很多小团队觉得混沌工程是大厂玩的高端东西,我们小项目养不起这个成本。
扯呢。你哪怕就花半小时,上线前把你的核心依赖停掉,看看你的降级逻辑能不能正常生效,把主数据库停了看看容灾切换能不能走通,这就是最有用的混沌工程。
我之前帮一个做客户管理SaaS的朋友调架构,他们天天念叨担心数据库出问题,做了主从复制却从来没试过切换。
我拉着他们找了个周末,直接把主库断电了,结果一测发现从库同步延迟了三个多小时,真出事儿客户数据都得丢。
后来赶紧调整了同步策略,改了切换逻辑,现在两年多了,再也没出过类似的幺蛾子。
要是当年没测,真等出问题再改,客户都跑光了。
可观测性是可靠性设计的隐形底座
可观测性是可靠性设计的隐形底座
聊可靠性设计,十个人有九个会聊架构、聊冗余、聊容灾,很少有人提可观测性。
可你连系统哪儿出问题都不知道,谈什么可靠性?
我之前碰见过一个做直播的团队,他们做了三重节点冗余,理论上来说任何一个节点坏了都能自动切,可就是偶尔有不到百分之一的用户说卡顿,找了半个月都找不到问题在哪。
最后把全链路的日志、追踪都打通了,才发现是某个第三方存储的域名解析,在南方某运营商那里有缓存异常,刚好这个域名没加监控,之前所有测试都没覆盖到这个场景。
就这么一个不起眼的小问题,折腾了他们快一个月。没有可观测性,所有可靠性设计都是盲人摸象。
很多团队现在堆了一堆监控指标,面板上花花绿绿好几百个,真出问题了翻半天找不到哪个指标不对。
其实核心就是盯关键路径,你做电商,支付链路的成功率、每一跳的延迟就是核心,你做直播,帧率、卡顿率就是核心,别搞那些花里胡哨的无关指标占位置。
不过话说回来,现在云服务商的可观测性工具已经做的很成熟了,小团队根本不用自己从零造轮子,每个月花几百块钱就能把核心链路监控起来,性价比高得很。
一次宕机事故丢的,不止是当天的营收,还有用户攒了好几年的信任。
很多创业公司觉得我现在业务还没做起来,先堆功能,可靠性以后再说。
等你用户量上来了,一次故障就能把你攒了好几年的用户全带走,到时候再补,成本比现在高十倍都不止。
系统可靠性设计,本质上就是你愿意为未来的风险提前买一份保险。
这份保险,买得越早,越划算。