神经形态计算:突破AI功耗墙的换道新方向
前阵子去半导体行业论坛凑热闹,台上来了个清北系的年轻博导,放了张功耗对比图,当场把台下一堆做传统AI芯片的老炮看沉默了。
运行同一个大模型推理任务,英伟达A100功耗快300瓦。他们团队流片出来的神经形态原型芯片,不到0.8瓦。
没错,就是神经形态计算。这玩意儿不是学术圈圈经费的PPT画饼,已经实实在在跑出实验室了。
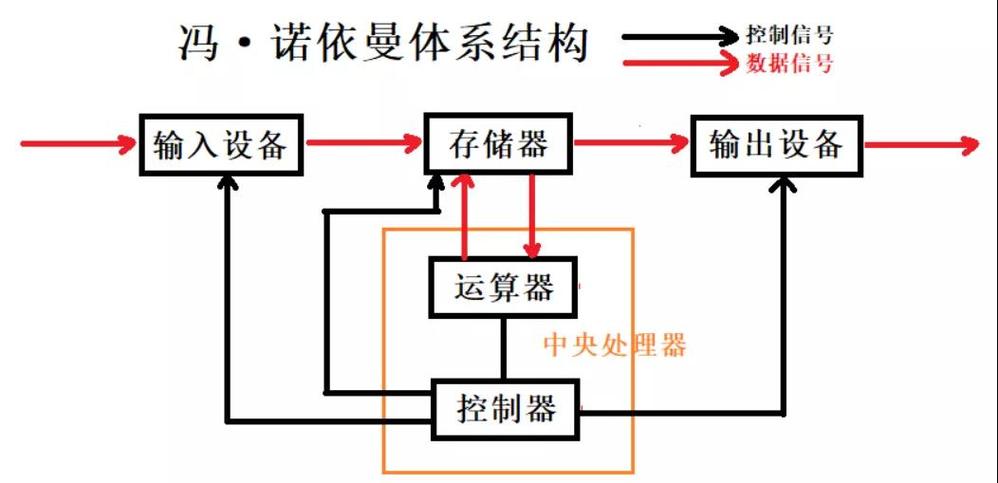 传统冯诺依曼与神经形态计算架构对比图
这种架构天生就适合跑AI类的稀疏计算,现在大模型不就是大部分参数闲置、只激活少数吗?完美对上需求。说白了,传统AI芯片是拿通用架构硬跑AI,神经形态计算是从根上重新做了一个专为AI设计的架构。
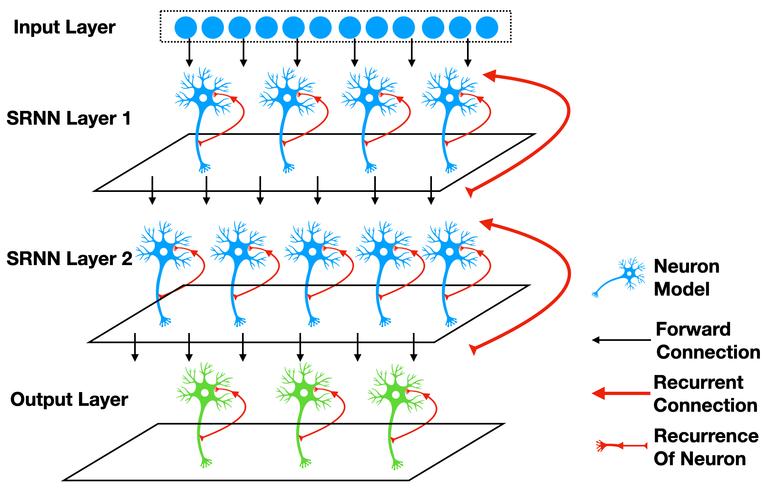 神经形态计算脉冲神经元工作原理示意图
现在落地最快的方向是边缘端。工业物联网的传感器,要长时间待机,还要做本地推理,不能动不动就传云端,功耗要求卡得极严,神经形态芯片进去直接碾压传统方案。还有可穿戴设备,植入式医疗设备,对功耗的敏感程度,根本轮不到传统芯片抢市场。
云端大模型这边也在试,现在很多大公司都在搭神经形态计算的集群原型,要是真能把功耗降一个数量级,数据中心能省多少钱?你算算。
 拦在量产前面的坑,一个都不少
不过话说回来,吹归吹,神经形态计算要取代传统GPU,那还早得很。坑太多了。
第一个大坑就是算法和生态。现在整个AI行业都是基于传统深度学习,开发工具链全是给CUDA这套生态做的,开发者已经熟得不能再熟了。神经形态计算主流用脉冲神经网络,训练方法和传统的完全不一样,想把训练好的大模型迁移过去,得重新调架构重新训,成本太高。新的开发框架也不成熟,没几个人会用,生态建不起来,就没人愿意用,没人用就更建不起生态,死循环。
第二个坑是器件。现在很多高性能神经形态芯片用忆阻器做突触,忆阻器的一致性和良率现在还上不去,做大阵列良率直接掉下来,批量生产成本降不下去,比传统CMOS工艺贵多了,没法大规模量产。也就小尺寸的边缘芯片能做做,大芯片还得等工艺成熟。
还有人吐槽,说神经形态计算现在只能做小模型,做大模型还是不行。这话其实也没错,现在能跑7B已经是不小的突破,要跑几百B参数的大模型,还有得熬。
可那又怎么样呢?十年前谁能想到AI能走到今天这个样子?当初Transformer刚出来的时候,不也一堆人说没用?摩尔定律已经快撞到墙了,现在不管是学术界还是工业界,都在找新方向,神经形态计算是目前看来最有戏的那一个。
上次那个博导说,他们团队接下来要流片的新原型,目标是把13B大模型的推理功耗控制在10瓦以内。要是真成了,你说,以后揣个十几瓦的神经形态设备,就能本地跑满血大模型,不用连云端,不用怕隐私泄密,这体验不比现在强一万倍?
路还长,但方向已经对了。咱们走着瞧。
别再挤摩尔定律的独木桥了
现在做大模型的圈子,焦虑都写在脸上了。模型参数一年翻十倍,芯片性能却跟不上,功耗涨得比性能还快。数据中心建一个,光是供电一年就烧几个亿,普通人用不起,小企业更是玩不起。 所有人都在往摩尔定律的独木桥上挤,拼工艺,拼7nm拼3nm,一片晶圆卖几十万,钱烧得跟倒水似的,可边际效应越来越明显。工艺往1nm走,难度是指数级涨的,连台积电都开始挠头。 那换个思路呢?我们造芯片,为什么不能直接模仿人脑? 人脑才20多瓦的功耗,就能处理视觉、语音、推理,同时干十几件事儿都不费劲。核心原因就是,人脑的神经元只有被脉冲触发的时候才会工作,才耗电,大部分时间都处于休眠状态。不像传统的冯诺依曼架构,不管你用不用,运算单元和内存都在不停地通电跑,功耗自然降不下来。 神经形态计算干的就是这个事儿:用硬件模仿人脑神经元和突触的连接方式,用脉冲信号传递信息,只在需要的时候激活,功耗直接砍几个数量级。传统冯诺依曼与神经形态计算架构对比图
这种架构天生就适合跑AI类的稀疏计算,现在大模型不就是大部分参数闲置、只激活少数吗?完美对上需求。说白了,传统AI芯片是拿通用架构硬跑AI,神经形态计算是从根上重新做了一个专为AI设计的架构。
现在的神经形态计算,已经走到哪一步了
说实话,很多人提起这个领域,第一反应都是“还得十年才能落地”。这话放到十年前说没问题,放到现在,早就过时了。 英特尔早几年就出了第二代Loihi神经形态芯片,能支持100多万个神经元连接,低功耗做手势识别、语音处理,早就开放给开发者测试了。国内中科院计算所的天机芯,第二代已经能同时支持多种脉冲神经网络和传统深度学习,功耗比同性能GPU降了两个数量级。去年国内还有初创公司流片了面向边缘AI的神经形态芯片,已经给智能家居客户送样了——用在智能门锁的语音唤醒上,一颗纽扣电池能跑两年,传统芯片连十分之一都做不到。 去年下半年,还有国内团队放出成果,用神经形态架构跑Llama 2 7B的推理任务,精度损失不到3%,功耗直接降到GPU的百分之一。这放在五年前,想都不敢想。神经形态计算脉冲神经元工作原理示意图
现在落地最快的方向是边缘端。工业物联网的传感器,要长时间待机,还要做本地推理,不能动不动就传云端,功耗要求卡得极严,神经形态芯片进去直接碾压传统方案。还有可穿戴设备,植入式医疗设备,对功耗的敏感程度,根本轮不到传统芯片抢市场。
云端大模型这边也在试,现在很多大公司都在搭神经形态计算的集群原型,要是真能把功耗降一个数量级,数据中心能省多少钱?你算算。
拦在量产前面的坑,一个都不少
拦在量产前面的坑,一个都不少
不过话说回来,吹归吹,神经形态计算要取代传统GPU,那还早得很。坑太多了。
第一个大坑就是算法和生态。现在整个AI行业都是基于传统深度学习,开发工具链全是给CUDA这套生态做的,开发者已经熟得不能再熟了。神经形态计算主流用脉冲神经网络,训练方法和传统的完全不一样,想把训练好的大模型迁移过去,得重新调架构重新训,成本太高。新的开发框架也不成熟,没几个人会用,生态建不起来,就没人愿意用,没人用就更建不起生态,死循环。
第二个坑是器件。现在很多高性能神经形态芯片用忆阻器做突触,忆阻器的一致性和良率现在还上不去,做大阵列良率直接掉下来,批量生产成本降不下去,比传统CMOS工艺贵多了,没法大规模量产。也就小尺寸的边缘芯片能做做,大芯片还得等工艺成熟。
还有人吐槽,说神经形态计算现在只能做小模型,做大模型还是不行。这话其实也没错,现在能跑7B已经是不小的突破,要跑几百B参数的大模型,还有得熬。
可那又怎么样呢?十年前谁能想到AI能走到今天这个样子?当初Transformer刚出来的时候,不也一堆人说没用?摩尔定律已经快撞到墙了,现在不管是学术界还是工业界,都在找新方向,神经形态计算是目前看来最有戏的那一个。
上次那个博导说,他们团队接下来要流片的新原型,目标是把13B大模型的推理功耗控制在10瓦以内。要是真成了,你说,以后揣个十几瓦的神经形态设备,就能本地跑满血大模型,不用连云端,不用怕隐私泄密,这体验不比现在强一万倍?
路还长,但方向已经对了。咱们走着瞧。