语音识别技术:从实验室走出来的十几年,到底改变了什么?
我上周去社区银行办社保卡更新,全程没碰笔没碰键盘,对着智能柜台说了不到五分钟,业务直接办完走人。换十年前你敢想吗?那时候语音识别就是个半残废,你说标准普通话它都能给你输出八竿子打不着的内容。对吧?
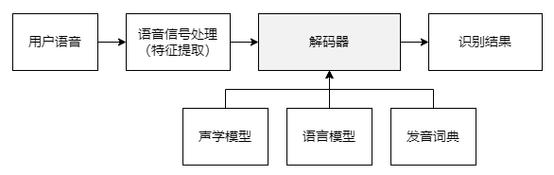 传统HMM语音识别模型流程图
大概从2010年之后,整个赛道的方向开始变了。
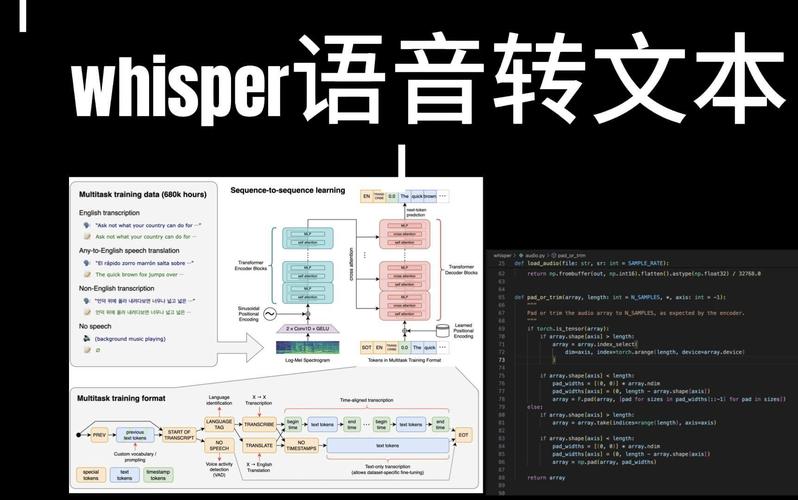 OpenAI Whisper语音识别模型架构图
我去年帮一个做独立纪录片的朋友剪片子,原来他找听译,一小时素材要40块人工钱,还得等两三天,现在把音频丢进Whisper,十分钟跑完,出来只需要改几个错字,成本直接砍到十分之一都不到。这就是技术落地的威力啊。
不过话说回来,现在的语音识别也不是没毛病。一群人同时抢着说话,背景还放着大声的音乐,别说识别内容了,把每个人的声音分开都难。还有我那台买了两年的油车,开高速风噪一大,我喊“调低空调温度”,它能给我打开天窗,差点把我头发吹成鸡窝,尴尬得要死。这点真没得洗,极端场景下的可靠性,还有得磨。
 语音识别技术早就变成了隐形基础设施
很多人说起语音识别,第一反应就是输入法的语音转文字,其实不对,它早就悄悄钻进了生活的每个缝隙。
你开车说“导航到公司”,背后是语音识别。外卖机器人打电话问你要不要放门口,能听懂你的回答,靠的是语音识别。养老院装的紧急呼叫,老人喊一声“救命”就能触发报警,用的也是语音识别。现在开线上会议,自动生成纪要,直播自动上字幕,全靠语音识别在背后撑着。
哪怕是现在火得一塌糊涂的大模型语音交互,第一步也是语音识别把你的语音转成文字,大模型才能处理,要是识别错一个字,意思差了十万八千里,后面大模型再厉害也白搭。所以说,语音识别就是所有语音AI的地基,没有它,什么智能音箱、语音助手全都是摆设。
现在国内的百度、阿里、字节这些大厂,都有成熟的语音识别云服务,常规安静场景下准确率做到98%以上已经是标配了,还针对不同场景做了专门优化:车载场景做了风噪路噪抑制,会议场景能自动区分不同发言人,远场场景做了拾音增强,这些都是十几年慢慢磨出来的进步。
最近两年还有一个方向挺火的,就是唇语辅助多模态语音识别,不光听你的声音,还通过摄像头捕捉你的唇动,背景越是嘈杂,唇语的辅助作用就越明显,好多论文里的测试结果,准确率能提升十几个点。说不定再过几年,我的车载语音再也不会乱开天窗了哈哈。
我刚上大学那会,语音识别还是专业课上用来讲解统计模型的冷门例子,毕业还没十年,抬头低头全都是它的应用。很多时候你甚至意识不到它存在,可它就是悄悄把很多原来需要手动做的麻烦事,给省掉了。
技术从来都不是一下子就变完美的,一步一步踩坑,一步一步优化,哪天回头看,才发现原来我们已经走了这么远。
早期的语音识别,本质就是算概率
别听现在大模型吹得玄乎,语音识别发展早期,跟现在的AI思路差远了。从上世纪八九十年代一直到2000年之后的快十年,主流方案一直是隐马尔可夫模型+高斯混合模型。说白了就是把连续的语音切成细碎的小段,然后对着提前建好的语料库算概率,哪一串文字匹配的概率最高,就输出哪一个。 说实话,那时候的准确率真的感人。你说“我要吃饭”,它能给你出“五万吃饭”,前后鼻音不分直接GG,带点地方口音更是想都别想,能对一半都算模型训练得好。 那时候也不是完全没应用,比如运营商的语音查话费,提前给你限定了十几个指令,你必须一字不差按要求说,稍微变个说法就直接罢工,根本做不到自由对话。传统HMM语音识别模型流程图
大概从2010年之后,整个赛道的方向开始变了。
深度学习直接掀翻了旧天花板
首先是深度神经网络替换掉了原来的高斯混合声学模型,原来的模型对复杂声学特征的拟合能力差得远,DNN一上线,整体识别准确率直接跳了十多个百分点,一下子就把原来达不到商用要求的门槛给跨过去了。 后来Transformer架构出来,端到端模型直接成了主流,把声学模型、语言模型全揉进一个网络里,输入语音直接输出文字,省了一大堆中间环节,准确率还能再往上冲。 最典型的就是OpenAI开源的Whisper,现在你随便找个懂点技术的朋友,下个开源包就能自己跑,带口音的四川话、广东话,甚至说着说着插几个英文单词,它都能给你识别得七七八八,错字少得惊人。放十五年前,这种效果说出去,谁信啊?OpenAI Whisper语音识别模型架构图
我去年帮一个做独立纪录片的朋友剪片子,原来他找听译,一小时素材要40块人工钱,还得等两三天,现在把音频丢进Whisper,十分钟跑完,出来只需要改几个错字,成本直接砍到十分之一都不到。这就是技术落地的威力啊。
不过话说回来,现在的语音识别也不是没毛病。一群人同时抢着说话,背景还放着大声的音乐,别说识别内容了,把每个人的声音分开都难。还有我那台买了两年的油车,开高速风噪一大,我喊“调低空调温度”,它能给我打开天窗,差点把我头发吹成鸡窝,尴尬得要死。这点真没得洗,极端场景下的可靠性,还有得磨。
语音识别技术早就变成了隐形基础设施
语音识别技术早就变成了隐形基础设施
很多人说起语音识别,第一反应就是输入法的语音转文字,其实不对,它早就悄悄钻进了生活的每个缝隙。
你开车说“导航到公司”,背后是语音识别。外卖机器人打电话问你要不要放门口,能听懂你的回答,靠的是语音识别。养老院装的紧急呼叫,老人喊一声“救命”就能触发报警,用的也是语音识别。现在开线上会议,自动生成纪要,直播自动上字幕,全靠语音识别在背后撑着。
哪怕是现在火得一塌糊涂的大模型语音交互,第一步也是语音识别把你的语音转成文字,大模型才能处理,要是识别错一个字,意思差了十万八千里,后面大模型再厉害也白搭。所以说,语音识别就是所有语音AI的地基,没有它,什么智能音箱、语音助手全都是摆设。
现在国内的百度、阿里、字节这些大厂,都有成熟的语音识别云服务,常规安静场景下准确率做到98%以上已经是标配了,还针对不同场景做了专门优化:车载场景做了风噪路噪抑制,会议场景能自动区分不同发言人,远场场景做了拾音增强,这些都是十几年慢慢磨出来的进步。
最近两年还有一个方向挺火的,就是唇语辅助多模态语音识别,不光听你的声音,还通过摄像头捕捉你的唇动,背景越是嘈杂,唇语的辅助作用就越明显,好多论文里的测试结果,准确率能提升十几个点。说不定再过几年,我的车载语音再也不会乱开天窗了哈哈。
我刚上大学那会,语音识别还是专业课上用来讲解统计模型的冷门例子,毕业还没十年,抬头低头全都是它的应用。很多时候你甚至意识不到它存在,可它就是悄悄把很多原来需要手动做的麻烦事,给省掉了。
技术从来都不是一下子就变完美的,一步一步踩坑,一步一步优化,哪天回头看,才发现原来我们已经走了这么远。