容器化部署技术:为什么它让运维工程师从加班里逃了出来
说实话我前两周帮一个创业团队救过一个线上故障,原因说出来你都不信——开发换了个人新服务器部署Java应用,本地跑的好好的,上线就是404,折腾了八个小时才找到是本地环境的依赖版本和服务器差了一个小版本。
换三年前这种事太常见了。别说跨服务器,哪怕就是同一个服务器装两个不同版本的PHP,都能打的你死我活。
直到容器化部署技术普及之后,这种破事儿才少了一大半。
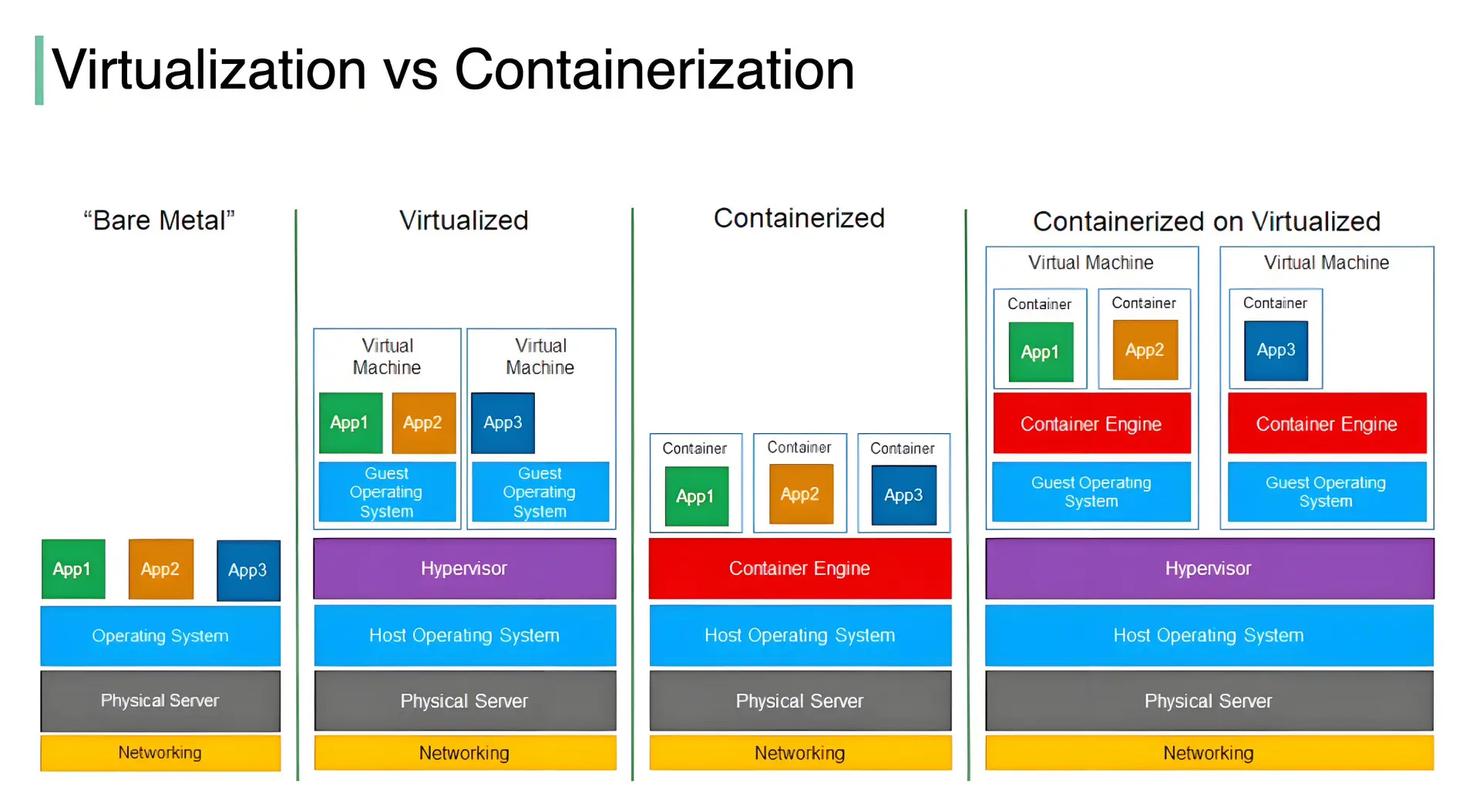 容器化与虚拟机架构对比图
很多刚接触的人会搞混镜像和容器,说白了一句话:镜像是那个打包好的“安装包”,是静态的,容器就是镜像跑起来的实例,是动态的。
我当年第一次跑通Docker,拉了个最小的Nginx镜像,十秒钟就启动成功,打开页面看到欢迎页的时候,差点拍桌子叫出来。
这才叫部署啊。以前那叫给应用当保姆。
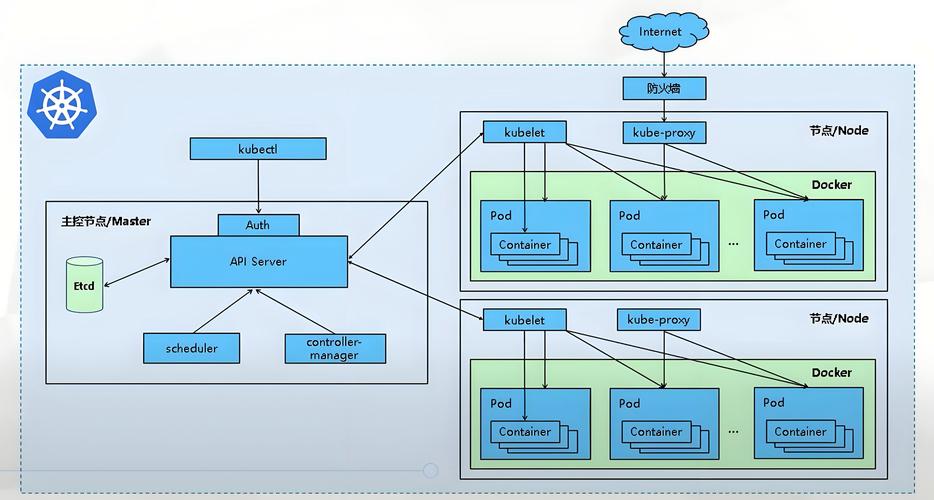 Kubernetes容器集群编排部署流程图
不过话说回来,真不是所有团队都要上K8s。
我见过太多一两台服务器跑三五个应用的小团队,非要折腾搭K8s集群,折腾了半个月,最后反而把自己套进去了,出了问题查都不会查。其实这种规模,用Docker Compose就足够了,一个配置文件管所有服务,一键启动,简单又好用,犯不着为了跟风搞那种重量级的东西。
去年有个CTO找我吐槽,说他们公司十个人不到,业务还没盈利,为了“符合云原生标准”,硬生生花了三个月搭了多可用区K8s集群,光云服务器成本每个月就花出去好几万,还专门招了一个K8s运维,成本直接翻了一倍,现在天天愁怎么砍预算。
适合自己的,才是最好的。这个道理放哪儿都对。
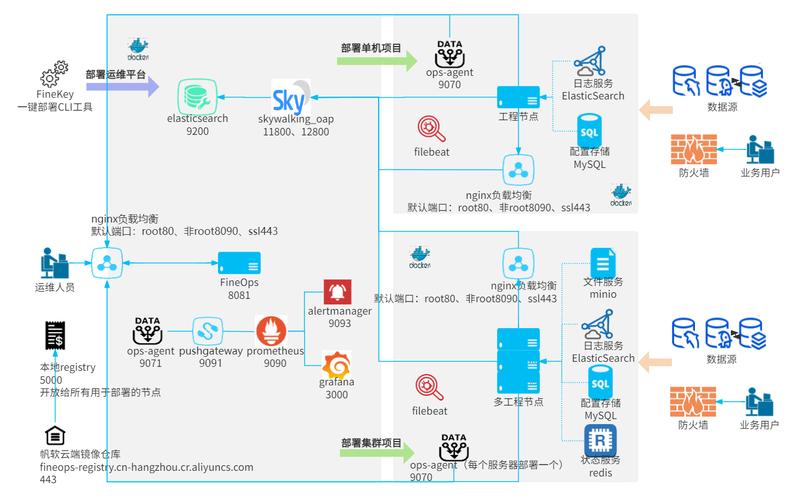 容器化部署最容易踩的坑,都是过来人踩出来的教训
容器化好用归好用,坑也不少,我见过太多新手刚上来就踩,摔得挺惨。我挑几个最常见的给你提个醒。
第一个坑,镜像做的太大,拉取慢还费存储。很多新手做镜像,图省事直接用那种几个G的完整版操作系统当基础镜像,然后把编译工具、源代码什么的全留在镜像里,最后打出来的镜像十几个G,每次发布拉镜像都要等十几分钟,遇上网络波动直接超时。其实只要用个多阶段构建,构建的时候把依赖和代码都弄好,打包的时候只把运行需要的东西放进去,编译工具源代码全扔掉,最后出来的镜像可能才几十兆,爽的不行。
第二个坑,忘了做数据持久化,容器一删数据全没。容器本身是无状态的,重启或者销毁之后,本地存的东西全都会清掉。很多新手不知道这个,把数据库数据直接存在容器本地,结果升级版本重新跑容器,所有数据全没了,产品经理当场就能跟你拼命。只要把数据存在外部的存储卷或者云存储上,不管容器怎么删怎么重建,数据都不会丢,这点一定要记死。
第三个坑,没给容器做资源限制,一不留神整个集群崩了。默认情况下,容器是可以用宿主机所有的CPU和内存的,要是某个应用出了内存泄漏,直接把宿主机所有资源吃光,同一个机器上跑的其他容器全都会跟着挂,一传十十传百,整个集群直接雪崩。这种故障我处理过不下三次,每次都是熬一整夜才能恢复,只要给每个容器配好内存和CPU的上限,就能避免绝大多数这种问题。
现在整个行业都在往云原生转,容器化部署技术就是整个云原生架构的底座,不管是微服务还是serverless,底层基本上都是容器跑的。对于开发和运维来说,不用再天天对着环境问题头疼,能把时间省下来做更重要的事,这本身就是最大的进步。
要是你现在还天天被环境问题折腾,天天加班改部署问题,真的可以抽两天时间试试容器化,不用上来就啃K8s那厚厚一大本文档,先从用Docker打包你自己的项目开始,用一次你就知道,回不去了。
从“配环境配到吐”到“一次打包到处跑”,容器化到底改了什么?
早些年做部署,要么就是直接在物理机上装应用,所有服务挤在一台机器上,你改个依赖我出个错,牵一发动全身。后来有了虚拟机,总算能把不同应用隔离开,可虚拟机那叫一个笨重——每个虚拟机要塞一整个完整的操作系统,启动要好几分钟,资源一半都浪费在了冗余的系统组件上,一台8核16G的物理机,跑个三四个虚拟机就卡的不行。 容器直接换了一套思路。 它不用给每个应用装一整套操作系统,直接共享宿主机的内核,只把应用本身和它需要的所有依赖、配置文件打包进一个镜像里。启动的时候直接跑,隔离开不同应用的运行空间,谁也不影响谁。容器化与虚拟机架构对比图
很多刚接触的人会搞混镜像和容器,说白了一句话:镜像是那个打包好的“安装包”,是静态的,容器就是镜像跑起来的实例,是动态的。
我当年第一次跑通Docker,拉了个最小的Nginx镜像,十秒钟就启动成功,打开页面看到欢迎页的时候,差点拍桌子叫出来。
这才叫部署啊。以前那叫给应用当保姆。
现在主流的容器化部署技术,真不是只有Docker
Docker当年确实是带火容器化的功臣,把原本门槛很高的容器技术做成了普通人能用的工具,但是发展到现在,整个技术栈早就分化了,不是说会用Docker run就算学会容器化了。 现在大部分生产环境,容器运行时都用了containerd,Docker本身现在其实也是把containerd当底层用,人家早就拆出来做成了中立的工业标准。而要是你有几十个上百个容器要管,那肯定绕不开K8s,也就是Kubernetes,做容器编排的。它帮你管调度、管扩容、管故障自愈,某个容器挂了它自动给你起个新的,不用运维半夜起来救火。Kubernetes容器集群编排部署流程图
不过话说回来,真不是所有团队都要上K8s。
我见过太多一两台服务器跑三五个应用的小团队,非要折腾搭K8s集群,折腾了半个月,最后反而把自己套进去了,出了问题查都不会查。其实这种规模,用Docker Compose就足够了,一个配置文件管所有服务,一键启动,简单又好用,犯不着为了跟风搞那种重量级的东西。
去年有个CTO找我吐槽,说他们公司十个人不到,业务还没盈利,为了“符合云原生标准”,硬生生花了三个月搭了多可用区K8s集群,光云服务器成本每个月就花出去好几万,还专门招了一个K8s运维,成本直接翻了一倍,现在天天愁怎么砍预算。
适合自己的,才是最好的。这个道理放哪儿都对。
容器化部署最容易踩的坑,都是过来人踩出来的教训
容器化部署最容易踩的坑,都是过来人踩出来的教训
容器化好用归好用,坑也不少,我见过太多新手刚上来就踩,摔得挺惨。我挑几个最常见的给你提个醒。
第一个坑,镜像做的太大,拉取慢还费存储。很多新手做镜像,图省事直接用那种几个G的完整版操作系统当基础镜像,然后把编译工具、源代码什么的全留在镜像里,最后打出来的镜像十几个G,每次发布拉镜像都要等十几分钟,遇上网络波动直接超时。其实只要用个多阶段构建,构建的时候把依赖和代码都弄好,打包的时候只把运行需要的东西放进去,编译工具源代码全扔掉,最后出来的镜像可能才几十兆,爽的不行。
第二个坑,忘了做数据持久化,容器一删数据全没。容器本身是无状态的,重启或者销毁之后,本地存的东西全都会清掉。很多新手不知道这个,把数据库数据直接存在容器本地,结果升级版本重新跑容器,所有数据全没了,产品经理当场就能跟你拼命。只要把数据存在外部的存储卷或者云存储上,不管容器怎么删怎么重建,数据都不会丢,这点一定要记死。
第三个坑,没给容器做资源限制,一不留神整个集群崩了。默认情况下,容器是可以用宿主机所有的CPU和内存的,要是某个应用出了内存泄漏,直接把宿主机所有资源吃光,同一个机器上跑的其他容器全都会跟着挂,一传十十传百,整个集群直接雪崩。这种故障我处理过不下三次,每次都是熬一整夜才能恢复,只要给每个容器配好内存和CPU的上限,就能避免绝大多数这种问题。
现在整个行业都在往云原生转,容器化部署技术就是整个云原生架构的底座,不管是微服务还是serverless,底层基本上都是容器跑的。对于开发和运维来说,不用再天天对着环境问题头疼,能把时间省下来做更重要的事,这本身就是最大的进步。
要是你现在还天天被环境问题折腾,天天加班改部署问题,真的可以抽两天时间试试容器化,不用上来就啃K8s那厚厚一大本文档,先从用Docker打包你自己的项目开始,用一次你就知道,回不去了。