科研圈的开源浪潮:聊聊改变科研生态的开源技术应用
上个月帮一个刚进组的博士生改实验计划,他对着电脑屏幕长吁短叹,说想做全转录组测序分析,商用工具的一年授权要十八万,他那点青年基金启动费,一半都要填进去,剩下的连买样本试剂都不够。
换五年前,这事儿基本就没辙,要么换方向,要么厚着脸皮去别的大实验室借授权。现在呢?他直接拉了开源的STAR比对工具加DESeq2差异分析包,花了三天跑通流程,一分钱没花,结果和商用工具出来的数据差不到1%。
这就是现在的开源技术应用,已经不是大佬圈子里的玩物了,早就沉到科研一线的骨子里了。
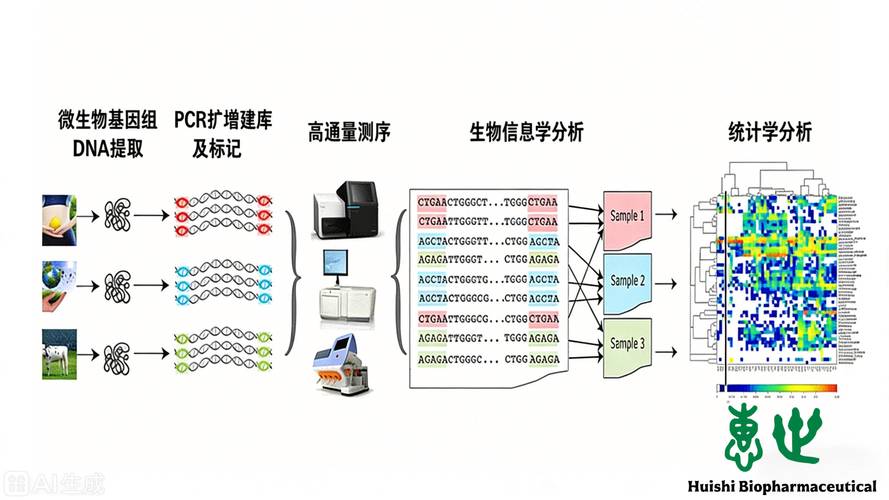 生物信息学开源测序分析工作流界面
不止生信,化学、材料、机械各个领域全覆盖。做分子动力学模拟,开源的GROMACS性能比大半商用软件都能打,课题组只要有几台带GPU的工作站就能跑,不用求爷爷告奶奶批百万级的软件经费。做材料相变模拟,原来收费的VASP alternatives里,开源的PWmat社区版精度不差,还能自己改参数加适配功能,这不香吗?
就连做人文社科的,现在都在用开源的文本分析工具,处理上亿字的古籍文献,原来要买几十万的商用数据库,现在开源的BERT预训练模型调一调,准确率比商用工具还高,还能自己针对特定领域训练,自由度拉满。
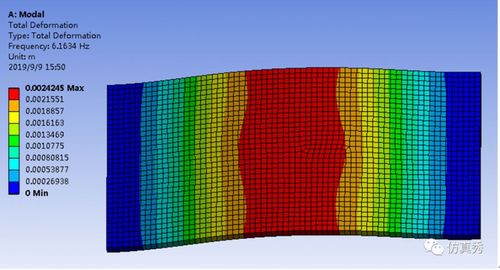 开源有限元仿真计算结果误差对比图
还有更坑的。很多做医学影像的年轻学生,直接拿Github上开源的预训练大模型权重就用,结果到了自己的临床数据上,准确率掉了快20个点,差点毕不了业。为什么?人家的模型是用欧美人群的肺癌数据训练的,你拿来算国内人群的鼻咽癌,能准才有鬼。
很多人对开源有误区,觉得拉了代码就能用,出了问题就是开源不好。说实话,大多数问题都是自己没做适配。开源给你的是工具和自由度,不是给你打包好的外卖,你总得自己调调味吧?
坑多归坑,只要你踩过一次记住了,后面得到的好处远远比坑多。省下的软件经费能多招两个学生,能多做三次实验,还能随便改代码适配自己的项目,不比每年给厂商交保护费强?
 开源正在重新拉平科研的入门门槛
我上个月去开国内科研软件的行业会,碰到一个来自西部普通二本的老师,他说原来他们学校全年的软件采购经费才不到二十万,根本买不起前沿研究需要的工具,想做项目只能挑别人剩下来的方向。现在全转成开源技术,不到三年已经发了四篇不错的SCI,还拿到了省里的青年基金,放在十年前想都不敢想。
这就是开源技术应用最厉害的地方,它不是帮顶级实验室省点钱,是把原来攥在少数机构手里的工具,放到了所有科研人员的面前。地方院校的普通学生,双非高校的年轻老师,都能用上和清北北欧美顶校一样的研究工具,不用因为买不起软件就做不了前沿研究。
现在国内很多高校和科技企业都开始搭自己的开源科研软件社区,不再全依赖国外Github,更新更快,出了问题还有国内的开发者能问,解决了原来卡网、没人答疑的老问题。很多顶刊现在也要求作者把研究用到的代码和工具开源,重复实验变得更容易,也少了很多拿假数据骗经费的空间。
你要是还在愁课题组的软件经费不够,不妨去搜搜你做的方向,说不定就能挖到宝。说不定下一个突破,就藏在那堆免费的开源代码里。
开源技术已经完成了科研全流程的渗透
现在的开源工具早就不是商用软件的免费替代品,很多领域已经成了行业默认的标配。 说实话,放在十几年前,哪敢想普通课题组能自己做全基因组分析?那时候商业公司把工具捂得严严实实,做一次分析收几十万,相当于一个青年教师一年的工资。现在呢?从序列比对到差异分析,从结构预测到功能富集,全链路全开源,一个刚进组的研一学生,跟着网上的教程走一周就能跑通自己的数据。生物信息学开源测序分析工作流界面
不止生信,化学、材料、机械各个领域全覆盖。做分子动力学模拟,开源的GROMACS性能比大半商用软件都能打,课题组只要有几台带GPU的工作站就能跑,不用求爷爷告奶奶批百万级的软件经费。做材料相变模拟,原来收费的VASP alternatives里,开源的PWmat社区版精度不差,还能自己改参数加适配功能,这不香吗?
就连做人文社科的,现在都在用开源的文本分析工具,处理上亿字的古籍文献,原来要买几十万的商用数据库,现在开源的BERT预训练模型调一调,准确率比商用工具还高,还能自己针对特定领域训练,自由度拉满。
开源技术应用路上的隐形坑,大多数人都踩过
不过话说回来,开源不是免费的午餐,坑真的不少。我前两年帮一个机械系的课题组做数字化仿真,他们听了线上讲座说开源的FENiX做有限元分析好,直接拉了代码就往上堆,结果跑了半个月,结果和实际实验差了快15%,一群人蹲在服务器房挠头,差点把项目延期。 什么原因?说出来你可能不信,他们下的那个开发分支,是专门给二维平面问题做优化的,他们拿来算三维的汽车冲压成型,能对才怪。社区维护的开源项目,分支多、适配杂,没人给你拍胸脯保证兼容性,这就是最大的隐形坑。开源有限元仿真计算结果误差对比图
还有更坑的。很多做医学影像的年轻学生,直接拿Github上开源的预训练大模型权重就用,结果到了自己的临床数据上,准确率掉了快20个点,差点毕不了业。为什么?人家的模型是用欧美人群的肺癌数据训练的,你拿来算国内人群的鼻咽癌,能准才有鬼。
很多人对开源有误区,觉得拉了代码就能用,出了问题就是开源不好。说实话,大多数问题都是自己没做适配。开源给你的是工具和自由度,不是给你打包好的外卖,你总得自己调调味吧?
坑多归坑,只要你踩过一次记住了,后面得到的好处远远比坑多。省下的软件经费能多招两个学生,能多做三次实验,还能随便改代码适配自己的项目,不比每年给厂商交保护费强?
开源正在重新拉平科研的入门门槛
开源正在重新拉平科研的入门门槛
我上个月去开国内科研软件的行业会,碰到一个来自西部普通二本的老师,他说原来他们学校全年的软件采购经费才不到二十万,根本买不起前沿研究需要的工具,想做项目只能挑别人剩下来的方向。现在全转成开源技术,不到三年已经发了四篇不错的SCI,还拿到了省里的青年基金,放在十年前想都不敢想。
这就是开源技术应用最厉害的地方,它不是帮顶级实验室省点钱,是把原来攥在少数机构手里的工具,放到了所有科研人员的面前。地方院校的普通学生,双非高校的年轻老师,都能用上和清北北欧美顶校一样的研究工具,不用因为买不起软件就做不了前沿研究。
现在国内很多高校和科技企业都开始搭自己的开源科研软件社区,不再全依赖国外Github,更新更快,出了问题还有国内的开发者能问,解决了原来卡网、没人答疑的老问题。很多顶刊现在也要求作者把研究用到的代码和工具开源,重复实验变得更容易,也少了很多拿假数据骗经费的空间。
你要是还在愁课题组的软件经费不够,不妨去搜搜你做的方向,说不定就能挖到宝。说不定下一个突破,就藏在那堆免费的开源代码里。