可靠性工程技术:藏在行业后台没人说的隐形护城河
上个月跟某自动驾驶厂做测试的老陈喝酒,他拍着桌子骂,说之前上线的感知模型,实验室跑分拉满,路测一碰到暴雨天都瞎,三个月项目差点黄了。问他问题出在哪,说白了,就是把可靠性工程技术当成了上线前走流程的测试,根本没当核心事做。对吧?
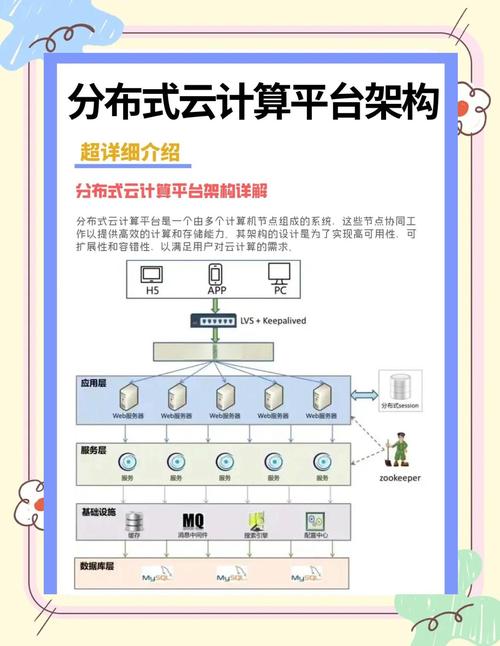 云计算多可用区可靠性架构部署图
早在上世纪60年代阿波罗登月项目,NASA的工程师就把可靠性量化玩到极致了,每个元器件的失效率都算到小数点后六位,就是怕天上出一点岔子。那时候哪有什么自动化测试工具,全靠可靠性工程一点点抠细节。
放到现在也是一样。很多创业公司天天抢进度拼功能,把可靠性当成后勤打杂的活,出事了就拍大腿喊“怎么偏偏这个时候坏了”。哪有什么偏偏,都是从一开始就没算到的隐患。
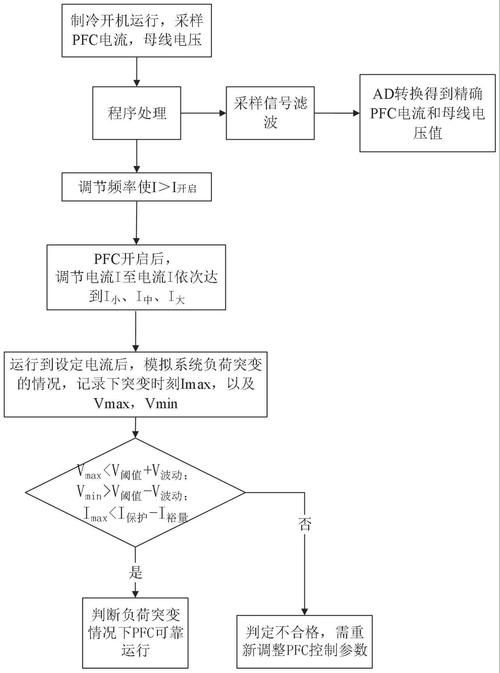 大模型可靠性测试幻觉排查流程图
之前有个做医疗大模型的创业团队找我聊,说他们模型准确率做到95%,本来信心满满要进医院试点,结果被卫健委直接卡了,要求必须拿出99.99%的诊断可靠性证明,才允许落地。这才急着到处挖做可靠性的人,开的薪资比同级别算法工程师高20%都招不到。说白了,早干嘛去了?
 想蹭这个风口,根本不需要你啃完半人高的教材
不过话说回来,现在这个方向的缺口真的太大了。我前两个月翻招聘平台的数据,可靠性工程师的平均薪资,比同级别后端开发高15%到20%,好多岗位放出来三个月都招不到合适的人。
为啥?因为这个方向要求杂,你既要懂统计概率,还要懂系统架构,还要懂具体业务的风险点,不是培训班三个月就能训出来的。但也没传说中那么难进,别上来就啃几十年前的老教材,全是枯燥的公式,看两页你就睡着了。
要是你做后台开发,就从混沌工程切入,现在开源的混沌工具一大堆,你自己搭个微服务集群,没事炸着玩,几次下来你就懂什么叫容灾降级,什么叫熔断限流了,摸清楚规律再补理论,比反过来顺多了。
要是你做AI算法,就从大模型的可靠性评估切入,现在这块有一堆公开的基准数据集,你做两个幻觉排查、对抗稳定性的项目放到GitHub,根本不愁面试官找你。
甚至产品经理都能蹭。你做产品的时候,就把可靠性指标提前算进需求里,比那些只会画原型改交互的产品,值钱一万倍。我认识一个原来做电商的产品经理,去年转岗做大模型产品的可靠性需求,年薪直接翻了一倍,爽得不行。
可靠性就是这么个玩意,做好了没人会天天夸你,用户只会觉得“这个产品用着真稳”,但只要出一次错,之前攒的所有好感全没了。你看那些能活十年以上的长命产品,哪个不是把可靠性刻进骨头里的?...
别拿找bug当可靠性,可靠性工程技术根本不是测试
很多人一听到可靠性,第一反应就是上线前测bug改bug。错了。 说实话,现在不管是云计算、自动驾驶还是大模型,产品复杂度翻了十几倍都不止,原来那种“堆功能测一遍就上线”的思路,早就死透了。可靠性工程技术是从产品需求阶段就嵌进去的,算的是你整个生命周期里,各个模块出问题的时候,整个系统还能不能正常给用户提供服务。 你以为云计算的多可用区部署,就是多放几台机器那么简单?那是可靠性工程一点点算出来的:同时挂几个可用区不影响核心业务?灾难恢复要把服务恢复时间压到几秒?核心数据的损坏率要控制在多少以内?全是量化出来的结果,不是靠堆硬件堆出来的。云计算多可用区可靠性架构部署图
早在上世纪60年代阿波罗登月项目,NASA的工程师就把可靠性量化玩到极致了,每个元器件的失效率都算到小数点后六位,就是怕天上出一点岔子。那时候哪有什么自动化测试工具,全靠可靠性工程一点点抠细节。
放到现在也是一样。很多创业公司天天抢进度拼功能,把可靠性当成后勤打杂的活,出事了就拍大腿喊“怎么偏偏这个时候坏了”。哪有什么偏偏,都是从一开始就没算到的隐患。
这两年可靠性工程技术爆火,全是行业逼出来的
别觉得这是学术界炒出来的冷饭,现在可靠性工程突然成了大厂抢着要的方向,全是实际业务逼出来的。我给你说两个最火的方向,你就懂了。 第一个就是混沌工程,本质就是可靠性工程的实战分支。现在云原生时代,微服务拆得七零八落,一个小服务挂了会不会引发整个系统雪崩?你等出事了再救火,损失早就造成了,不如主动炸机房练手。最早是Netflix玩起来的,人家每周故意断掉一部分服务器,就是验证系统的容错能力,现在国内头部云厂商都有自己的混沌工程平台,阿里之前公开过数据,他们通过混沌工程提前发现的可靠性隐患,比线上实际爆出来的多三倍。 第二个就是大模型可靠性工程,这两年太火了,缺口大到抢人。现在大模型天天吹参数多大效果多好,一落地就露馅:动不动生成幻觉,自动驾驶错识别一个路标就是人命,金融大模型算错一个收益率就是百万级损失。现在不管是OpenAI还是国内的大厂,都专门开了独立的可靠性团队,做什么对抗测试、输出溯源、事实验证,全是围绕大模型的可靠性新搞出来的玩法。大模型可靠性测试幻觉排查流程图
之前有个做医疗大模型的创业团队找我聊,说他们模型准确率做到95%,本来信心满满要进医院试点,结果被卫健委直接卡了,要求必须拿出99.99%的诊断可靠性证明,才允许落地。这才急着到处挖做可靠性的人,开的薪资比同级别算法工程师高20%都招不到。说白了,早干嘛去了?
想蹭这个风口,根本不需要你啃完半人高的教材
想蹭这个风口,根本不需要你啃完半人高的教材
不过话说回来,现在这个方向的缺口真的太大了。我前两个月翻招聘平台的数据,可靠性工程师的平均薪资,比同级别后端开发高15%到20%,好多岗位放出来三个月都招不到合适的人。
为啥?因为这个方向要求杂,你既要懂统计概率,还要懂系统架构,还要懂具体业务的风险点,不是培训班三个月就能训出来的。但也没传说中那么难进,别上来就啃几十年前的老教材,全是枯燥的公式,看两页你就睡着了。
要是你做后台开发,就从混沌工程切入,现在开源的混沌工具一大堆,你自己搭个微服务集群,没事炸着玩,几次下来你就懂什么叫容灾降级,什么叫熔断限流了,摸清楚规律再补理论,比反过来顺多了。
要是你做AI算法,就从大模型的可靠性评估切入,现在这块有一堆公开的基准数据集,你做两个幻觉排查、对抗稳定性的项目放到GitHub,根本不愁面试官找你。
甚至产品经理都能蹭。你做产品的时候,就把可靠性指标提前算进需求里,比那些只会画原型改交互的产品,值钱一万倍。我认识一个原来做电商的产品经理,去年转岗做大模型产品的可靠性需求,年薪直接翻了一倍,爽得不行。
可靠性就是这么个玩意,做好了没人会天天夸你,用户只会觉得“这个产品用着真稳”,但只要出一次错,之前攒的所有好感全没了。你看那些能活十年以上的长命产品,哪个不是把可靠性刻进骨头里的?...