智能运维管理:从被动救火到主动预判的产业变革
前两周跟某头部互联网公司运维部的老陈喝酒,他说十年前刚入行的时候,手机必须调最大音量放枕头边,深怕半夜漏了告警电话。大年三十陪老婆回娘家,半路上接到机房告警,掉头开三个小时回公司换硬盘是常有的事。
现在呢?上周他休了一周年假带孩子去青海玩,连个工作群@都没收到。
变化在哪?四个字,智能运维。
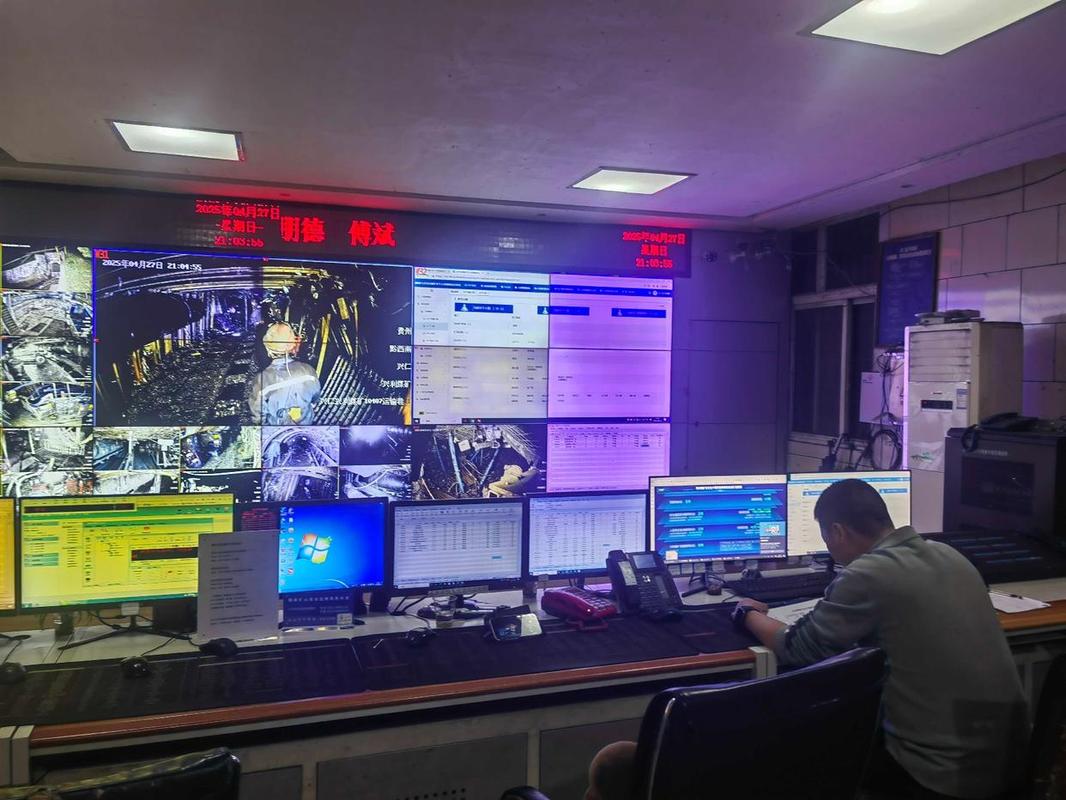 传统数据中心运维人员夜间值班排查图
 工业智能运维管理平台故障预测界面图
曾经的运维,是全靠人力堆出来的高危岗位
早些年不管是互联网企业的数据中心,还是制造业的生产车间,运维基本都是「出问题→救火→排查→复盘」的循环。全靠老师傅的经验背锅,设备出了故障,全部门熬夜排查,有时候找根因就要找一两天,业务停摆的损失,早就把人力成本盖过去了。 我听过最夸张的例子,某银行早年核心系统出了连接超时的问题,十几个运维加研发熬了48小时,最后发现只是某台交换机的网线松了。 换做现在呢?这种级别的异常,十分钟就能定位。传统数据中心运维人员夜间值班排查图
真正落地的智能运维管理,核心是提前预判问题而非事后救火
很多人对智能运维的理解还停留在「自动发告警」,这其实只是最基础的功能。现在成熟的智能运维管理体系,核心是基于全链路的时序数据,用机器学习模型提前捕捉异常的前兆——比如硬盘读写延迟慢慢升高,这就是坏道的前兆,系统提前一周就会推预警,运维趁着业务低峰直接换掉就行,根本不会出故障。 还有根因自动分析这个功能,原来分布式系统出问题,几十个服务互相调用,谁也说不清是哪块出问题,现在智能系统能自动梳理调用链,直接把根因模块标出来,准确率能到90%以上。 去年某运营商南方分公司落地智能运维之后,基站故障的平均修复时间从原来的120分钟降到了18分钟,预测性维护覆盖率超过70%,每年省下来的抢修成本超过两个亿。 这不是吹,是公开的行业案例。工业智能运维管理平台故障预测界面图