容错计算技术:你天天用却不知道的「数字安全网」
你有没有过刷视频刷到一半,手机突然卡顿重启,转头就自动续上了播放进度,连缓存都没丢?
有没有试过在地铁里转大金额的账,信号突然跳成空框,等一秒信号回来,转账已经成功完成?
这些你习以为常的「小幸运」,根本不是运气好。
全是容错计算技术在背后兜着底。
 阿波罗导航计算机三重容错计算设计图
现在从你口袋里手机的7nm芯片,到云上扛着十亿人访问的算力集群,再到万米高空飞机的飞控系统,全靠容错计算撑着底线。哪怕有一两个晶体管出错,有一个节点宕机,整个系统照样转,不会崩。
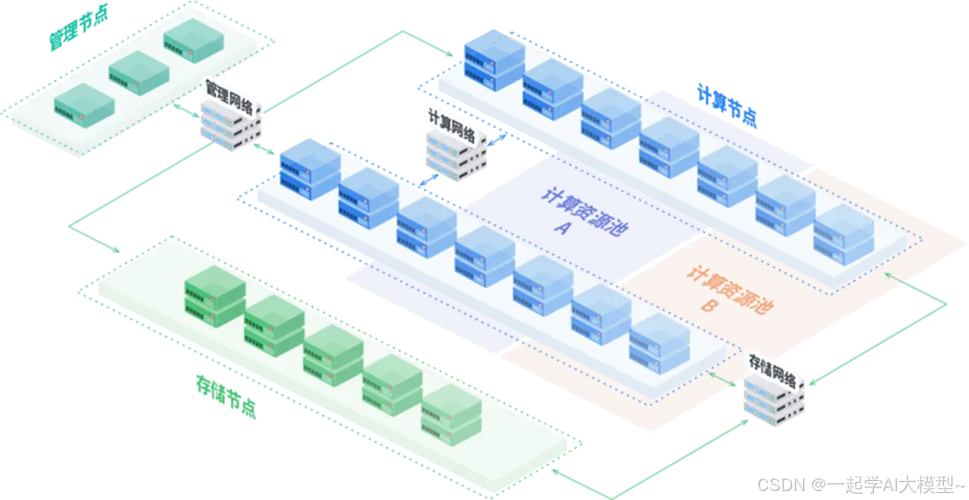 大模型GPU训练集群容错计算调度示意图
不止AI。
现在L2级以上的自动驾驶,哪款车没做容错冗余?方向盘的控制信号,同时走两条线路,两个核心控制器同时算,一个出问题另一个一秒就能接过来,根本不会让你握着方向盘发现没反应——那可是要出人命的事。
不过话说回来,很多人对容错计算的印象还停留在「堆硬件备份」,那都是十年前的老思路了。现在新的容错计算技术早就进化了,有算法层面的动态容错,还有AI辅助的错源定位,哪里出问题自动绕开,动态调度空闲算力顶上,硬件成本比原来全系统冗余降了一半还多,稳定性还更高。
 容错计算技术接下来,藏着很多人没注意到的机会
现在国内芯片行业往先进工艺走,容错计算其实帮了大忙。
怎么说?一块大芯片做出来,工艺越先进,越容易出现个别小单元损坏的情况,放以前,整颗芯片直接当残次品扔了,良率上不去,成本就下不来。现在用容错计算技术,直接把坏的单元屏蔽掉,自动调度好的单元顶替,原来的残次品直接变成合格产品,良率一下能提十几个点,成本降了,消费者就能买到更便宜的芯片,这是实打实的好处。
还有现在风口上的量子计算。现在大家做的都是含噪声的中尺度量子计算,量子比特本身出错率就极高,要做能用的通用量子计算机,核心就是容错量子计算,现在全球顶尖的科研机构都在砸钱堆这个方向,谁先突破实用化的容错量子计算,谁就能拿到下一轮计算革命的门票。
我前阵子去参加一个算力行业的小会,有个老教授讲了一句话,我记到现在。他说现在整个数字世界的地基,其实就是容错计算,所有人都在拼更快更大更强,拼参数拼速度,却忘了最核心的需求其实是「稳」,哪怕出问题,也得有人兜住底。
太对了。
很多搞技术创业的,上来就吹我参数多大我速度多快,上线了动不动就崩,转个账出问题,搜个内容出乱码,用户用两次就走了,真的是捡了芝麻丢了西瓜。
你看,我们享受了这么多年数字世界的便利,从来没怎么注意过这个默默托底的技术。它不抛头露面,不怎么上热搜,却撑着整个数字世界不翻车。
下次你手机出点小问题自己就好了,记得哦,那就是容错计算技术,又帮你兜了一次底。
什么是容错计算?不是「出错了改」,是「出错了照样转」
很多人第一次听这个词,会把它和纠错搞混。 纠错是什么?是文件下坏了,校验一下重新下坏的区块;是代码出bug了,程序员改完重新发版。 容错不一样。 容错从一开始就默认:「出错是必然的,哪有从来不坏的零件?」它不需要停下来等你改,直接把错误的影响掐死在摇篮里,该干嘛干嘛,你作为用户根本感觉不出来。 早在上世纪阿波罗登月的时候,这门技术就已经用上了。当时导航计算机用了三重冗余设计,三个模块同时算同一个结果,随便一个被宇宙射线打错出了偏差,另外两个直接投票把错误结果否决,全程不耽误登月导航。 说实话,那时候谁能想到,半个世纪后,这门原本给航天尖端项目准备的技术,会铺到全世界每个普通人的日常里。阿波罗导航计算机三重容错计算设计图
现在从你口袋里手机的7nm芯片,到云上扛着十亿人访问的算力集群,再到万米高空飞机的飞控系统,全靠容错计算撑着底线。哪怕有一两个晶体管出错,有一个节点宕机,整个系统照样转,不会崩。
AI爆火的当下,容错计算为什么突然成了行业刚需?
前几年这技术还偏冷门,这两年突然火了,为什么? 还不是大模型带的。 现在大模型训练,一次就要动用上万张GPU卡,跑好几个月。原来的旧机制:只要一个卡出个小错,整个训练任务全部重启,几个小时甚至几天的算力就直接打水漂了,一张A100一小时多少钱啊,这浪费的都是真金白银。 更关键的是,先进工艺芯片的软错误率涨得太快了。现在3nm工艺下,工作电压比28nm降了一大半,宇宙射线打一下,或者电压稍微抖一下,就会出现一个比特翻转,也就是数据错了。要是没有容错机制,现在的大模型跑起来,错的结果能把人搞疯。 去年我跟一个在头部AI公司做算力调度的朋友聊天,他说他们现在给GPT类大模型做推理集群,光容错优化就投了一个二十多人的团队做了大半年。原来出错重跑一次要几分钟,现在容错计算切流只要几十毫秒,用户根本感觉不到任何异常。 s大模型GPU训练集群容错计算调度示意图
不止AI。
现在L2级以上的自动驾驶,哪款车没做容错冗余?方向盘的控制信号,同时走两条线路,两个核心控制器同时算,一个出问题另一个一秒就能接过来,根本不会让你握着方向盘发现没反应——那可是要出人命的事。
不过话说回来,很多人对容错计算的印象还停留在「堆硬件备份」,那都是十年前的老思路了。现在新的容错计算技术早就进化了,有算法层面的动态容错,还有AI辅助的错源定位,哪里出问题自动绕开,动态调度空闲算力顶上,硬件成本比原来全系统冗余降了一半还多,稳定性还更高。
容错计算技术接下来,藏着很多人没注意到的机会
容错计算技术接下来,藏着很多人没注意到的机会
现在国内芯片行业往先进工艺走,容错计算其实帮了大忙。
怎么说?一块大芯片做出来,工艺越先进,越容易出现个别小单元损坏的情况,放以前,整颗芯片直接当残次品扔了,良率上不去,成本就下不来。现在用容错计算技术,直接把坏的单元屏蔽掉,自动调度好的单元顶替,原来的残次品直接变成合格产品,良率一下能提十几个点,成本降了,消费者就能买到更便宜的芯片,这是实打实的好处。
还有现在风口上的量子计算。现在大家做的都是含噪声的中尺度量子计算,量子比特本身出错率就极高,要做能用的通用量子计算机,核心就是容错量子计算,现在全球顶尖的科研机构都在砸钱堆这个方向,谁先突破实用化的容错量子计算,谁就能拿到下一轮计算革命的门票。
我前阵子去参加一个算力行业的小会,有个老教授讲了一句话,我记到现在。他说现在整个数字世界的地基,其实就是容错计算,所有人都在拼更快更大更强,拼参数拼速度,却忘了最核心的需求其实是「稳」,哪怕出问题,也得有人兜住底。
太对了。
很多搞技术创业的,上来就吹我参数多大我速度多快,上线了动不动就崩,转个账出问题,搜个内容出乱码,用户用两次就走了,真的是捡了芝麻丢了西瓜。
你看,我们享受了这么多年数字世界的便利,从来没怎么注意过这个默默托底的技术。它不抛头露面,不怎么上热搜,却撑着整个数字世界不翻车。
下次你手机出点小问题自己就好了,记得哦,那就是容错计算技术,又帮你兜了一次底。