联邦学习技术:不用共享原始数据,也能训出好用AI
为什么说联邦学习是被逼出来的技术?
很早之前,AI圈就有数据孤岛的说法。医院想训AI预测癌症,单一家医院的样本量不够,想要跟其他医院合作,病历数据根本带不出来。银行想做反欺诈模型,一家银行的欺诈样本太少,跨银行共享用户数据,直接违反个人信息保护法。
之前也有人想过各种办法,比如说把数据脱敏之后再共享。说实话脱敏根本没用。多少研究已经证明,只要把几个公开维度的数据一交叉,就算你去掉了名字身份证号,也能精准定位到具体某个人。
2016年谷歌最先把联邦学习这个概念推出来,最开始就是给安卓手机输入法做个性化预测。思路说穿了其实很简单:不要把数据拿到模型这边来,把模型送到数据那边去。
大概逻辑就是,大家先一起初始化一个共同的模型,每个机构都用自己本地的数据训一轮模型,只把模型更新的参数传出来,汇总之后再更新大家的共同模型,循环往复直到模型收敛。从头到尾,原始数据一点都不会离开本地,完美解决隐私问题。
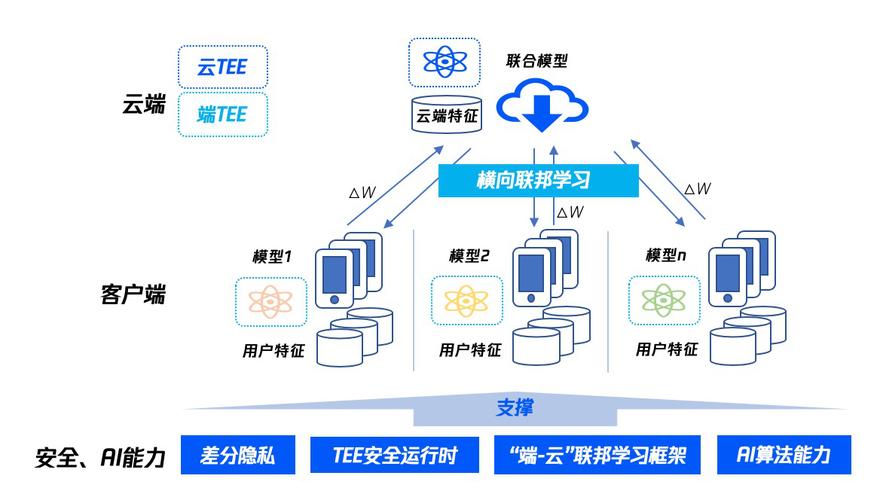 横向联邦学习系统架构图
别信神话,联邦学习的坑其实不少
现在很多厂商吹联邦学习,说它是绝对安全的隐私计算方案。我只能说,听听就好,别全信。
行业里这些年做攻防的团队,早就挖出了不少安全漏洞。最常见的就是梯度反演攻击——你不是只传梯度参数不上传原始数据吗?攻击者就能通过你传出来的梯度,反向还原出你用的原始训练数据。之前我看过一个研究,就连训练用的人脸图片,都能还原个七八分,吓人吧。
联邦学习本身也分好几种,最常见的就是横向和纵向。横向联邦适合用户重叠度低、特征重叠度高的场景,比如两家不同省份的城商行,业务都是存贷,特征都是收入负债这些,用户基本不重叠。纵向联邦刚好反过来,适合用户重叠度高、特征互补的场景,比如同个城市的银行和电商,大部分用户都是同一拨人,银行有还款记录,电商有购买记录,拼起来就能训更好的信用评估模型。
现在为了补安全的窟窿,大家也想了很多办法,比如说差分隐私加噪声,同态加密,安全多方计算这些。不过话说回来,任何安全加固都是有代价的。加了加密之后,不仅训练速度会变慢,模型精度多多少少都会掉,整体的部署成本还会涨一大截。很多创业公司吹自己的联邦学习零成本精度无损失,那基本就是割投资人韭菜的,对吧?
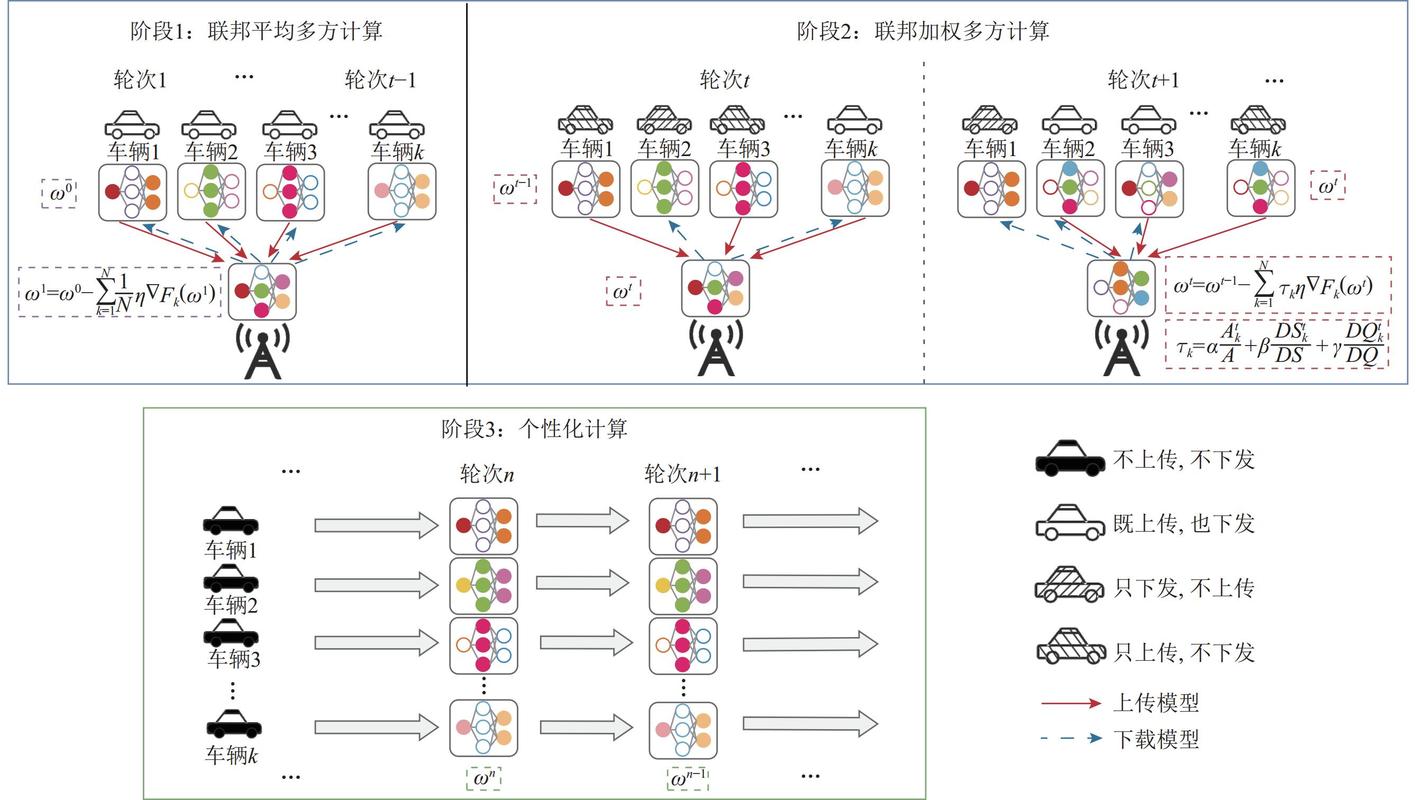 联邦学习梯度反演攻击还原效果图
联邦学习真的落地了吗?现在都用在哪了?
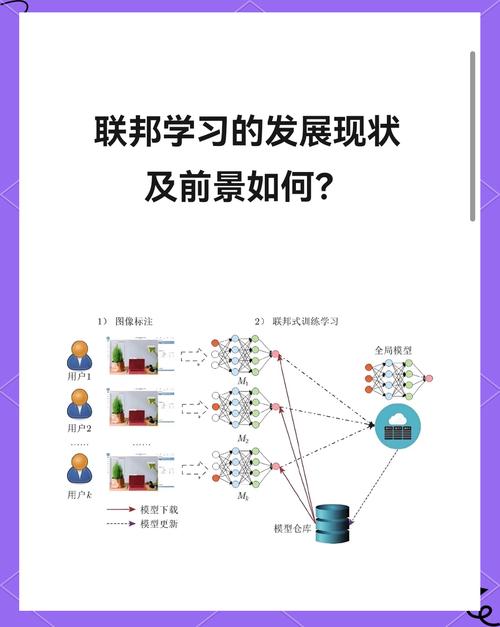 联邦学习真的落地了吗?现在都用在哪了?
很多人说联邦学习都是学术界骗经费的花架子,根本落不了地。这个说法真的有点偏见。现在不少行业都已经有实打实的落地项目了。
金融行业应该是落地最多的。不少银行现在联合做反欺诈、做信用评分,都在用联邦学习。每家银行的数据都不出域,联合训出来的模型,效果比单家自己训的好太多,监管也挑不出毛病,完全合规。去年我看到国内一家股份制银行的公开数据,用联邦学习联合多家城商行训的反欺诈模型,欺诈识别率提升了快20%,比原来的方案好太多。
医疗领域的落地也越来越多。之前顶刊发过一篇研究,五家不同的医院用联邦学习训肺癌预测模型,效果跟把所有数据集中起来训的模型几乎差不多,精度只差不到1%,但完全不用共享任何患者原始数据,这个意义真的很大。尤其是罕见病,单一家医院根本攒不到足够的样本,多机构联合用联邦学习,刚好解决这个问题。
最近大模型爆火,联邦学习又迎来了一波新的热度。现在很多行业都想做自己的行业大模型,但是自己手里的数据不够,又不想把数据交给第三方训,大模型联邦学习就成了非常热门的选项。今年上半年查相关论文,数量比去年同期翻了一倍还多,不少大厂都在偷偷搞。
其实你每天都可能在用联邦学习,只是你不知道而已。现在不少手机的端侧AI,比如输入法预测、智能语音助手的个性化模型,用的就是端侧联邦学习,你的输入数据、语音记录根本不会全传到云端,只在本地更新,只传模型参数,既保护了隐私,又能让模型越来越懂你。
当然,现在联邦学习还远没到完美的程度。跨机构节点不稳定、网络延迟高、对齐数据的成本高这些问题都还存在。但需求摆在那里,隐私监管只会越来越严,跨机构AI合作的需求只会越来越多,这个技术的发展空间,真的比很多人想的要大得多。说不定再过三五年,只要是跨机构合作的AI项目,都会默认用上联邦学习。