知识图谱构建:从论文到落地的那些踩坑经验
上周跟大厂做NLP的老兄弟喝酒,他拍着桌子吐槽,现在网上九成讲知识图谱构建的文章,全是飘在天上的。开口就是算法模型,闭口就是准确率,真拿到实际项目里,一步一个坑,根本没人说破。
很多新手上来就问,我用什么大模型做构建准确率最高?我都笑。你数据源都没整明白,吹什么准确率。
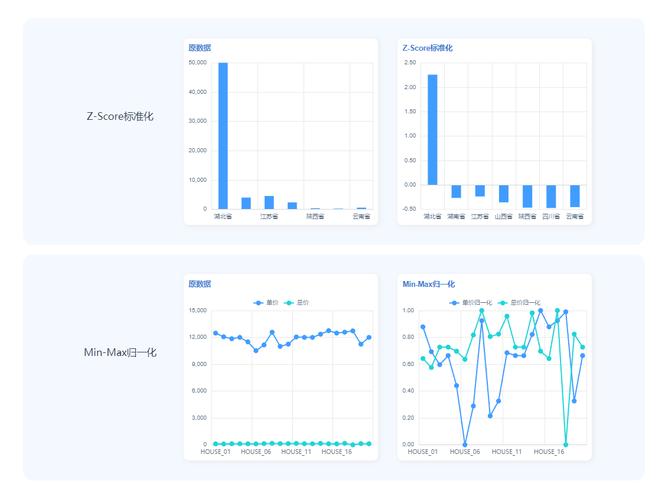 知识图谱构建原始数据清洗对比图
说实话,实体对齐才是大部分中小项目的第一道鬼门关,比什么关系抽取难一百倍。算法模型能帮你做粗对齐,但是遇到简称、别名、错字、同译名,最后还是得靠领域规则加人工校验。
之前有家创业公司找我做咨询,他们招了三个算法,花三个月做关系抽取,实验室准确率做到94%,上线跑了一周,整个图谱一半节点是重复的,连公司创始人的名字都分出三个节点。你说可笑不可笑?
现在很多人吹大模型端到端构建知识图谱,说不用人工不用流程,输入数据直接出图谱。我就问一句,大模型的幻觉你治吗?遇到“小米”到底是手机公司还是五谷杂粮,它能每次都分对吗?没有规则兜底,错得离谱你都不知道。
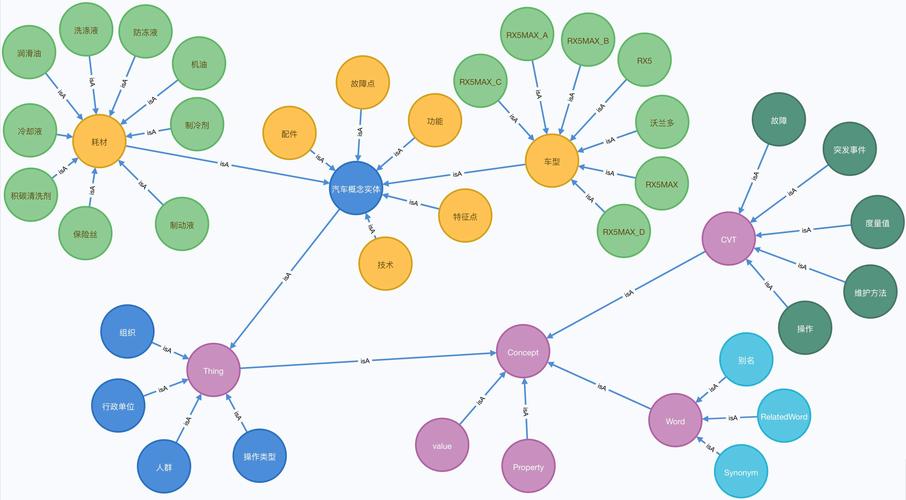 知识图谱构建弹性schema设计示例图
我之前接了一个地方文旅的项目,甲方非要把所有文旅资源拆得细之又细,光“古建筑”就分了宋代建筑、明代建筑、清代建筑、民国建筑八个子类,每个子类的关系都不一样。我们拗不过甲方,按要求做了,结果半年后甲方新出了“近现代革命历史建筑”的分类,原来的结构全部要动大手术,我们团队四个人加班加了整整一个月,一分额外的钱都没拿到,累得差点脱层皮。
不过话说回来,核心规则不能松。实体唯一ID从第一天就要定死,这个错了,后面全是灾难。很多新手不在意这个,觉得先做了后面再合并,等你图谱有了十万级别的节点,再去合并重复实体,那个工程量,能让你怀疑人生。
我现在做项目的习惯是,一开始schema只定核心的十几类实体,最核心的二三十种关系,剩下的全留扩展位。知识图谱本来就是跟着业务慢慢长出来的,哪有一开始就长完美的?
 大模型时代,知识图谱构建的新玩法
这两年大模型火了之后,知识图谱构建确实变快了很多,这点是真的。
放在五年前,构建一个百万级节点的领域知识图谱,从数据收集到上线,最少要一年半载,标注成本就能砸进去几十万。现在呢?用大模型做半自动抽取,原来标注员三个月的活,大模型两三天就能出初版,人工只需要校验错误的部分,速度能提十倍,成本能砍三分之二。
我上个月见一个做ToB的团队,给律所做判例知识图谱,原来六个标注员做三个月的活,现在用大模型初抽,两个律师审错,两个礼拜就上线跑核心场景了,效率提升不是一点半点。
但是别迷信大模型能包打天下。现在行业里靠谱的玩法,全是大模型+规则+人工校验的混合模式,全自动化构建高质量知识图谱,现在还是不可能的事。大模型会编关系啊,比如你抽A公司和B公司的持股关系,大模型看两篇新闻同时提到了两家,直接给你编出一个持股关系,你不审核,整个图谱全是垃圾,用的时候还会把错误信息传给大模型,错上加错。
现在还有一个很火的玩法,叫“按需构建,动态迭代”,不用一开始就做全量图谱,你做搜索就先把搜索需要的核心实体关系做了,做推荐就先做商品和标签的关系,边用边补,边用边改。这个对中小团队太友好了,不用一开始就砸几百万进去,先跑通小场景,赚到钱了再慢慢扩展。
我见过太多团队,上来就喊着要做全行业通用知识图谱,砸了几千万进去,最后数据烂在存储里,连个能用的场景都跑不出来,钱烧完了公司也就没了。反而是那些盯着小场景的,做餐饮供应链的知识图谱,做医美医生资质的知识图谱,活下来了,还活得挺舒服。
知识图谱构建从来就不是什么高大上的玄学,本质就是把你领域里的信息,整理成机器能读懂的关系网。技术一直在变,核心逻辑没变,你把数据理清楚,把骨架搭对,慢慢长就是了。踩过两个坑,你就懂了。
别上来就堆算法,先把脏数据理明白
知识图谱构建的第一步,永远是处理数据,不是调模型。 我见过太多团队,拿到一堆杂七杂八的数据源,连格式都没统一,就急急忙忙上抽取模型,结果出来的东西根本没法用。比如做消费领域的知识图谱,爬来的电商商品标题,一会叫“苹果14”一会叫“iPhone14苹果”,同一个实体变出五六个身份,最后图谱里全是冗余节点,查询一次错三次。知识图谱构建原始数据清洗对比图
说实话,实体对齐才是大部分中小项目的第一道鬼门关,比什么关系抽取难一百倍。算法模型能帮你做粗对齐,但是遇到简称、别名、错字、同译名,最后还是得靠领域规则加人工校验。
之前有家创业公司找我做咨询,他们招了三个算法,花三个月做关系抽取,实验室准确率做到94%,上线跑了一周,整个图谱一半节点是重复的,连公司创始人的名字都分出三个节点。你说可笑不可笑?
现在很多人吹大模型端到端构建知识图谱,说不用人工不用流程,输入数据直接出图谱。我就问一句,大模型的幻觉你治吗?遇到“小米”到底是手机公司还是五谷杂粮,它能每次都分对吗?没有规则兜底,错得离谱你都不知道。
schema设计别搞完美主义,留足弹性空间
schema是什么?说白了就是知识图谱的骨架,你要定义有哪几类实体,实体之间有哪几类关系。 很多做学术出身的朋友,做schema的时候就跟做论文一样,追求绝对严谨,实体分七八十类,关系分上百种,每个属性都定死约束,拿出来看,漂亮得不得了,用起来才知道,动都动不了。知识图谱构建弹性schema设计示例图
我之前接了一个地方文旅的项目,甲方非要把所有文旅资源拆得细之又细,光“古建筑”就分了宋代建筑、明代建筑、清代建筑、民国建筑八个子类,每个子类的关系都不一样。我们拗不过甲方,按要求做了,结果半年后甲方新出了“近现代革命历史建筑”的分类,原来的结构全部要动大手术,我们团队四个人加班加了整整一个月,一分额外的钱都没拿到,累得差点脱层皮。
不过话说回来,核心规则不能松。实体唯一ID从第一天就要定死,这个错了,后面全是灾难。很多新手不在意这个,觉得先做了后面再合并,等你图谱有了十万级别的节点,再去合并重复实体,那个工程量,能让你怀疑人生。
我现在做项目的习惯是,一开始schema只定核心的十几类实体,最核心的二三十种关系,剩下的全留扩展位。知识图谱本来就是跟着业务慢慢长出来的,哪有一开始就长完美的?
大模型时代,知识图谱构建的新玩法
大模型时代,知识图谱构建的新玩法
这两年大模型火了之后,知识图谱构建确实变快了很多,这点是真的。
放在五年前,构建一个百万级节点的领域知识图谱,从数据收集到上线,最少要一年半载,标注成本就能砸进去几十万。现在呢?用大模型做半自动抽取,原来标注员三个月的活,大模型两三天就能出初版,人工只需要校验错误的部分,速度能提十倍,成本能砍三分之二。
我上个月见一个做ToB的团队,给律所做判例知识图谱,原来六个标注员做三个月的活,现在用大模型初抽,两个律师审错,两个礼拜就上线跑核心场景了,效率提升不是一点半点。
但是别迷信大模型能包打天下。现在行业里靠谱的玩法,全是大模型+规则+人工校验的混合模式,全自动化构建高质量知识图谱,现在还是不可能的事。大模型会编关系啊,比如你抽A公司和B公司的持股关系,大模型看两篇新闻同时提到了两家,直接给你编出一个持股关系,你不审核,整个图谱全是垃圾,用的时候还会把错误信息传给大模型,错上加错。
现在还有一个很火的玩法,叫“按需构建,动态迭代”,不用一开始就做全量图谱,你做搜索就先把搜索需要的核心实体关系做了,做推荐就先做商品和标签的关系,边用边补,边用边改。这个对中小团队太友好了,不用一开始就砸几百万进去,先跑通小场景,赚到钱了再慢慢扩展。
我见过太多团队,上来就喊着要做全行业通用知识图谱,砸了几千万进去,最后数据烂在存储里,连个能用的场景都跑不出来,钱烧完了公司也就没了。反而是那些盯着小场景的,做餐饮供应链的知识图谱,做医美医生资质的知识图谱,活下来了,还活得挺舒服。
知识图谱构建从来就不是什么高大上的玄学,本质就是把你领域里的信息,整理成机器能读懂的关系网。技术一直在变,核心逻辑没变,你把数据理清楚,把骨架搭对,慢慢长就是了。踩过两个坑,你就懂了。