语音识别技术:从实验室原型到人人可用的二十年进化
你现在掏出手机,对着听筒说一句“打开付款码”,一秒跳码就能付款。
你有没有想过,仅仅十五年前,这种体验根本就是科幻片里的情节。
一直到九十年代之前,主流的思路都是模板匹配,你得先把每个词录几十遍模板存进去,识别的时候对着比对,匹配上哪个算哪个。别说大词汇量了,就是日常对话,根本不可能做得到。
后来隐马尔可夫模型(HMM)出来,才算是把语音识别拉上了工业化的轨道。从九十年代到2010年这二十年,全世界的语音识别都是HMM的天下。能做到几千个词的识别了,也能支持非特定人说话了,普通人终于能在消费电子上摸到这个技术了。
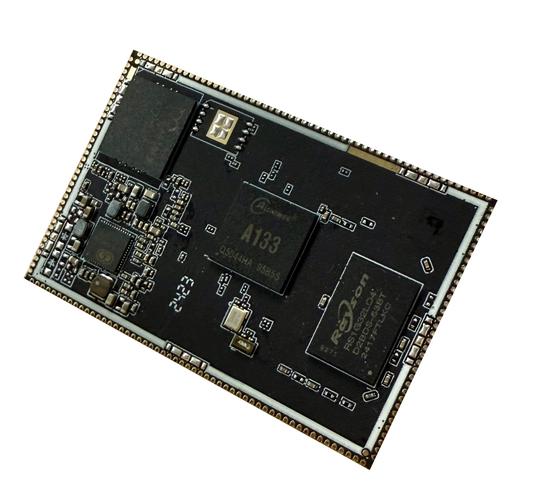 1990年代飞利浦消费级语音识别芯片实拍
但是那效果啊,说出来都是泪。我07年买的某品牌音乐手机,带语音拨号功能,我天天说“打给我妈”,它十次有八次给我拨出去给我爸,环境稍微吵一点,直接给我跳出一堆八竿子打不着的联系人。那时候业内甚至有个悲观的说法:有生之年看不到语音识别能比得上人耳的那天。
说实话,那时候我听行业前辈聊天,好多做了二三十年HMM的老研究员都懵了,说学了一辈子的公式,居然一夜之间就不香了?
往后的发展就是一路狂奔。从DNN到LSTM,再到Transformer,端到端的语音识别模型直接把从前“声学模型-语言模型-解码”三步走的框架给砸烂了,输入语音波形,直接输出文字,中间一步都省了。
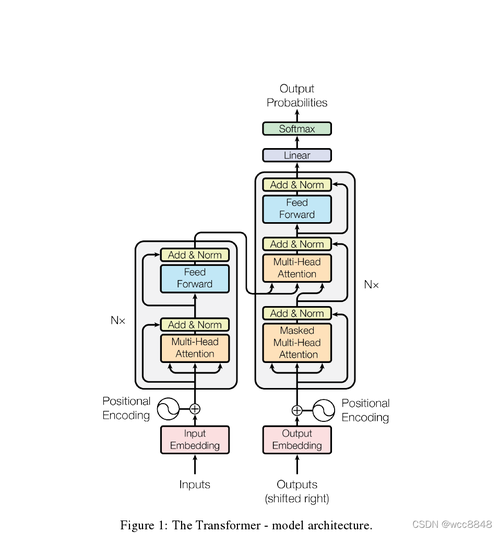 端到端语音识别Transformer网络结构图
现在主流的语音识别模型,通用场景下的错字率已经不到1%,比大多数人打字出错的概率还低。你刷短视频开的自动字幕,开会用的实时记录,外卖小哥接电话用的语音转文字,全靠这波技术革命托着。
别以为语音识别就只是转文字哦。现在的语音识别技术,能顺便给你分出说话人,提取说话的情绪,识别不同的方言,甚至能实时做语音翻译——你说中文,直接出英文字幕,同传会议都能顶半壁江山。上个月我去看国内一家做无障碍设备的创业公司演示,给听障人士做的智能眼镜,就能实时把对面说话的内容转成字幕贴在镜片上,在商场那种人多吵杂的地方,准确率都能到95%以上。放十年前,谁敢想?
 剩下的硬骨头,才是真正的考验
话说回来,现在的语音识别技术也不是完美无缺。
大家都遇到过吧,你说方言口音特别重,或者凑在手机边上说悄悄话,或者一堆人同时抢着说话,它就直接开始乱认了。那个一堆人同时说话,要把某一个人的声音分离出来识别的问题,就是业内说的鸡尾酒会问题,到现在也没有做到百分之百完美解决。更别说那种带鼻音、嗓子哑了的情况,错字率还是会蹭蹭往上涨。
现在行业里啃硬骨头的方向其实很清晰。一个是端侧语音识别,从前语音识别大部分都要把语音传到云端算,现在越来越多的模型能直接跑在手机、耳机的芯片上,不用上传数据,隐私性好了不说,延迟能降到一百毫秒以内,几乎感觉不到等待。另一个方向是多模态融合,就是把语音信息和唇动、人脸表情信息结合起来,去年好几篇顶会论文都验证了,这种方案在极端噪声环境下,错字率能再降15%以上,比纯语音模型靠谱太多。
还有就是低资源语言和方言的识别,国内好多小方言,根本没有那么多标注数据用来训练模型,现在研究院也在搞半监督、无监督训练,就是不用花大量人力标数据,也能训出能用的模型,再过两年,说不定你说任何一个地方的方言,手机都能听得明明白白。
不过我还是要吐个槽,现在不少创业公司把语音识别吹得太神了,说什么能完全代替人工转写,能秒杀同传,其实根本不是那么回事。真到了法庭记录、医疗转写那种要求零错误的场景,还是要人工校对,技术只是提效率,还没到包办一切的地步。
你今天发语音消息、刷短视频开自动字幕的时候,不妨多留意一眼。你随手用的功能,藏着好几代研究者六七十年的尝试,错了无数次才走到今天。
挺酷的,不是吗?
你有没有想过,仅仅十五年前,这种体验根本就是科幻片里的情节。
早年的语音识别,根本不是现在这个路子
早在上世纪五十年代,就有研究员搞出了能识别十个数字的语音识别原型。那个玩意儿大得能占半张桌子,还只能认一个人的特定发音,换个人说同一个数字,直接认不出来。一直到九十年代之前,主流的思路都是模板匹配,你得先把每个词录几十遍模板存进去,识别的时候对着比对,匹配上哪个算哪个。别说大词汇量了,就是日常对话,根本不可能做得到。
后来隐马尔可夫模型(HMM)出来,才算是把语音识别拉上了工业化的轨道。从九十年代到2010年这二十年,全世界的语音识别都是HMM的天下。能做到几千个词的识别了,也能支持非特定人说话了,普通人终于能在消费电子上摸到这个技术了。
1990年代飞利浦消费级语音识别芯片实拍
但是那效果啊,说出来都是泪。我07年买的某品牌音乐手机,带语音拨号功能,我天天说“打给我妈”,它十次有八次给我拨出去给我爸,环境稍微吵一点,直接给我跳出一堆八竿子打不着的联系人。那时候业内甚至有个悲观的说法:有生之年看不到语音识别能比得上人耳的那天。
深度学习进场,直接重构了整个赛道
2010年前后,深度学习开始在图像领域出圈,几个敢吃螃蟹的研究员把深度神经网络用到语音识别的声学模型上,一跑结果出来,整个领域都炸了——识别错误率直接比HMM降了30%还多。说实话,那时候我听行业前辈聊天,好多做了二三十年HMM的老研究员都懵了,说学了一辈子的公式,居然一夜之间就不香了?
往后的发展就是一路狂奔。从DNN到LSTM,再到Transformer,端到端的语音识别模型直接把从前“声学模型-语言模型-解码”三步走的框架给砸烂了,输入语音波形,直接输出文字,中间一步都省了。
端到端语音识别Transformer网络结构图
现在主流的语音识别模型,通用场景下的错字率已经不到1%,比大多数人打字出错的概率还低。你刷短视频开的自动字幕,开会用的实时记录,外卖小哥接电话用的语音转文字,全靠这波技术革命托着。
别以为语音识别就只是转文字哦。现在的语音识别技术,能顺便给你分出说话人,提取说话的情绪,识别不同的方言,甚至能实时做语音翻译——你说中文,直接出英文字幕,同传会议都能顶半壁江山。上个月我去看国内一家做无障碍设备的创业公司演示,给听障人士做的智能眼镜,就能实时把对面说话的内容转成字幕贴在镜片上,在商场那种人多吵杂的地方,准确率都能到95%以上。放十年前,谁敢想?
剩下的硬骨头,才是真正的考验
剩下的硬骨头,才是真正的考验
话说回来,现在的语音识别技术也不是完美无缺。大家都遇到过吧,你说方言口音特别重,或者凑在手机边上说悄悄话,或者一堆人同时抢着说话,它就直接开始乱认了。那个一堆人同时说话,要把某一个人的声音分离出来识别的问题,就是业内说的鸡尾酒会问题,到现在也没有做到百分之百完美解决。更别说那种带鼻音、嗓子哑了的情况,错字率还是会蹭蹭往上涨。
现在行业里啃硬骨头的方向其实很清晰。一个是端侧语音识别,从前语音识别大部分都要把语音传到云端算,现在越来越多的模型能直接跑在手机、耳机的芯片上,不用上传数据,隐私性好了不说,延迟能降到一百毫秒以内,几乎感觉不到等待。另一个方向是多模态融合,就是把语音信息和唇动、人脸表情信息结合起来,去年好几篇顶会论文都验证了,这种方案在极端噪声环境下,错字率能再降15%以上,比纯语音模型靠谱太多。
还有就是低资源语言和方言的识别,国内好多小方言,根本没有那么多标注数据用来训练模型,现在研究院也在搞半监督、无监督训练,就是不用花大量人力标数据,也能训出能用的模型,再过两年,说不定你说任何一个地方的方言,手机都能听得明明白白。
不过我还是要吐个槽,现在不少创业公司把语音识别吹得太神了,说什么能完全代替人工转写,能秒杀同传,其实根本不是那么回事。真到了法庭记录、医疗转写那种要求零错误的场景,还是要人工校对,技术只是提效率,还没到包办一切的地步。
你今天发语音消息、刷短视频开自动字幕的时候,不妨多留意一眼。你随手用的功能,藏着好几代研究者六七十年的尝试,错了无数次才走到今天。
挺酷的,不是吗?