技术风险识别:别等系统崩了才想起补漏洞
绝大多数技术风险,都死在“看不见”这三个字上
很多人对技术风险识别的理解,还停留在上线前扫一遍病毒、测一遍功能。这哪里够啊。 现在的技术栈,牵一发而动全身。你用了一个开源的第三方库,人家藏个后门,你不扫依赖根本发现不了。你把业务迁到公有云,云厂商的SLA写得再漂亮,你自己没做跨可用区容灾,断网一次你就没了。
未知风险才是杀死项目的真凶手。去年某头部社交平台出的大规模泄露事件,追根溯源就是几年前一个离职员工写的一段过时代码,没人记得它存在,自然没人想到它会出问题。
 企业IT架构常见技术风险分布统计图
说实话,现在很多公司的风险防控,就是“防火防盗防已知漏洞”,对于藏在角落的未知风险,全靠撞大运。 AI大模型火了之后,一堆公司抢着把GPT接入内部客服、内部办公系统,连最基本的“prompt注入风险”都没识别出来。之前看到个新闻,某公司的AI客服直接把内部的成本价、未公开的新产品信息,顺着用户的诱导问题全说出去了。老板知道的时候,消息已经在行业圈转遍了。
这种错,犯得冤吗?真不冤。你连风险在哪都不想找,出事不是很正常?
好用的技术风险识别,从来都不是一套写死的流程
我见过太多公司,为了过合规认证,花几十万做了一堆风险识别的流程文档,锁在硬盘里落灰。真到要上线的时候,流程全给进度让路,签字走个形式就过了。 搞这么多花架子,有啥用?
真正有效的技术风险识别,一定是活的,是沉到每个开发、每个产品、每个测试的日常工作里的。我之前跟NASA的工程师聊过他们的故障模式与影响分析(FMEA)方法,核心不是填表格,是把每个模块拆到最小,让每个经手人说清楚:我的这块东西,如果出问题,会影响谁?会出多大事?我有没有留后手? 这个思路,放在互联网行业一样好用。
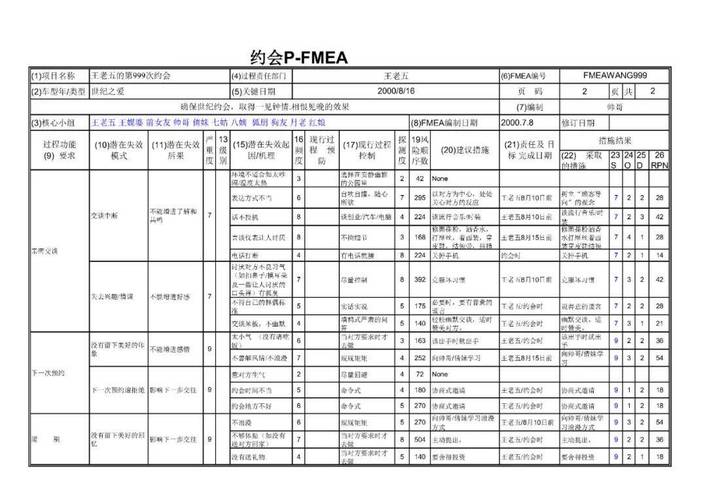 软件开发阶段FMEA技术风险识别表
大模型出来之后,不少人说AI能自动做风险识别,省好多事。这话半对半错。AI能帮你扫已知的漏洞、能帮你梳理依赖,但是它读不懂业务的隐性逻辑。比如你做金融信贷系统,有个规则是“逾期三个月才上征信”,AI能识别出代码漏洞,但是它想不到产品改需求的时候,会不会把判断条件写错,导致提前上征信,引发出合规风险。 这种事,还是得靠人。
不过话说回来,工具确实能提效。我现在给团队做咨询,都会让他们把风险分级:会导致整个服务瘫痪的,是P0风险,上线前必须解决;只会影响边缘功能的,是P2风险,可以后续迭代优化。别一把抓,最后什么都没做好。
普通人怎么建立自己的技术风险识别敏感度
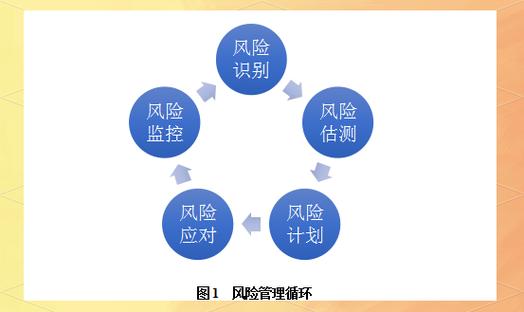 普通人怎么建立自己的技术风险识别敏感度
很多人觉得,技术风险识别是安全专家、架构师的事,我一个初级开发、一个小产品,插不上手。 错。
哪怕你只是写一个最简单的用户登录接口,你都得做风险识别啊。比如,用户输密码的时候,会不会有人暴力破解?你有没有做限流?密码会不会明文存在数据库里?第三方登录回调的时候,会不会被人伪造请求? 这些不都是风险?很多新手就是没想过,上线就出问题。
怎么练出敏感度?其实不难,每次做需求、写代码之前,多问自己三句话: 如果输入是错的,会怎么样? 如果流量突然翻十倍,会怎么样? 如果有人故意搞破坏,会怎么样? 就这三句话,筛掉80%的常见风险,绰绰有余。
我刚工作的时候,我的师父就教我这个,那时候我嫌麻烦,觉得哪那么多坏人,哪那么多极端情况。直到我自己写的一个上传功能,被用户传了一个10G的压缩包,打满了服务器存储,全公司都不能访问内网网站,我熬夜加班扩容,那滋味,我到现在都记得。 懊恼吗?当然。要是我多花十分钟想一步,哪有这事。
现在行业卷,大家都在赶版本,老板都在说“先上线再说”。但是你自己得清楚,出了事,背锅的是你,填坑的还是你。多花半小时做风险识别,比熬夜三天填坑强一万倍。 技术迭代越快,新东西越多,坑就越多。现在大模型、AI Agent,一堆新东西冒出来,很多人抢着上车,连坑在哪都不知道。你多留个心眼,提前把风险找出来,你就比别人少踩很多致命的坑。 跑慢点,没事。别摔个大跟头,再也爬不起来就行。