从论文到落地:开源技术应用正在重构科研底层逻辑
前阵子去内陆一所高校开学术交流会,碰到一个刚出站的年轻博后,蹲在会场门口抽烟吐槽。
他说五年前读博的时候,为了跑一套蛋白结构模拟,攒了大半年经费买商业软件授权,自己搭模型搭了八个月,最后还因为服务器算力不够,出不了稳定结果,延毕了一年。现在呢?拿哈佛实验室开源的大模型改改适配参数,三个月出了三组有效数据,顺利申到了青年基金。
你说神奇不神奇。
开源技术应用早已经不是科研圈的可选项,是拿到牌桌的入场券。
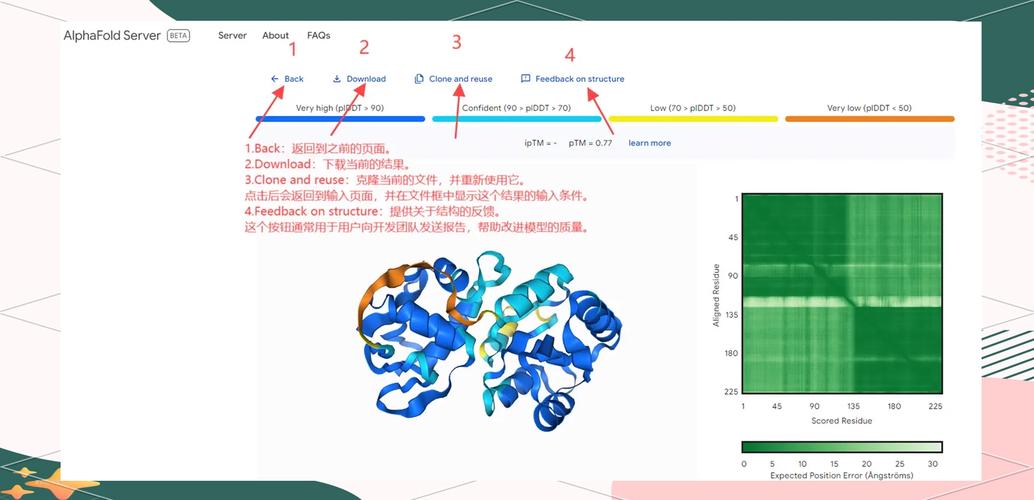 科研领域AlphaFold开源蛋白预测运行界面
说实话,这才是开源最厉害的地方。它把原来攥在少数大机构、大公司手里的技术门槛,直接砸得稀碎。现在一个双非学校的本科生,花几十块钱租个云服务器,就能用全球最顶尖的开源工具做实验,放十年前想都不敢想。
现在你投顶会论文,方法部分不说你用了哪个开源框架,不说你的代码开不开源,审稿人第一印象就差了。没人愿意再花时间验证你自己攒的、没公开的屎山代码对不对。
这就是趋势。你不认也得认。
 GitHub开源项目常见许可证类型说明图
不过话说回来,大部分人对开源技术应用的误解都在这里:觉得不就是git clone下来跑一跑,拼拼凑凑出结果?
真不是。我见过做得好的,拿开源的大模型做基础,针对自己研究领域的特定数据做微调,改了核心的注意力机制,最后效果比原模型好30%,还反过来给原项目提了pull request,被合并到主干里了。这才叫真的应用,不是发水文的套路。
你至少得看懂核心模块的逻辑,知道哪里可能有坑,知道怎么适配自己的数据,对吧?拿着别人的轮子就往自己车上装,轮子什么材质都不知道,跑起来不翻车才怪。
 新科研范式正在长出来
现在全球都在推开放科学,很多国家的基金委已经明确要求,受公共经费资助的科研项目,论文发表的时候必须同步开源代码和原始数据。
这其实就是开源技术应用带来的改变。原来的科研是关门做,我做出来结果告诉你,你信不信全靠我人品,重复不出来你也拿我没办法。现在不一样了,代码公开,数据公开,任何人都能拉下来跑一遍,对不对一验就知道,水文章自然就少了。
更有意思的是开源协作。现在很多大的科研项目,比如全球气候模拟、罕见病靶点筛选,都是几百个来自不同国家不同机构的研究者,一起在GitHub上协作改代码,更新数据,谁有新想法就改一版,大家一起验证。换以前,这么大的项目,哪个机构能独揽?哪里有这么高的效率?
当然我也吐槽一下现在的歪风,很多人什么创新都没有,拿开源模型改两个参数,换个数据集就发一篇论文,凑职称凑项目,这种水文再多,也没什么真正的价值。
但你不能否认开源给整个科研圈带来的改变。原来做科研,拼资源拼设备拼经费,普通人没机会。现在呢?只要你有想法,哪怕你没多少钱没资源,靠开源工具就能做出不错的成果。我上周刚看到一个双非院校的本科生,用开源大模型做了一个罕见病致病基因预测,发了不错的SCI,他说整个过程除了云服务器花了几百块,没花别的钱。
这放在十年前,想都不敢想。
这就是开源的魔力。它不是什么高大上的概念,就是一群人愿意把自己的成果拿出来,让更多站在肩膀上的人,走得更远一点。
开源砸穿了科研圈的旧壁垒
放在十年前,做科研有多看重资源?一个课题组有没有钱买商业软件、买数据库授权,直接决定了你能做什么方向。 我认识一个做结构生物学的老教授,课题组十年前申请经费,一半预算给了两款商业结构预测软件,剩下的钱才够买试剂。一年授权费十几万,对于刚起步的青年学者来说,直接把路堵死了。 AlphaFold开源那会,整个圈都炸了。顶尖实验室花了好几年训出来的模型,直接把代码和权重全放出来了,任何人都能免费下载用。多少小课题组直接不用再买授权了?科研领域AlphaFold开源蛋白预测运行界面
说实话,这才是开源最厉害的地方。它把原来攥在少数大机构、大公司手里的技术门槛,直接砸得稀碎。现在一个双非学校的本科生,花几十块钱租个云服务器,就能用全球最顶尖的开源工具做实验,放十年前想都不敢想。
现在你投顶会论文,方法部分不说你用了哪个开源框架,不说你的代码开不开源,审稿人第一印象就差了。没人愿意再花时间验证你自己攒的、没公开的屎山代码对不对。
这就是趋势。你不认也得认。
踩过坑才懂:开源不是拿来就用的拼贴
我见过太多新手踩坑了。 去年有个读研的孩子找我,说他做生信分析,图省事直接从GitHub找了个星标最高的流程工具,跑出来结果很漂亮,发了预印本,结果被同行扒出来这个工具自带的训练集有严重的批次偏差,整个结论的偏差率超过40%,最后文章撤稿,延毕了大半年。 太可惜了。 还有更冤的。某高校一个课题组拿了GPL协议的开源代码改改,用到了自己的商业化项目里,没按照要求开放自己的衍生代码,直接被原作者起诉,最后赔了几十万。许可证问题绝对不能大意,很多新手根本不看,星高就敢用,出事了才追悔莫及。GitHub开源项目常见许可证类型说明图
不过话说回来,大部分人对开源技术应用的误解都在这里:觉得不就是git clone下来跑一跑,拼拼凑凑出结果?
真不是。我见过做得好的,拿开源的大模型做基础,针对自己研究领域的特定数据做微调,改了核心的注意力机制,最后效果比原模型好30%,还反过来给原项目提了pull request,被合并到主干里了。这才叫真的应用,不是发水文的套路。
你至少得看懂核心模块的逻辑,知道哪里可能有坑,知道怎么适配自己的数据,对吧?拿着别人的轮子就往自己车上装,轮子什么材质都不知道,跑起来不翻车才怪。
新科研范式正在长出来
新科研范式正在长出来
现在全球都在推开放科学,很多国家的基金委已经明确要求,受公共经费资助的科研项目,论文发表的时候必须同步开源代码和原始数据。
这其实就是开源技术应用带来的改变。原来的科研是关门做,我做出来结果告诉你,你信不信全靠我人品,重复不出来你也拿我没办法。现在不一样了,代码公开,数据公开,任何人都能拉下来跑一遍,对不对一验就知道,水文章自然就少了。
更有意思的是开源协作。现在很多大的科研项目,比如全球气候模拟、罕见病靶点筛选,都是几百个来自不同国家不同机构的研究者,一起在GitHub上协作改代码,更新数据,谁有新想法就改一版,大家一起验证。换以前,这么大的项目,哪个机构能独揽?哪里有这么高的效率?
当然我也吐槽一下现在的歪风,很多人什么创新都没有,拿开源模型改两个参数,换个数据集就发一篇论文,凑职称凑项目,这种水文再多,也没什么真正的价值。
但你不能否认开源给整个科研圈带来的改变。原来做科研,拼资源拼设备拼经费,普通人没机会。现在呢?只要你有想法,哪怕你没多少钱没资源,靠开源工具就能做出不错的成果。我上周刚看到一个双非院校的本科生,用开源大模型做了一个罕见病致病基因预测,发了不错的SCI,他说整个过程除了云服务器花了几百块,没花别的钱。
这放在十年前,想都不敢想。
这就是开源的魔力。它不是什么高大上的概念,就是一群人愿意把自己的成果拿出来,让更多站在肩膀上的人,走得更远一点。