拆解知识图谱构建:从实验室到落地的那些坑和门道
你一定刷到过那种号称“十分钟从零搭建知识图谱”的教程吧?点进去一看,全是拿公开的标准数据集跑个demo,界面花里胡哨,点两下就能出个可视化关系图。真到你拿着自己企业乱七八糟的数据上手试试?全歇菜!
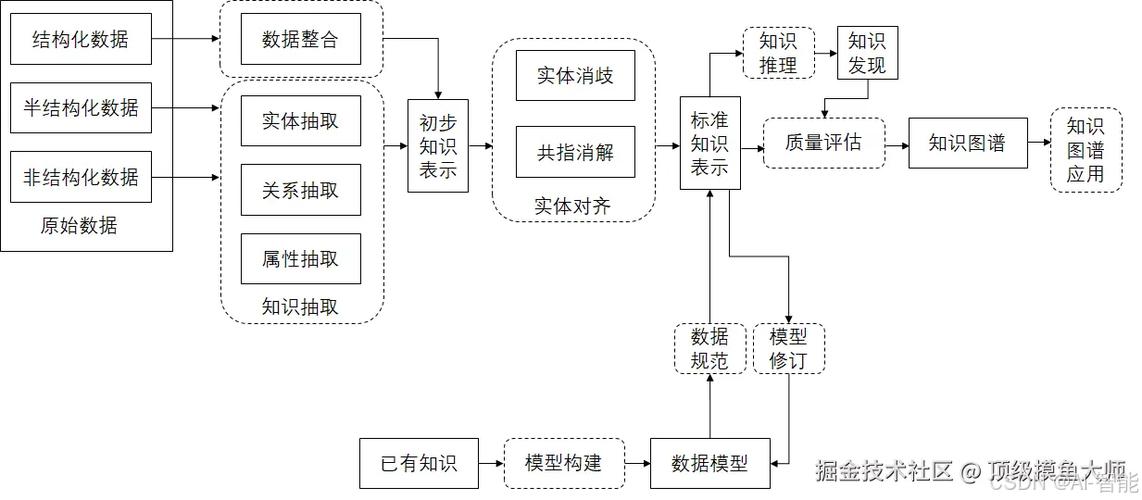 企业非结构化数据知识图谱抽取流程
很多人搞反了顺序。知识图谱构建,核心从来不是画个漂亮的本体图,核心是怎么从脏数据里掏出准确的信息,对吧?
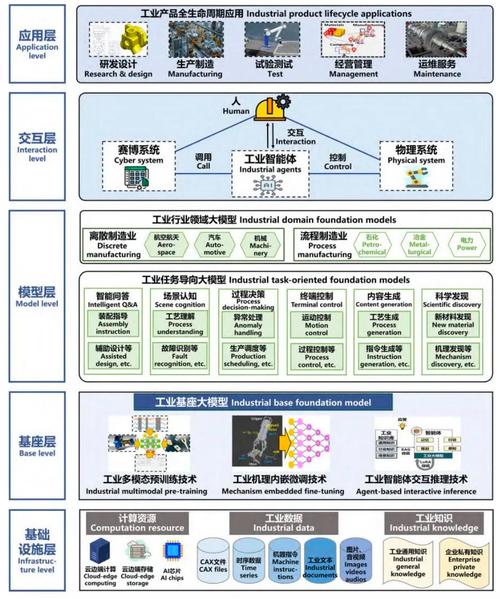 大模型结合知识图谱构建架构图
不过话说回来,不管用不用大模型,构建知识图谱的思路一定要改,别搞那种大而全的一次性建设。现在业内做得好的,都走小步迭代的路线。
什么意思?你先搞清楚,你做知识图谱是解决什么具体问题?比如你要做企业风控,那核心需求就是搞清楚实控人和企业的股权关系、关联担保关系对吧?那你一开始就别搞什么供应商、项目、资质这些乱七八糟的,就先做“企业”“自然人”两个核心实体,就做“控股”“担保”两种核心关系,找个一两千条标注,先跑通整个流程,验证这个东西确实能帮你发现隐蔽的关联风险,再慢慢加其他实体和关系。
这样一来,三个月就能出能用的东西,就能看到价值,不会像之前那种,做了一年还在搭框架,钱花完了还没见效果。
 知识图谱构建落地,最容易被忽略的隐形坑
很多人以为,把实体和关系都抽出来,存进图数据库,知识图谱构建就完成了。哪有这么简单。我给你说两个最常见的坑,十个项目九个栽。
第一个坑就是实体对齐。同一个人,不同数据源里的叫法能差十万八千里。比如说马化腾,有的地方叫马化腾,有的叫马总,有的叫pony ma,还有的写错字成马化滕,你得把这些都归到同一个实体底下吧?反过来,同名的两个人,都叫张亮,一个是公司前台,一个是公司股东,你不能把他们凑一块吧?
这个活说起来简单,做起来要命。我之前听一个做政务知识图谱的朋友说,他们光是处理公民的重名问题,就专门调了两个工程师优化了三个月,就这,还有千分之一的错误率,千分之一放到十万条数据里就是一百个错,放到政务场景里,说不定就能出大问题。
第二个坑就是持续更新。知识是会变的啊!企业的股权变了,董事换了,人离职了,产品下架了,你的知识图谱不更,那就是一潭死水。过个半年一年,里面的数据全错了,你说这个图谱还有啥用?
好多乙方做项目,交付的时候拍胸脯说图谱建完了,收了尾款就走人,根本没给甲方做自动更新的流程。甲方没人懂维护,放一年就成了摆设,最后所有人都骂知识图谱是骗钱的,你说冤不冤?
所以说,知识图谱构建从来不是一锤子买卖,它是个持续运营的活。你一开始做构建的时候,就要把增量更新、实体对齐的迭代流程设计好,能自动化做的就自动化做,每天自动拉新数据,抽新关系,自动对齐,只把有疑问的丢给人工复核,这样成本才控得住,图谱才能一直有用。
现在知识图谱概念炒了这么多年,好多人吹得神乎其神,也好多人说它没用。其实说白了,就是构建的思路对不对,有没有贴合业务。别搞那些花里胡哨的概念,从解决一个小问题开始,慢慢滚雪球,做出来的东西自然有用。
别被低代码工具骗了:知识图谱构建的核心门槛从来不是建模
现在市面上一堆知识图谱工具,都吹“零代码构建”“一键生成”,把建模这个步骤说得轻轻松松。好多外行真信了,花大价钱买工具,结果卡数据抽取这一步,卡了大半年出不了结果。 说实话,国内企业能拿出来用的干净数据有多少?百分之八十都是非结构化数据:散乱的合同文本、内部聊天记录、不同系统导出来的异构表格、扫描件里的文字...这些数据,你哪怕用最牛的工具,一开始也抽不对实体和关系。 我之前见过一个做供应链的客户,老板听了厂商忽悠,上来就要做全产业链的知识图谱,光本体设计就做了四个月,列了一百多种实体,七十多种关系,结果全量抽完一看,实体对齐准确率才42%,整个图谱就是个垃圾,之前四个月的功夫全打了水漂,老板气得直骂娘。企业非结构化数据知识图谱抽取流程
很多人搞反了顺序。知识图谱构建,核心从来不是画个漂亮的本体图,核心是怎么从脏数据里掏出准确的信息,对吧?
大模型时代,知识图谱构建的新思路
大模型出来之后,整个知识图谱构建的流程都变了。放在五年前,你要做一个实体抽取模型,没个几万条标注数据根本出不了效果,标注成本动不动几十万,小公司根本玩不起。 现在呢?拿GPT或者国内的通义、文心做小样本抽取,你给个几十条标注样例,抽出来的效果就能赶上以前几千条标注的水平,成本直接砍到十分之一。这不是开玩笑,我去年帮一个初创公司做法务知识图谱,总共就标了300多条数据,抽核心法律条款的关系准确率能到89%,放以前想都不敢想。 当然,大模型不是万能的。它会瞎编啊。抽着抽着给你凭空造出来一个不存在的关系,或者把两个没关系的实体扯到一块,你要是直接入库,那用的时候肯定出乱子。所以现在业内通用的做法是,大模型抽完,再加一层规则校验+小模型去噪,把明显错的先筛掉,最后只留置信度高的进库。大模型结合知识图谱构建架构图
不过话说回来,不管用不用大模型,构建知识图谱的思路一定要改,别搞那种大而全的一次性建设。现在业内做得好的,都走小步迭代的路线。
什么意思?你先搞清楚,你做知识图谱是解决什么具体问题?比如你要做企业风控,那核心需求就是搞清楚实控人和企业的股权关系、关联担保关系对吧?那你一开始就别搞什么供应商、项目、资质这些乱七八糟的,就先做“企业”“自然人”两个核心实体,就做“控股”“担保”两种核心关系,找个一两千条标注,先跑通整个流程,验证这个东西确实能帮你发现隐蔽的关联风险,再慢慢加其他实体和关系。
这样一来,三个月就能出能用的东西,就能看到价值,不会像之前那种,做了一年还在搭框架,钱花完了还没见效果。
知识图谱构建落地,最容易被忽略的隐形坑
知识图谱构建落地,最容易被忽略的隐形坑
很多人以为,把实体和关系都抽出来,存进图数据库,知识图谱构建就完成了。哪有这么简单。我给你说两个最常见的坑,十个项目九个栽。
第一个坑就是实体对齐。同一个人,不同数据源里的叫法能差十万八千里。比如说马化腾,有的地方叫马化腾,有的叫马总,有的叫pony ma,还有的写错字成马化滕,你得把这些都归到同一个实体底下吧?反过来,同名的两个人,都叫张亮,一个是公司前台,一个是公司股东,你不能把他们凑一块吧?
这个活说起来简单,做起来要命。我之前听一个做政务知识图谱的朋友说,他们光是处理公民的重名问题,就专门调了两个工程师优化了三个月,就这,还有千分之一的错误率,千分之一放到十万条数据里就是一百个错,放到政务场景里,说不定就能出大问题。
第二个坑就是持续更新。知识是会变的啊!企业的股权变了,董事换了,人离职了,产品下架了,你的知识图谱不更,那就是一潭死水。过个半年一年,里面的数据全错了,你说这个图谱还有啥用?
好多乙方做项目,交付的时候拍胸脯说图谱建完了,收了尾款就走人,根本没给甲方做自动更新的流程。甲方没人懂维护,放一年就成了摆设,最后所有人都骂知识图谱是骗钱的,你说冤不冤?
所以说,知识图谱构建从来不是一锤子买卖,它是个持续运营的活。你一开始做构建的时候,就要把增量更新、实体对齐的迭代流程设计好,能自动化做的就自动化做,每天自动拉新数据,抽新关系,自动对齐,只把有疑问的丢给人工复核,这样成本才控得住,图谱才能一直有用。
现在知识图谱概念炒了这么多年,好多人吹得神乎其神,也好多人说它没用。其实说白了,就是构建的思路对不对,有没有贴合业务。别搞那些花里胡哨的概念,从解决一个小问题开始,慢慢滚雪球,做出来的东西自然有用。