云计算平台构建:踩过坑的老炮掏的实在经验
我前两年帮朋友搭私有云计算平台,差点把后脑勺的头发都薅光。
很多人觉得这不就是买几台服务器插上电,装个管理系统就完事?
大错特错。
说实话,这行坑多到你不敢想,今天就把我踩过的坑、总结出来的干货全抖出来。
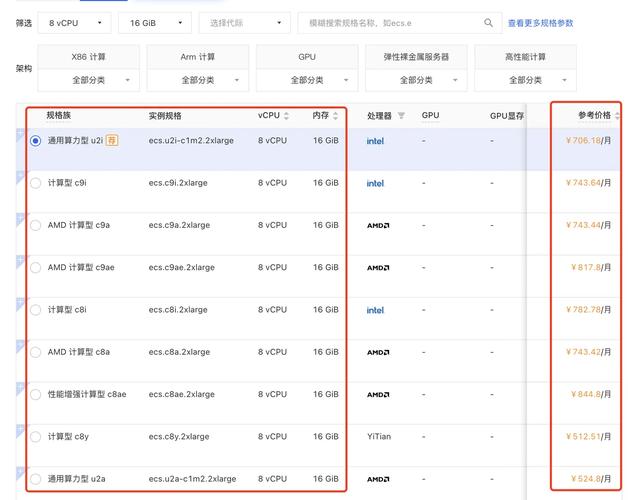 云计算平台不同负载资源匹配对照表
之前碰过一个做政企内部系统的客户,听厂商忽悠买了八台A100,最后显卡显存使用率常年不到5%,几百万扔水里,连个响都没听见。
不过话说回来,现在很多企业非要死磕全栈私有云,其实完全没必要。核心敏感数据放本地私有集群,非核心的弹性流量甩给公有云按需付费,成本直接降一半都不止,弹性还更好。别被什么「全栈自研」的名头忽悠,能省钱能干活的才是好的。
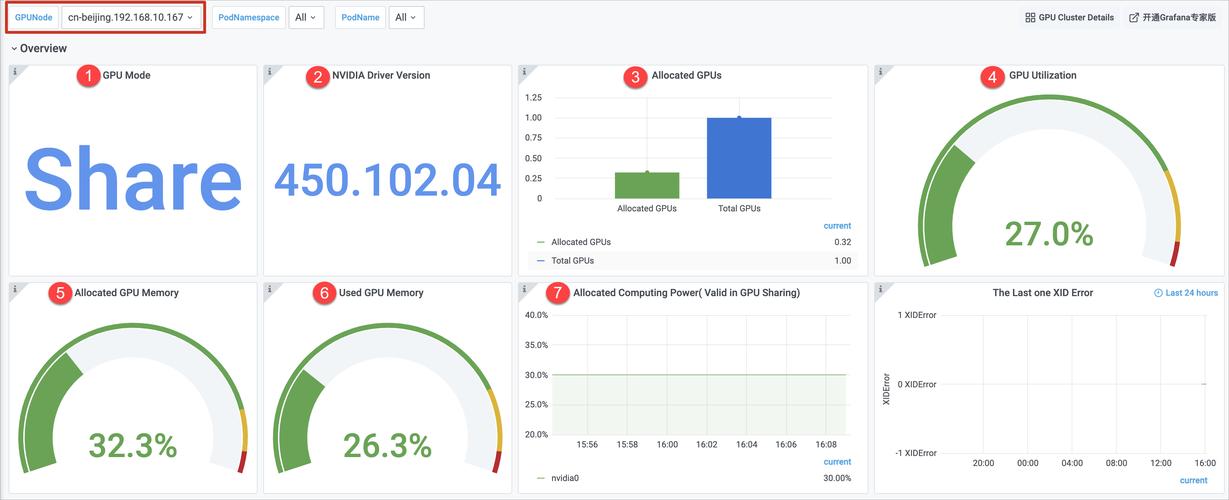 云计算GPU集群资源调度监控界面
说实话,现在很多小团队构建平台,上来就堆功能,什么服务网格、全链路可观测、分布式追踪一股脑全装上,最后这些周边组件占了集群快10%的资源,纯属捡芝麻丢西瓜。
你先把核心的资源调度搞定,能把硬件利用率拉起来,剩下的花里胡哨的功能,慢慢加不行吗?
这两年存算分离架构火得一塌糊涂,确实解决了很多老架构的问题。原来存算绑死,你要扩算力就得加带存储的节点,最后存储越堆越多,用不完全浪费。现在把存储层和计算层拆开,各自弹性扩容,成本一下子就下来了,尤其适合大模型训练这种对算力波动需求大的场景。
但我要泼一盆冷水,存算分离对网络带宽要求极高,别想着省钱用万兆以太网凑活,现在25G是入门标配,要是做大规模集群,直接上IB网络,不然数据拉取延迟卡得你想死,存算分离反而成了大坑。
 安全和容灾,别等出事了才想起补窟窿
我见过太多平台,上线跑得飞起,一次硬盘故障、一次黑客攻击,直接全平台挂三天,业务损失上百万,才想起原来我没做容灾。
很多人说,我做了三副本存储,不就没事了?三副本只能防单盘损坏,要是整个机柜断电呢?运营商挖光纤把你专线挖断了呢?机房起火了呢?
跨可用区的异地容灾,真不是给大厂做的玄学,是真能救命的东西。哪怕你是小团队,至少也要做核心数据的异地备份,每周抽一小时测一次恢复,别嫌麻烦。真出事的时候,你能把数据找回来,这就是你跟老板的救命稻草。
再说安全,现在云计算平台大多要对外开放API,很多团队图方便,权限开得很大,也不做细粒度隔离,随便一个实习生的账号泄露,整个平台的核心数据就全被拖走。之前有个做SaaS的朋友,就是构建平台的时候没做权限隔离,离职员工带着所有客户数据跑了,公司直接半垮,到现在都没缓过来。
现在很多人觉得零信任是大厂才玩得起的东西,其实不是,你哪怕只有五六台机器的小集群,做个基础的每次访问都身份验证,别开了公网端口就不管不问,现在黑客扫端口比你刷短视频还勤快,你留个后门,人家分分钟就进来了。
最后说一句,云计算平台构建从来不是照着PPT堆硬件,也不是什么高大上的黑科技,都是一步一个坑踩出来的。想清楚需求,抓好核心调度,提前做好安全容灾,比什么花里胡哨的概念都管用。
别上来就堆硬件,先盘清楚你到底要跑什么
不少老板刚上马项目,上来就拍板:给我买最好的服务器,要够大够先进。最后账单下来吓一跳,一半资源常年闲着,每个月水电费都亏几十万,找谁哭去? 构建云计算平台的第一步,永远不是下单买机器,是理清楚你平台上的核心负载。 你跑的是大模型微调训练?还是企业内部的文档存储OA?还是电商直播的动态流量推流?不同场景的资源需求,差得能有十万八千里。 跑大模型训练的,GPU卡的单卡显存比CPU核心数量重要一万倍,要是你拿一堆高CPU低显存的机器凑集群,跑个7B模型都要切块,慢到你怀疑人生。要是你只是放内部员工的文档和报销系统,那大容量SATA盘比什么顶级NVMe划算多了,性能差不了多少,成本能砍三分之二。云计算平台不同负载资源匹配对照表
之前碰过一个做政企内部系统的客户,听厂商忽悠买了八台A100,最后显卡显存使用率常年不到5%,几百万扔水里,连个响都没听见。
不过话说回来,现在很多企业非要死磕全栈私有云,其实完全没必要。核心敏感数据放本地私有集群,非核心的弹性流量甩给公有云按需付费,成本直接降一半都不止,弹性还更好。别被什么「全栈自研」的名头忽悠,能省钱能干活的才是好的。
底层调度搞不定,再贵的硬件都是废铁
我见过太多平台,硬件花了上千万,打开监控一看,整体资源利用率不到20%。说白了,就是调度没做好。 现在几乎所有人都用容器化部署,K8s是标配,但K8s默认的调度策略,真的适配不了所有场景。上个月帮一家做AI生成绘图的公司调集群,原来他们不管任务大小,随机分配节点,经常出现大任务占满了小节点的GPU,一堆小任务塞不进去,大节点还空着一半显存,整个集群天天阻塞,接不了新单。 后来我们改了根据任务显存预估、动态打散的调度策略,直接把集群GPU利用率拉到了65%,等于平白多出来小半集群的算力,不用加机器就能多接三成的订单,老板当时就要请我们吃火锅。云计算GPU集群资源调度监控界面
说实话,现在很多小团队构建平台,上来就堆功能,什么服务网格、全链路可观测、分布式追踪一股脑全装上,最后这些周边组件占了集群快10%的资源,纯属捡芝麻丢西瓜。
你先把核心的资源调度搞定,能把硬件利用率拉起来,剩下的花里胡哨的功能,慢慢加不行吗?
这两年存算分离架构火得一塌糊涂,确实解决了很多老架构的问题。原来存算绑死,你要扩算力就得加带存储的节点,最后存储越堆越多,用不完全浪费。现在把存储层和计算层拆开,各自弹性扩容,成本一下子就下来了,尤其适合大模型训练这种对算力波动需求大的场景。
但我要泼一盆冷水,存算分离对网络带宽要求极高,别想着省钱用万兆以太网凑活,现在25G是入门标配,要是做大规模集群,直接上IB网络,不然数据拉取延迟卡得你想死,存算分离反而成了大坑。
安全和容灾,别等出事了才想起补窟窿
安全和容灾,别等出事了才想起补窟窿
我见过太多平台,上线跑得飞起,一次硬盘故障、一次黑客攻击,直接全平台挂三天,业务损失上百万,才想起原来我没做容灾。
很多人说,我做了三副本存储,不就没事了?三副本只能防单盘损坏,要是整个机柜断电呢?运营商挖光纤把你专线挖断了呢?机房起火了呢?
跨可用区的异地容灾,真不是给大厂做的玄学,是真能救命的东西。哪怕你是小团队,至少也要做核心数据的异地备份,每周抽一小时测一次恢复,别嫌麻烦。真出事的时候,你能把数据找回来,这就是你跟老板的救命稻草。
再说安全,现在云计算平台大多要对外开放API,很多团队图方便,权限开得很大,也不做细粒度隔离,随便一个实习生的账号泄露,整个平台的核心数据就全被拖走。之前有个做SaaS的朋友,就是构建平台的时候没做权限隔离,离职员工带着所有客户数据跑了,公司直接半垮,到现在都没缓过来。
现在很多人觉得零信任是大厂才玩得起的东西,其实不是,你哪怕只有五六台机器的小集群,做个基础的每次访问都身份验证,别开了公网端口就不管不问,现在黑客扫端口比你刷短视频还勤快,你留个后门,人家分分钟就进来了。
最后说一句,云计算平台构建从来不是照着PPT堆硬件,也不是什么高大上的黑科技,都是一步一个坑踩出来的。想清楚需求,抓好核心调度,提前做好安全容灾,比什么花里胡哨的概念都管用。