大数据技术研发:踩过的坑,和藏在新风口里的机会
别迷信大厂开源,大部分研发落地都是在填自己挖的坑
说实话,我最近帮朋友看了三个创业团队的大数据研发项目,全踩了同一个坑。
上来就奔着最新的湖仓一体、向量数据库,把Github上星最多的框架全部堆上去,搭完了跑测试样例跑得飞起,一上真实生产数据直接垮。连最基础的数据一致性都保证不了,天天对着报错日志挠头。
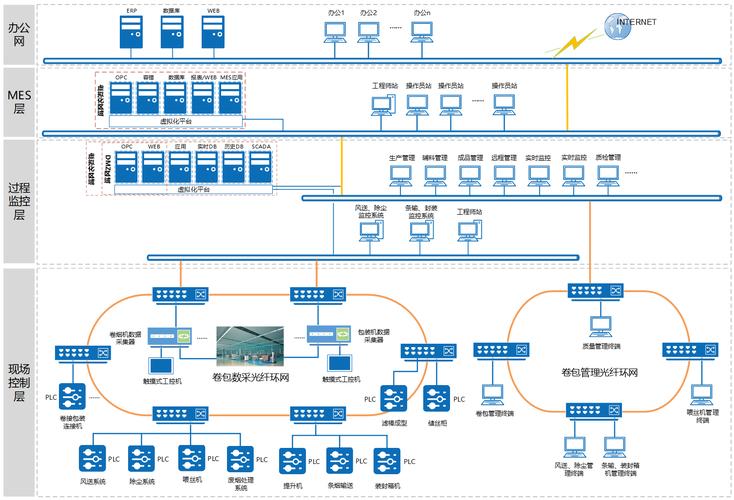 企业大数据研发生产环境拓扑图
说起来好笑,我早年间在某头部零售做大数据技术研发的时候,也干过这种蠢事。为了赶老板要的实时数仓KPI,把当时刚火、风头无两的某开源流式框架直接换掉了稳定跑了两年的Flink,结果上线第一天就丢了三分之一的订单数据,连着熬了三个大夜才回滚成功,那半个月头皮都被我抠破了。
现在很多营销号喊,大数据技术研发已经成熟了,框架都给你搭好了,你只要拼积木就行。扯。
每个企业的数据脏程度、业务QPS、存储成本要求全不一样,大厂开源的东西都是适配它自己亿级流量场景的,拿过来不改个百分之三四十根本用不了。很多新手研发看不见这点,上来就堆新技术,最后把自己堆进去了。
真正的大数据技术研发,90%的工作量都是在适配实际场景,剩下10%才是所谓的创新。 那些看起来漂亮的架构图,背后全是补不完的窟窿,没什么捷径可走。
大模型带火的新方向,藏着很多研发人没注意到的红利
前两年还有人喊,大数据技术研发已经饱和了,都是夕阳岗位了。我就笑,这不是岗位饱和,是你跟不上需求变而已。
这两年大模型火了之后,大数据研发不是没活干了,反而是活多到接不过来,只不过玩法变了。之前大数据研发做的是什么?给业务做报表,给分析师提数,每天都是处理离线T+1,延迟几个小时都没人骂。现在呢?
现在企业要把自己的私有数据喂给大模型做微调、做RAG,要求什么?数据得清洗得干净,得打标打得准,还得能实时更新,对不对?差一点,大模型输出就是一堆胡说八道的幻觉。
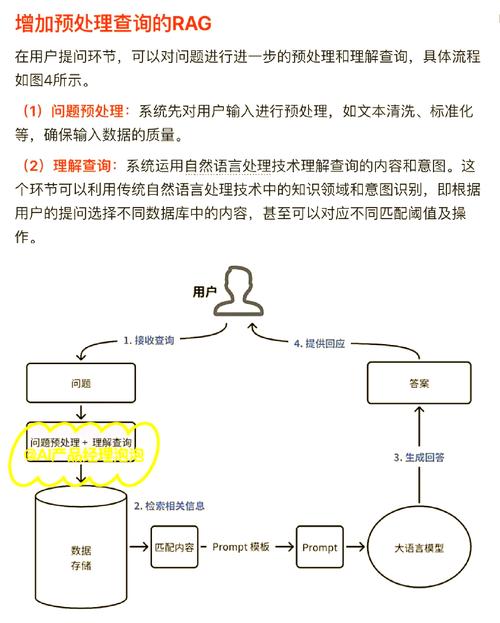 大模型RAG架构大数据预处理流程图
我上个月接触到一个做自动驾驶数据服务的团队,他们之前就是给车厂标框,赚点辛苦的加工钱,今年转做大模型训练数据的清洗研发,不到一年团队从十几人扩到六十多,利润率比之前翻三倍。为什么?
因为大家都知道大模型好,但是没有高质量的训练数据,大模型就是空架子。而能把杂乱的、散落各处的原始数据,处理成符合大模型要求的结构化、标准化数据,这就是现在大数据技术研发最香的新饭票啊。
之前很多人吐槽大数据研发是企业成本中心,不赚钱,现在你去招聘网站看看,哪家做大模型的企业不在抢懂数据清洗、懂数据分层、懂向量索引优化的大数据研发?说白了,大模型是熬粥的锅,好数据才是米,你会淘米,就饿不着。
研发人最容易丢掉的核心能力:对成本的敏感度
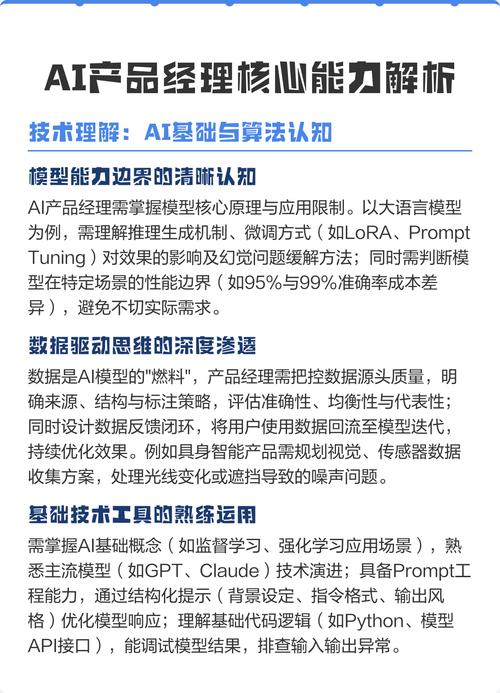 研发人最容易丢掉的核心能力:对成本的敏感度
不过话说回来,现在很多新入行的大数据研发,根本就没成本这个概念。我前阵子面试过一个名牌大学的博士,简历写得花里胡哨,做的项目是用千亿级参数的模型做用户行为预测,各种指标都很好看。
我就问他一句话:你这个项目如果放到一个月活百万的普通APP上跑,每个月存储加算力要花多少钱?他直接答不上来。说白了,就是在学校拿免费算力做实验做惯了,不知道真实企业里,每1TB存储、每一小时算力都是要掏真金白银的。
我认识一个挺厉害的研发leader,去年帮公司做大数据架构优化,没加什么花里胡哨的新功能,就是把三年以上没人碰的冷数据,从昂贵的全闪存储挪到便宜的对象存储,再把每天重复计算的中间结果做了分层缓存,直接把每个月的算力成本砍了三分之二,老板直接给了半年奖金。这不比你堆十个新框架有用?
对成本的敏感,才是区分普通大数据研发和顶级研发的核心标尺。
你想啊,现在企业都在降本增效,你技术再牛,一上线每个月烧几十万,哪个老板受得了?反过来,你技术不是最顶尖的,但能把现有的架构优化得又便宜又稳,那你就是公司的宝贝,没人能替代你。
很多人现在说大数据技术研发内卷,找不到好工作,我看不对啊。卷的都是那种只会搭现成框架,不会解决实际问题的人,真的能落地、懂成本、能跟上大模型新需求的人,现在抢都抢不到。
去年我一个师弟,原来做传统数仓,三十四岁了,本来还愁被刚毕业的年轻人卷走,花了大半年时间啃透了大模型数据预处理的整套技术,今年年初跳去一家头部AI公司,薪资直接涨了六成,羡煞我们这帮老大哥。
说白了,哪有什么不赚钱的方向,只有不肯挪步的人。你跟着市场需求变,哪里都有你的位置。对吧?