知识图谱构建:从苦差事到核心竞争力的行业变化
前两年接项目的时候,我还觉得知识图谱构建就是个吃力不讨好的苦活。
真的苦。
那时候要做一个落地的领域知识图谱,团队三四个人扑上去,少则两三个月,多则大半年,大部分时间都在抠标注理关系,甲方改一次需求,整个骨架都要动。
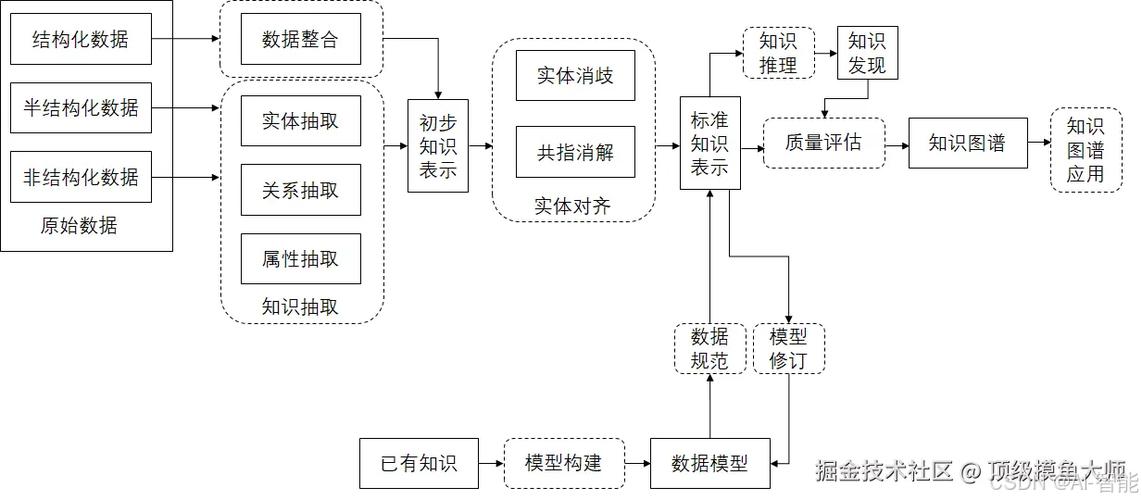 传统知识图谱人工构建流程表
我记得19年做一个车企的零部件知识图谱,光梳理不同车型发动机零件的从属关系,两个工程师熬了整整四十天,就因为不同分厂的零件命名规则不统一,同一个螺栓有三个不同的代号,理到最后两个人看到螺栓都想吐。
那时候很多创业公司做知识图谱,钱都烧在人力标注上了,项目做完根本赚不到钱,还落下个交付慢的骂名。
说实话,那时候我都觉得,这行当再这么下去,早晚被新技术淘汰。
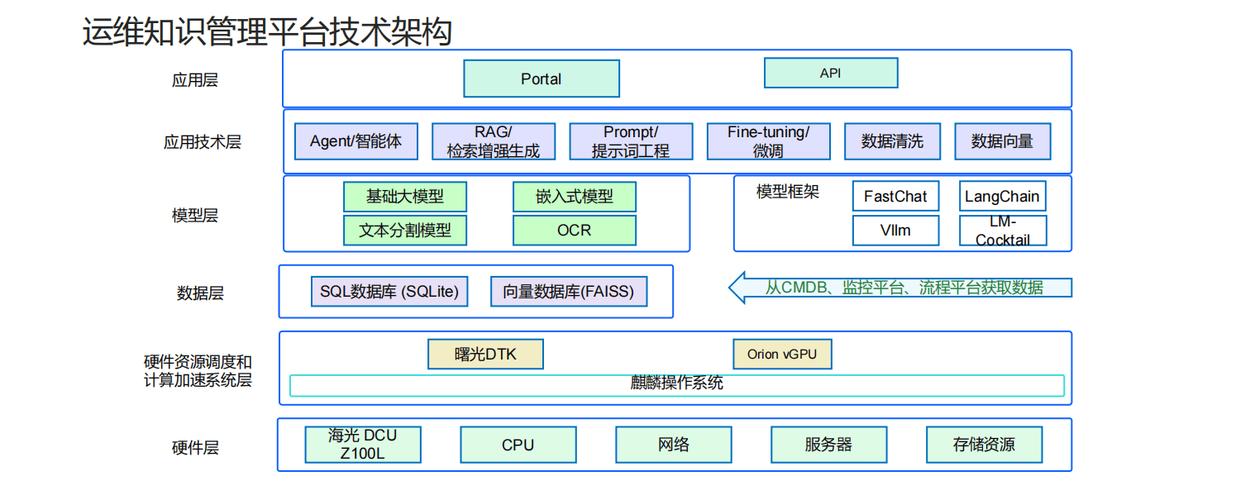 大模型辅助知识图谱构建架构图
不过话说回来,现在网上吹的"全自动化构建知识图谱",听听就行了,千万别信。大模型抽出来的东西,错得离谱的也不少,比如它能把"当归"和"当归来"分成两个不同的实体,还能给两个不相关的药方硬凑出"配伍"关系,说白了就是幻觉老毛病。现在业内最成熟的方案,还是半自动化,大模型做脏活累活,把大部分工作干了,人做最后一关校验,还有Schema的设计和调整,毕竟业务逻辑只有人懂。
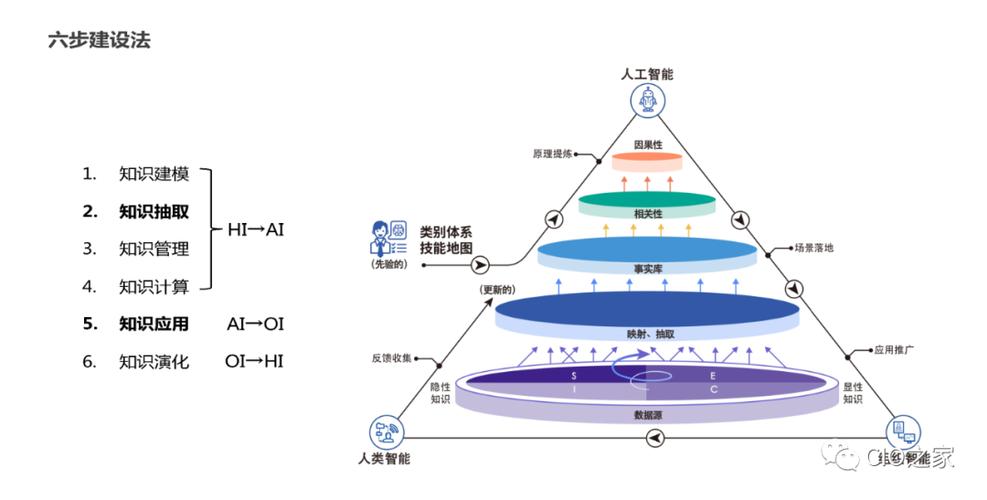 垂直领域知识图谱构建,三个坑一定要避开
做了快十年知识图谱,踩过的坑比我吃过的饭还多,说三个最容易翻车的,记下来能帮你省几十万。
第一个坑,实体对齐想当然。很多人拿大模型抽完实体就不管了,殊不知垂直领域同一个东西十个名字是常事,"冠心病"全称"冠状动脉粥样硬化性心脏病",俗称还有"胸口闷痛",不对齐的话,你搜出来的知识就是散的,整个图谱就是废的。现在通用的对齐模型对冷门外行词效果很差,一定要加领域词表做规则约束,别偷懒。
第二个坑,Schema定死不更新。很多项目刚开始的时候,甲方说我们业务就这么多,定死Schema就行,结果做着做着业务扩展了,加了新的品类新的关系,原来的Schema扩不动,整个图谱只能推倒重来,白扔好几十万。现在做构建,一定要留动态Schema的口子,支持随时加新的实体类型和关系类型,别图一时省事。
第三个坑,忽略长尾实体。90%的领域知识都是长尾,热门的实体大模型见过,冷门的比如某个十年前停产的设备型号,某个只有老中医才用的偏方名称,大模型训练数据里根本没有,抽不出来很正常。这时候别甩锅给大模型,老老实实做几页小样本迁移,或者加个人工录入的入口,不然上线之后用户一搜冷门内容全错,口碑直接没了。
去年GPT出来之后,好多人喊知识图谱死了,说大模型什么都知道,还要什么知识图谱。
我就笑笑。大模型有幻觉,要落地做专业领域的应用,必须要有靠谱的结构化知识做检索做约束,知识图谱就是大模型的"精准字典",而大模型反过来解决了知识图谱构建多年的效率痛点,两者本来就是互补的。
最近看OpenAI最新的GPT-4o相关论文,都在说要把外部结构化知识图谱接入模型做增强,这不就说明,玩来玩去,能构建出准确、实用的领域知识图谱,才是真的硬实力。
说白了,技术换了一波又一波,解决实际问题的本事,永远不会过时。
老套路已经跟不上现在的行业需求了
最早的知识图谱构建流程,说穿了就是人工堆出来的。先定Schema,也就是知识的分类框架,然后从各个数据源爬取抽取数据,接着做实体识别、实体对齐、关系抽取,最后存入图数据库。整个流程每一步都离不开人,尤其是垂直领域,比如医疗、制造、金融,行业黑话一堆,通用标注数据根本用不了,全部要自己标。传统知识图谱人工构建流程表
我记得19年做一个车企的零部件知识图谱,光梳理不同车型发动机零件的从属关系,两个工程师熬了整整四十天,就因为不同分厂的零件命名规则不统一,同一个螺栓有三个不同的代号,理到最后两个人看到螺栓都想吐。
那时候很多创业公司做知识图谱,钱都烧在人力标注上了,项目做完根本赚不到钱,还落下个交付慢的骂名。
说实话,那时候我都觉得,这行当再这么下去,早晚被新技术淘汰。
大模型来了之后,知识图谱构建变了天
大概从2022年下半年开始,圈内就开始试大模型辅助构建的路子,一开始我还不信,觉得大模型不就是会编嘛,怎么能用来抽知识? 直到去年跟所里的团队做了一个中医古籍的知识图谱项目,我才被打脸。 原来这种冷门项目,古籍都是扫描件转的文本,里面很多民间药方的名称、药材别名,根本没有现成的标注数据,换以前,光整理实体就要两三个月。这次我们用了大模型小样本提示抽取+小模型校验+人工终审的流程,只给大模型标了一百多个示例,它就把90%以上的实体和关系抽出来了,我们只花了十天就抽完了一百多万字的文本,最后人工复核只改了不到5%的错误。 效率提了快六倍你敢信?大模型辅助知识图谱构建架构图
不过话说回来,现在网上吹的"全自动化构建知识图谱",听听就行了,千万别信。大模型抽出来的东西,错得离谱的也不少,比如它能把"当归"和"当归来"分成两个不同的实体,还能给两个不相关的药方硬凑出"配伍"关系,说白了就是幻觉老毛病。现在业内最成熟的方案,还是半自动化,大模型做脏活累活,把大部分工作干了,人做最后一关校验,还有Schema的设计和调整,毕竟业务逻辑只有人懂。
垂直领域知识图谱构建,三个坑一定要避开
垂直领域知识图谱构建,三个坑一定要避开
做了快十年知识图谱,踩过的坑比我吃过的饭还多,说三个最容易翻车的,记下来能帮你省几十万。
第一个坑,实体对齐想当然。很多人拿大模型抽完实体就不管了,殊不知垂直领域同一个东西十个名字是常事,"冠心病"全称"冠状动脉粥样硬化性心脏病",俗称还有"胸口闷痛",不对齐的话,你搜出来的知识就是散的,整个图谱就是废的。现在通用的对齐模型对冷门外行词效果很差,一定要加领域词表做规则约束,别偷懒。
第二个坑,Schema定死不更新。很多项目刚开始的时候,甲方说我们业务就这么多,定死Schema就行,结果做着做着业务扩展了,加了新的品类新的关系,原来的Schema扩不动,整个图谱只能推倒重来,白扔好几十万。现在做构建,一定要留动态Schema的口子,支持随时加新的实体类型和关系类型,别图一时省事。
第三个坑,忽略长尾实体。90%的领域知识都是长尾,热门的实体大模型见过,冷门的比如某个十年前停产的设备型号,某个只有老中医才用的偏方名称,大模型训练数据里根本没有,抽不出来很正常。这时候别甩锅给大模型,老老实实做几页小样本迁移,或者加个人工录入的入口,不然上线之后用户一搜冷门内容全错,口碑直接没了。
去年GPT出来之后,好多人喊知识图谱死了,说大模型什么都知道,还要什么知识图谱。
我就笑笑。大模型有幻觉,要落地做专业领域的应用,必须要有靠谱的结构化知识做检索做约束,知识图谱就是大模型的"精准字典",而大模型反过来解决了知识图谱构建多年的效率痛点,两者本来就是互补的。
最近看OpenAI最新的GPT-4o相关论文,都在说要把外部结构化知识图谱接入模型做增强,这不就说明,玩来玩去,能构建出准确、实用的领域知识图谱,才是真的硬实力。
说白了,技术换了一波又一波,解决实际问题的本事,永远不会过时。