语音识别技术:从实验室错漏百出到飞入寻常百姓家
十年前谁能想到,错到离谱的技术能成刚需?
我还记得2013年第一次用语音输入法,对着手机说"帮我订一张明天去上海的高铁票",出来的文字是"帮我钉一张名山去上海的高铁飘"。
笑到摔手机。
那时候主流技术还是基于隐马尔可夫模型的统计方法,对语境的理解几乎为零,稍微带点口音,或者背景有个马路车声,直接彻底跑偏。那时候敢吹自己语音识别准确率90%的厂商,都是拿着安静实验室里的标准普通话数据测出来的,拿到真实生活场景里,一半都不对。
转折点其实是2016年。微软研究院放出了一个炸场的科研成果:他们用深度神经网络把Switchboard数据集的词错率WER降到了5.9%,首次低于人类转录的平均错误率7.9%。
整个行业都醒了。原来深度学习真的能把语音识别做通。
 2016年微软语音识别词错率科研成果对比图
从那之后,速度快到吓人。不到三年,各家大厂的语音识别准确率就冲到了98%以上,普通人标准普通话安静环境下,几乎不用改字。
说实话,那时候我都没想到这东西能渗透这么快。现在你去菜市场买菜,摊主都用语音输入法发补货消息,对吧?
现在的语音识别技术,早不是只会转文字了
很多人对语音识别的印象还停留在输入法转文字,其实早就延伸到各个角落了。车载导航不用抬手点,智能音箱直接喊着调温度,会议开完自动出带分段带说话人标记的纪要,甚至连短视频的字幕都是语音识别自动生成的。
不过话说回来,这两年最大的行业变化不是准确率提了零点几个百分点,是端侧语音识别普及了。
以前你说一句话,手机得把音频传到云端服务器识别,再把结果传回来,不仅慢,还担心隐私泄露。现在几百M的小模型就能放在手机本地,不上传也能识别,准确率差不了多少。越来越多的手机都支持离线语音指令,就算没网,喊一声打开相机也能成。
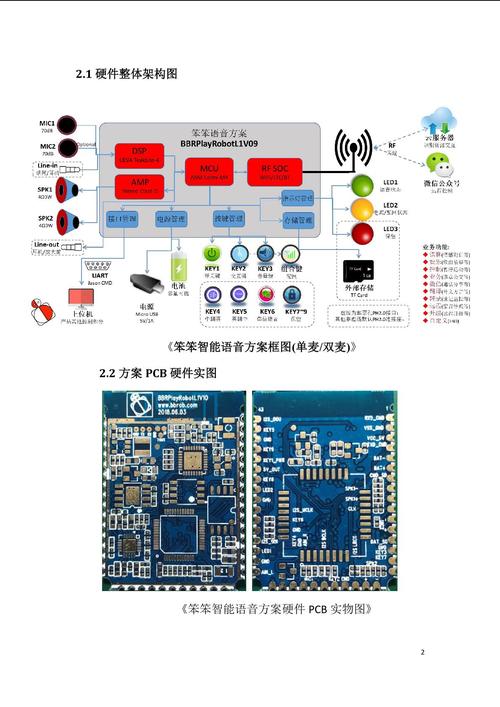 智能手机端侧离线语音识别芯片架构图
开源社区的进展也快得吓人。OpenAI放出的Whisper模型,直接把小语种、带口音语音的识别门槛拉到了地面,随便一个小团队都能拿来改改做自己的应用,不用再从零训练了。我上次帮一个做少数民族语言保护的朋友弄转录,用Whisper测了一下云南某地的哈尼语录音,准确率居然能到八成多,放在五年前想都不敢想。
现在科研方向也转了,不再盯着标准场景的准确率冲,开始啃硬骨头:比如多人混声分离,比如带强噪音的远场识别,比如低资源小语种的建模。
剩下的坑,才是语音识别技术下一轮要啃的硬骨头
 剩下的坑,才是语音识别技术下一轮要啃的硬骨头
别吹得太神,现在的语音识别还是一堆问题。
我上次开线上研讨会,三个人同时抢话,背景还有会议室的空调嗡鸣,出来的纪要直接乱成一锅粥,很多地方连不起来。还有人天生大舌头,或者带非常重的小众口音,现在识别率还是上不去。我老家的温州乐清方言,别说自动转写了,很多年轻人都听不懂,更别说模型能练到位。
这就是现在行业里说的低资源语音识别痛点。很多小语种、小众方言没有几十万小时的标注数据,大模型根本训不出来,现在科研人员都在研究半监督、无监督的训练方法,只用几百小时数据就能训出能用的模型,这块已经有不少进展了,估计再过三五年,小众方言的转写也能民用。
还有隐私的问题。虽然端侧识别普及了,很多应用还是偷偷把你的语音数据上传拿去训模型,之前曝光过不少这种事,用户防不胜防。接下来怎么在保证体验的前提下,把数据隐私彻底锁在本地,也是行业要解决的大问题。
想想真挺神奇的。十年前我们还在吐槽语音识别是人工智障,现在我们已经离不开它了。开车的时候发消息,不用抬手,张嘴说就行;开会记笔记,不用噼里啪啦敲,结束直接拿整理好的稿子走;甚至眼睛不好的朋友,全靠语音识别来操作手机。
技术改变生活,从来不是从一个完美的黑科技开始的。都是从错漏百出,一点点磨,磨到你感觉不到它的存在,变成像空气一样自然的东西。
语音识别就是这样。