抗风险技术设计:从频发故障看真正的系统风险免疫力
上个月跟老陈吃饭,他是某头部互联网公司的资深架构师,烟一根接一根抽,半盒下去才开口。上个月一次区域性运营商光缆挖断,他们主站点挂了四个小时,商户赔偿加品牌罚款,小一个亿打了水漂。
老陈说,出事之后复盘,最大的问题不是没做灾备,是灾备从来没真正用过。所有人都以为自己会切,真到那时候,手忙脚乱输错了配置,又多耽误了一个多小时。
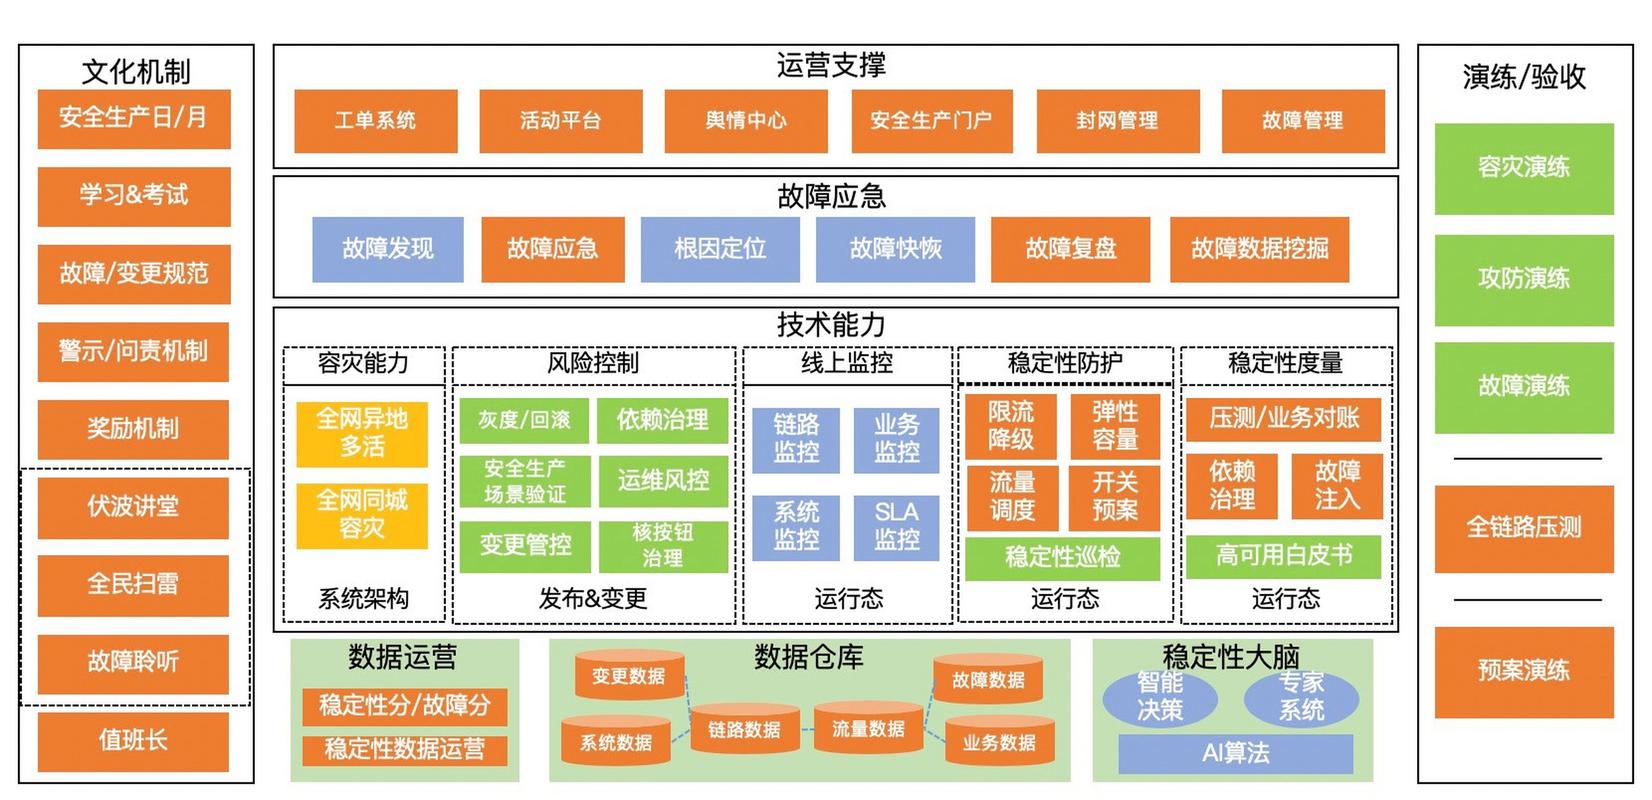 企业常见错误抗风险技术设计架构图
这种说白了,就是骗自己的"文档型抗风险"。写在应急预案里好看,应付检查能用,真出事了就是一堆废铁。
还有更可笑的,我见过一家公司,花了几百万买了顶级的灾备服务器,结果整个系统的核心域名解析只挂在一个服务商的单节点上。最后就是域名解析崩了,你灾备服务器再好,用户也找不到啊。
说白了,抗风险技术设计,从来不是买设备堆预算,是给整个系统练"免疫力"。不是等出事了再爬起来补窟窿,是出事的时候,用户根本感觉不到异常。
 符合核心三原则的抗风险技术设计架构示意图
很多公司搞反了,为了保非核心功能的体验,把核心交易的资源都占了,最后全崩,损失更大。
 抗风险技术设计的新趋势,早就跳出技术本身了
说实话,现在的风险,早就不止技术层面的系统故障了。
前几年的芯片断供,去年的开源组件Log4j漏洞,上个月OpenAI的全球大宕机,这些风险,全都是跨领域的。你架构做的再好,供应链断了,大模型服务商挂了,你还是玩完。
所以现在的抗风险技术设计,早就延伸到了供应链层面。我最近接触的几个国字头的重点企业,现在要求所有自研系统,必须把第三方组件、第三方服务的风险纳入整体设计,每一个外部依赖都要有备用方案,能快速切换。用了开源组件,你得有自研替换的预案,用了公有云,你得多云部署,用了第三方大模型API,你得有本地微调的小模型随时能顶上去。
上个月OpenAI宕机那次,多少做ChatBot的公司直接服务全挂,就是没做这层设计。连个备选方案都没有,用户进来全是报错,留得住才怪。
不过话说回来,抗风险设计也不是追求零风险,那根本不现实,成本也扛不住。
你一个开个人工作室做自媒体的,犯得着花几十万做三地灾备吗?没必要对吧?抗风险设计是一笔经济账,你算清楚,哪些风险发生概率高、损失大,就先防哪些,在你能承受的成本范围内,把最大的坑填上就够了。
去年见过一家做SaaS的小公司,老板很清醒,算过账:运营商多线路冗余一年花八万,能挡住90%的断网风险,万一断网损失至少几十万,这个钱必须花。整个城市发生地震把机房全毁了的概率,万分之一都不到,花几百万搞第三个异地机房,没必要,有个异地备份就够了。
这才是明白人做的抗风险设计。
老陈后来跳去了一家新公司,上任第一件事,就是拉着团队排了三个月的演练计划,每个月做一次全链路灾备切换。第一次切换花了四十多分钟,第三次练完,十分钟就能切完,用户无感知。他说现在睡觉,手机关静音也踏实了。
风险这东西,你不找它,它未必不会找你。早点把该补的坑补上,比出事了再哭强多了。
很多人对抗风险技术设计的理解从根上错了
大部分公司做抗风险,走的都是两个极端。要么觉得我运气好,不可能出事,一分钱预算都不给。要么就是堆硬件,买最贵的双活设备,存一份异地备份,完事大吉,往那儿一扔好几年没人管。 哦对,去年《计算机学报》发过一篇针对国内120家互联网金融企业的灾备系统调研,结果扎心:超过六成的异地灾备系统,上一次全链路模拟切换,还是在项目验收的时候。验收完三五年,再也没人碰过。企业常见错误抗风险技术设计架构图
这种说白了,就是骗自己的"文档型抗风险"。写在应急预案里好看,应付检查能用,真出事了就是一堆废铁。
还有更可笑的,我见过一家公司,花了几百万买了顶级的灾备服务器,结果整个系统的核心域名解析只挂在一个服务商的单节点上。最后就是域名解析崩了,你灾备服务器再好,用户也找不到啊。
说白了,抗风险技术设计,从来不是买设备堆预算,是给整个系统练"免疫力"。不是等出事了再爬起来补窟窿,是出事的时候,用户根本感觉不到异常。
好的抗风险技术设计,核心就是三个原则
这么多年看了这么多案例,翻了不少最新的科研成果,我总结出来,靠谱的抗风险设计,核心就三点,没那么多玄乎的。 第一点就是最小依赖原则。任何一个模块,都别把身家性命绑在单一根绳子上。 现在很多创业公司图便宜,所有服务都放同一家公有云的同一个可用区,看起来省了不少钱,真遇到可用区断网,直接全盘皆输。去年我知道的一家生鲜电商,就因为这个错过618大促,直接把上半年利润亏没了。 第二点就是故障显性化原则。别躲着故障,要主动找故障。 现在国外的头部科技公司,早就把混沌工程常态化了,就是主动往运行的系统里扔故障,今天炸一个节点,明天断一条链路,天天练。去年清华大学软件学院的科研团队出过一份实证研究,数据很能说明问题:每月主动做故障注入演练的系统,重大故障发生率比从不主动演练的,低92%。 说白了,该爆的雷在你演练的时候爆了,总比给用户用的时候爆强吧? 第三点就是降级优先原则。真遇到搞不定的大故障,别想着什么都保住,先保核心。 比如电商平台,核心是交易支付,你先把这个保住,非核心的商品推荐、个性化首页、积分兑换这些,直接降级停了,用户能正常下单付钱就行,比什么都重要。符合核心三原则的抗风险技术设计架构示意图
很多公司搞反了,为了保非核心功能的体验,把核心交易的资源都占了,最后全崩,损失更大。
抗风险技术设计的新趋势,早就跳出技术本身了
抗风险技术设计的新趋势,早就跳出技术本身了
说实话,现在的风险,早就不止技术层面的系统故障了。
前几年的芯片断供,去年的开源组件Log4j漏洞,上个月OpenAI的全球大宕机,这些风险,全都是跨领域的。你架构做的再好,供应链断了,大模型服务商挂了,你还是玩完。
所以现在的抗风险技术设计,早就延伸到了供应链层面。我最近接触的几个国字头的重点企业,现在要求所有自研系统,必须把第三方组件、第三方服务的风险纳入整体设计,每一个外部依赖都要有备用方案,能快速切换。用了开源组件,你得有自研替换的预案,用了公有云,你得多云部署,用了第三方大模型API,你得有本地微调的小模型随时能顶上去。
上个月OpenAI宕机那次,多少做ChatBot的公司直接服务全挂,就是没做这层设计。连个备选方案都没有,用户进来全是报错,留得住才怪。
不过话说回来,抗风险设计也不是追求零风险,那根本不现实,成本也扛不住。
你一个开个人工作室做自媒体的,犯得着花几十万做三地灾备吗?没必要对吧?抗风险设计是一笔经济账,你算清楚,哪些风险发生概率高、损失大,就先防哪些,在你能承受的成本范围内,把最大的坑填上就够了。
去年见过一家做SaaS的小公司,老板很清醒,算过账:运营商多线路冗余一年花八万,能挡住90%的断网风险,万一断网损失至少几十万,这个钱必须花。整个城市发生地震把机房全毁了的概率,万分之一都不到,花几百万搞第三个异地机房,没必要,有个异地备份就够了。
这才是明白人做的抗风险设计。
老陈后来跳去了一家新公司,上任第一件事,就是拉着团队排了三个月的演练计划,每个月做一次全链路灾备切换。第一次切换花了四十多分钟,第三次练完,十分钟就能切完,用户无感知。他说现在睡觉,手机关静音也踏实了。
风险这东西,你不找它,它未必不会找你。早点把该补的坑补上,比出事了再哭强多了。